MUTE:消除智能体网络中的遗忘回声,上行通信成本最高缩减80%
When Unlearning Fails: Reliable Data Deletion under Post-Training in Agent Networks
在传统的联邦学习或大模型隐私保护研究中,“机器遗忘”(Machine Unlearning)通常被视作一项一次性的修正任务:用户发起数据删除请求,系统从存储中抹去对应样本,接着通过参数微调或逆向优化,将模型权重调整到“仿佛从未见过该数据”的状态。
ArXiv URL:https://arxiv.org/abs/2607.28829
然而,当大模型与具身智能体(Embodied Agents)结合,并置于持续自改进(Self-Improving)的联邦网络中时,这种经典的遗忘范式彻底失效了。在真实落地的边缘智能体网络中,中心服务器分发策略模型,各端侧机器人(如机械臂、自动驾驶车辆)执行任务并收集真实交互轨迹(Trajectories),经过验证后再汇总上传更新全局模型。这个“部署-探索-收集-再训练”的闭环,让数据之间产生了动态因果链。如果某条敏感数据在被请求删除前,已经通过策略模型影响了后续成百上千条交互轨迹的生成,单纯在模型侧剔除原始样本,真能保证遗忘干净吗?
答案是否定的。最新研究指出了这一严峻现实:在持续自改进的智能体网络中,被遗忘的数据会留下一种“影响回声”(Influence Echo)。随着网络继续自主运行与迭代,本应被删除的隐式行为会借由那些看似合法的保留数据“死灰复燃”。针对这一挑战,研究人员提出了名为 MUTE(Muting Unlearned Trajectories’ Echoes)的系统性解决方案,通过轻量级账本溯源、模型与数据联合遏制,以及长期行为审计机制,在物理边缘测试床上实现了低通信开销下的可靠数据擦除。
遗忘失效:被删数据如何在自改进闭环中“借尸还魂”
在典型的具身智能应用中,智能体收集数据的方式是由其当前策略(Policy)驱动的。假设某个客户端在第 $t$ 轮使用了包含敏感信息的数据集 $\mathcal{D}^\mathrm{f}$ 进行训练,全局模型在聚合后不可避免地带上了该数据的偏差。当边缘智能体在后续轮次中部署这一带偏的模型时,它们在物理或仿真环境中探索的状态分布、动作决策均已被改变。
这意味着,随后被记录下来并标记为“合法保留数据”($\mathcal{D}^\mathrm{r}$)的交互轨迹,实际上已经成为了敏感数据的下游载体。
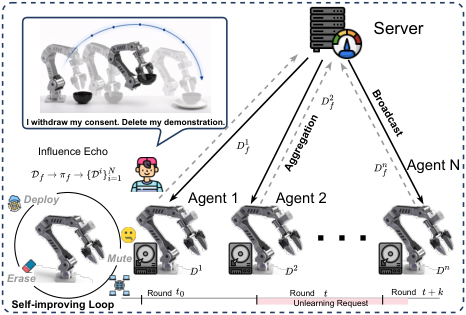
为了验证传统方法的局限,作者进行了一项严谨的基准测试:假设数据所有者发出删除请求,系统直接将原始敏感数据剔除,并在剩余的所有保留数据上“从头重新训练”(Retrain from scratch),随后让智能体网络继续自主交互演化。实验追踪了两个关键指标:
-
遗忘成功率(FSR, Forget Success Rate):衡量模型重现被删除行为的频率。
-
行为泄漏指数(BLI, Behavioral Leakage Index):通过行为成员推理攻击(MIA)的 ROC 曲线下面积(AUC)来评估,理想基线为随机猜测水平的 $0.5$。
如图 2 所示,在重新训练刚结束时,指标看似正常,但随着智能体网络在后续轮次中继续运行和自改进,FSR 与 BLI 均呈现出明显的上升趋势。无论是 MiniVLA 还是 $\pi_{0}$ 这类前沿的视觉-语言-动作(VLA)骨干网络,也无论删除粒度是单条轨迹、单个客户端还是整个任务,被遗忘的行为最终都重新复活了。重训练并未切断因果链,它只是暂时压制了表征。
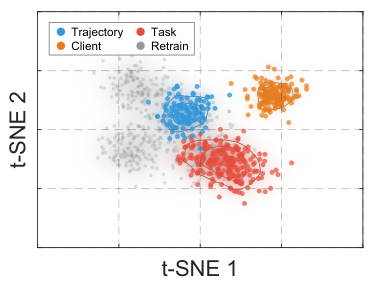
这种回声现象受什么控制?实验揭示了两个深层规律:
-
回声强度与影响比例正相关:如图 3a 所示,定义“影响比例”(Influence Fraction, IF)为受敏感策略塑造的保留数据占比。当 IF 为 0 时(数据完全外生独立收集),影响再生率(IRR)保持在零附近;而随着 IF 升高,IRR 迅速逼向 1。这证明了失效并非源自特定遗忘算法的缺陷,而是闭环自学习系统固有的动力学特征。
-
回声在表征空间中无法简单分离:如图 3b 的 t-SNE 流形所示,虽然客户端级别的受污染轨迹形成了一定聚类,但在更细粒度的轨迹和任务级别上,带有遗忘数据回声的样本与普通的干净样本完全混杂在一起。单纯依靠特征空间聚类无法甄别谁是“带毒”的下游数据。
MUTE 的核心机制:全生命周期的影响溯源与阻断
既然特征空间无法区分,那就必须回到网络的调度与聚合因果图。MUTE 的核心思想是:利用中心服务器已有的轻量化交互账本,自上而下计算每个样本的影响传播评分,进而协同执行“模型残余消除 + 数据侧隔离 + 跨轮次审计”。
1. 轻量化因果溯源(Influence Provenance)
传统的数据归因技术(Data Attribution)高度依赖每个样本的梯度计算或 Hessian 矩阵,在隐私敏感且资源受限的边缘网络中,中心服务器既拿不到原始轨迹,也承受不起高昂的计算负载。
MUTE 转向利用轻量级调度账本 $\mathcal{L}[t]$。在每一轮协同训练中,服务器天然记录了当前部署的模型版本、参与聚合的客户端集合、聚合权重 $\tilde{w}_{k}[t]$ 以及时间窗口。当收到遗忘请求时,服务器只需在离散时间步上重放该账本,迭代追踪模型层面的影响权重 $\gamma[t]$:
\[\gamma[t{+}1]=\bigl(1-\beta[t]\bigr)\gamma[t]+\beta[t]\sum_{k=1}^{N}\tilde{w}_{k}[t]\gamma_{k}^{\textrm{d}}[t]\]其中 $\beta[t]$ 与更新步长相关,$\gamma_{k}^{\textrm{d}}[t]$ 反映了该轮次本地数据的受污染先验。据此,当某个轨迹 $\mathbf{x}$ 在 $t_{\mathbf{x}}$ 轮由带偏模型交互生成时,其继承的影响评分可被标定为 $\gamma(\mathbf{x}) = \eta\,\gamma[t_{\mathbf{x}}]$,其中 $\eta$ 为策略形状校准因子。通过状态转移矩阵 $\mathbf{M}(\mathbf{a}[t])$,系统无需接触底层原始数据,即可精确掌握网络中影响回声的动态衰减过程。
2. 影响感知的双端消除(Influence-Aware Erasure)
定位影响后,系统采取双管齐下的方式:
- 模型侧目标擦除:通过联合构建遗忘损失与保留损失的正则化项,在参数空间快速清除当前残余:
-
数据侧动态隔离(Containment):这是阻断回声的关键。客户端根据分配到的轨迹评分 $\gamma(\mathbf{x})$ 进行分级过滤:
-
若 $\gamma(\mathbf{x}) \ge \tau^{\textrm{q}}$,则判定为高危载体,直接放入隔离区(Quarantine),从后续训练数据流中剔除;
-
若 $\tau^{\textrm{d}} \le \gamma(\mathbf{x}) < \tau^{\textrm{q}}$,则按照 $1-\gamma(\mathbf{x})$ 进行梯度降权使用;
-
低于阈值 $\tau^{\textrm{d}}$ 的样本正常参与训练。
-
需要强调的是,隔离并不等同于永久物理销毁。高危轨迹依然留存在客户端本地,只是暂时退出训练迭代;在边缘智能体有空闲计算周期(Duty Cycle)时,端侧会在已净化模型引导下重新采集替代轨迹,填补数据缺口。一旦后续模型验证该样本的影响分自然衰减至安全线以下,被隔离的数据还可被重新释放。
3. 跨轮次行为审计与通信预算调度
由于残余行为可能潜伏数轮后再次显现,MUTE 引入了连续轮次的行为审计机制。在满足网络上行通信预算(Uplink Budget)的前提下,构建带约束的优化问题,动态决策每一轮是进行常规聚合、数据隔离、下发审计探针还是追加消除操作,确保在长期演化中,行为泄漏指标 $\mathrm{BLI} \le 0.5 + \epsilon$ 且再生率 $\mathrm{IRR} \le \varrho$。
软硬件协同验证:从 LIBERO 仿真到 Jetson 物理机械臂
为了验证该机制的通用性,评估工作覆盖了两种最具代表性的具身智能架构:离散 Token 自回归生成的 MiniVLA(10 亿参数),以及基于连续流匹配(Flow Matching)的 $\pi_{0}$(30 亿参数)。任务套件采用了机器人操作标准基准 LIBERO,涵盖空间布局变换(Spatial)、物体变化(Object)、目标调整(Goal)以及长程多步骤任务(Long)。
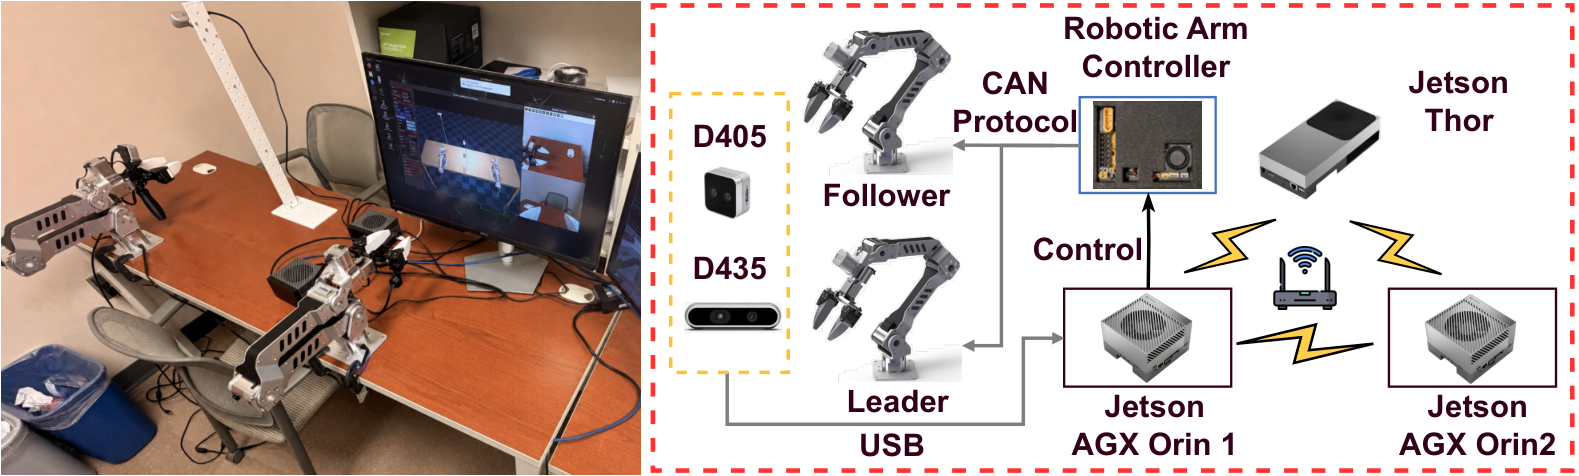
更为关键的是,研究团队不仅在多 GPU 仿真集群上完成了消融,还搭建了如图 4 所示的真实物理边缘测试床:由一台 Jetson Thor 充当中心联邦服务器,两台 Jetson AGX 嵌入式设备作为边缘客户端,通过真实局域网通信,时分复用控制真实的实体机械臂进行操作验证。
关键实验结果
对比“完全重新训练”(Retrain)这一理论上的隐私上限基准,MUTE 展现出了显著的综合优势:
在保持任务效能方面,MUTE 无论在 MiniVLA 还是 $\pi_{0}$ 上,任务成功率(SR)的下降幅度均严格控制在 $0.04$ 以内,基本保留了原有的操作泛化能力。
在隐私防护与抗回声方面,MUTE 在各粒度下均成功将 BLI 拉回到接近 $0.5$ 的随机几率水平,有效抵御了行为级成员推理攻击;同时在多轮持续自改进后,其影响再生率 IRR 显著低于重训练对照组,证明下游数据隔离策略有效阻断了行为复活。
在网络通信开销上,优势尤为突出。完全重训练要求整个联邦网络在全量数据上重放自改进流程,产生海量的梯度与适配器传输;而 MUTE 只需轻量化的账本交互与定点微调。在轨迹级删除场景中,MiniVLA 模型的上行通信量从重训练的 $234.6$ 骤降至 $54.0$;而在参数量更大的 $\pi_{0}$ 模型上,通信量更是从 $512.8$ 锐减至 $100.0$,上行传输成本最高缩减了超过 80%。
参数敏感度与工程权衡
参数扫描实验(图 5)进一步揭示了端侧部署时的工程权衡点:
-
隔离阈值 $\tau^{\textrm{q}}$:调高该阈值意味着采取更宽松的保留策略,IRR 和 BLI 会随之上升,但对于任务成功率 SR 影响极小,说明高危受污染样本即便被隔离,也不会实质性伤害整体任务技能库。
-
上行预算 $m$:增大分配给审计和净化的上行通信预算,可以单调降低行为再生与泄漏风险。
-
校准因子 $\eta$:在 $\eta=0.6$ 附近,系统在过度抑制与净化不足之间取得了最佳平衡点,形成了清晰的凹形最优解区间。
-
任务异质性 $\alpha$:Dirichlet 参数越小代表客户端间数据越非独立同分布(Non-IID),遗忘和遏制回声的难度也同步加大,符合分布式系统的客观规律。
结语
从“静态单次擦除”到“动态闭环遏制”,MUTE 揭示了具身智能与大模型网络中一个此前被长期忽略的问题:在策略驱动的数据采集机制下,数据从来不是孤立存在的,它们通过智能体的行为印记在未来数据中投射回声。
这项工作证明,面对持续自进化的 AI 智能体集群,仅仅关注参数侧的“手术刀式微调”是不够的,必须将数据产生的时间因果网纳入防御边界。MUTE 给出的轻量级账本溯源与数据隔离机制,不仅为机器人与边缘协同系统中的《通用数据保护条例》(GDPR)等“被遗忘权”合规提供了可落地的工程解法,也为未来持续学习系统的长期安全性设计提供了全新的系统视角。