ZhuLong:从静态盲猜到真机沙盒执行,EDA脚本Pass@1提升至78.5%
ZhuLong: Execution-Grounded LLM Agent for EDA Scripting with Offline API Self-Exploration
在芯片设计与电子设计自动化(EDA)领域,工程师日常需要编写海量脚本来操纵内存中的设计数据库、生成版图实例(Layout)、连结原理图(Schematic)以及查询网表(Netlist)。尽管通用大模型在写 Python、C++ 或前端代码时表现出色,但在面对商业 EDA 工具的自动化脚本时,往往瞬间失效。
ArXiv URL:https://arxiv.org/abs/2608.07925v1
究其原因,EDA 脚本依赖的 API 极其长尾、平台私有且极度缺乏公开文档。无论是华大九天的 PyAether 还是 Cadence Virtuoso 的 SKILL 语言,其底层往往包含由 C++ 绑定而来的严格类型约束和隐含上下文状态。更为关键的是,EDA 脚本的正确性无法通过静态语法分析来判断,它完全取决于实际设计环境中的可观察副作用。面对这类没有公开预训练语料、缺乏完整文档且重度依赖上下文状态的领域,单纯依靠检索增强生成(RAG)或静态一次性生成的大模型方案,准确率往往只有 20% 到 30% 左右。
针对这一工程痛点,长鑫存储(CXMT)与中国科学技术大学的研究团队提出了 ZhuLong(烛龙)。该系统取名自中国神话中“开目为昼”的神兽,旨在照亮原本晦涩不透明的商业 EDA API 生态。ZhuLong 是一个通过真机沙盒执行环境进行反馈校准的智能体(Execution-Grounded LLM Coding Agent),它打通了 API 检索、文档自探索与动态执行闭环。在首个针对商业 PyAether 脚本的真实基准测试 EDA-Eval-PyAether 上,ZhuLong 将代码生成的 Pass@1 从纯模型的 23.6% 和静态 RAG 的 32.3% 大幅提升到了 78.5%。
为什么大模型写不好 EDA 脚本?
在探讨 ZhuLong 的架构前,需要明确大模型在 EDA 脚本编写中面临的本质阻碍。芯片设计软件的脚本接口与常见的开源 Web 框架截然不同:
首先,这些 API 几乎不会出现在公网代码库中,属于典型的极端长尾知识。大模型预训练权重中包含的信息非常有限,容易产生严重的幻觉;其次,EDA 工具的接口文档普遍存在缺失或滞后。许多 API 的底层参数约束、返回类型或者错误条件根本没有文字记载,甚至有些方法强依赖于当前 GUI 窗口中是否激活了特定视图(AE GUI Context);第三,EDA 脚本必须通过执行副作用验证。一段看似语法完美的 Python 代码,可能在尝试写入版图层时引发底层 C++ 绑定的内部类型异常,这种运行时隐式契约在脱离沙盒环境时根本无法被大模型察觉。
目前学术界对于“大模型 + EDA”的探索大多集中在 Verilog 等硬件描述语言(HDL)的生成上,针对真实工业级 EDA 工具的脚本生成与闭环调试系统一直处于空白状态。
双轮驱动:统一 MCP 工具与离线反事实自探索
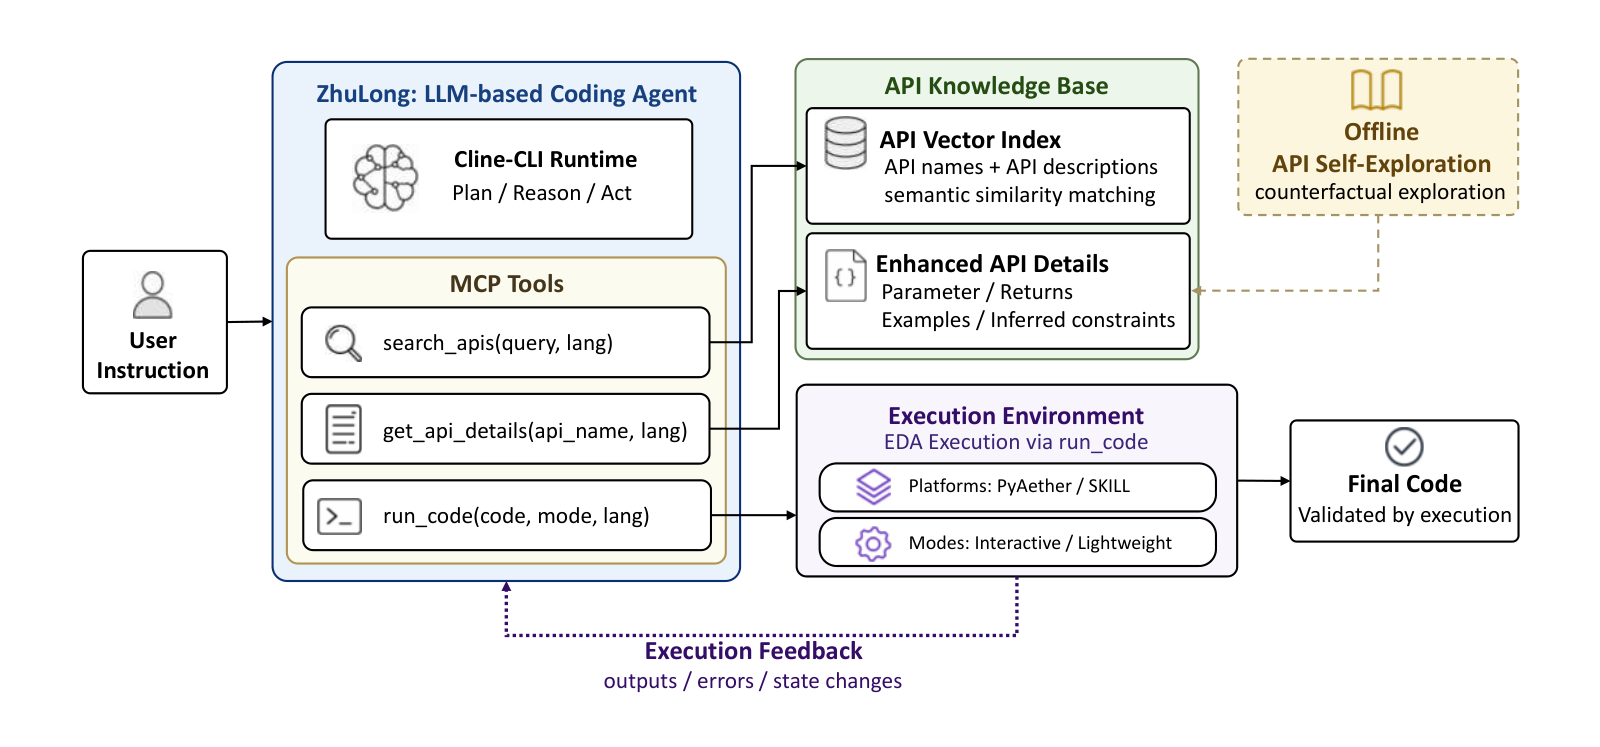
为了系统性解决不可见性与无反馈问题,ZhuLong 架构在 Cline-CLI 框架上进行了针对性扩展,构建了面向 EDA 领域的专用运行时。核心架构由大模型智能体运行时、API 知识库以及 EDA 执行环境三部分构成,其协同逻辑体现在两个关键设计中。
其一是通过模型上下文协议(Model Context Protocol, MCP)封装的三个核心工具:
-
search_apis:基于语义检索在增强知识库中召回候选 API; -
get_api_details:拉取包含强化细节的 API 文档规范; -
run_code(code, mode, lang):统一执行接口。该工具接收统一的语言参数(pyaether或skill),支持两种运行模式——在无 GUI 的独立沙盒中捕获标准输出、错误堆栈和状态变化的轻量级模式(Lightweight),以及通过 Socket 通信桥接直接操纵实时未保存版图与原理图的交互模式(Interactive)。
基于这三项工具,智能体形成了“推理 $\to$ 检索 $\to$ 编码 $\to$ 沙盒试跑 $\to$ 观察报错 $\to$ 重新规划并修正”的自修正闭环。在遇到未知报错时,智能体能够结合真实的执行栈信息重新理解问题,而不是在错误的假设上反复胡思乱想。
其二是在运行前引入的“离线 API 反事实自探索机制”(Offline API Self-Exploration)。既然官方文档存在大量参数约束、边界行为与返回结构缺失,ZhuLong 选择让智能体在离线状态下主动在沙盒中进行“试错式实验”。系统会为目标 API 自动构造反事实的输入参数、边界数据并捕获异常表现,从而主动推断出那些未被明文记载的内部隐式约束(例如某个入参到底要求标准的 Python 列表还是专有的 CStringList)。推断出的行为约束会被固化回 API 知识库,在正式运行时直接供智能体调用。这种单次离线探索、多次在线受益的设计,既填补了官方文档的漏洞,又不会在实际任务推理阶段带来额外的延迟开销。
真实基准 EDA-Eval-PyAether 下的实验验证
为了提供可量化的测量标准,研究团队构建了首个针对 PyAether 脚本的公开基准数据集 EDA-Eval-PyAether,包含 158 个真实世界任务。这批任务取材于 API 参考手册(61.4%)、官方示例(27.2%)、企业内部培训资料(7.6%)以及脱敏 CAD 实战案例(3.8%),涵盖数据查询、版图创建、原理图连线等多样化工业场景,均配备基于断言的真实验证代码。
在默认采用 DeepSeek-V4-Flash 作为底座模型、最多允许 2 轮重新规划(Re-planning)的标准评测下,消融实验揭示了各个模块的核心价值:
纯 LLM 直接生成的基线 Pass@1 仅有 23.6%,即便挂载了包含基础文档的静态 RAG,成功率也仅微调至 32.3%。然而,一旦引入沙盒执行反馈机制,整体成功率直接跳升至 75.3%(相比静态 RAG 绝对提升 43.0 个百分点)。而当进一步叠加上述离线自探索生成的增强文档后,完整版 ZhuLong 的 Pass@1 达到了 78.5%。
消融研究表明,沙盒执行反馈是决定系统性能的最关键支柱。一旦从 ZhuLong 中剥离沙盒执行(退化为纯静态生成),Pass@1 瞬间暴跌 41.2 个百分点,跌至 37.3%。这表明在充满暗语和长尾 API 的 EDA 领域,单纯的静态思考很难一步到位,来自沙盒的报错堆栈构成了搜索空间收敛的核心指引。
此外,离线反事实自探索机制不仅在完整形态下提供了额外的 3.2 个百分点增益,更显著优化了执行效率——平均每个任务的工具调用次数下降了 22.1%。在无沙盒执行的受限环境下,自探索机制带来的绝对提升更为显著(从 32.3% 到 37.3%,提升 5.0 个百分点),这说明预先探索并补充完整的 API 隐式规范,能够在源头上截断大量的低级调用尝试。
在检索策略方面,基于 API 名称与功能描述联合向量构建的语义检索,明显胜过传统的 grep 文本过滤(78.5% 对比 65.8%),反映出工程师自然语言需求与生硬 API 标识符之间的语义鸿沟必须依赖向量表征来弥合。在迭代预算测试中,系统在进行第 1 轮重新规划时便获得了绝大部分性能回补(从零重试的 62.7% 升至 76.0%),随后的第 2 轮微增至 78.5%,呈现出清晰的边际收益递减规律。
在底座模型的横向对比中,不同大模型的 EDA 脚本能力展现出显著分化。在接入完整 ZhuLong 体系后,Kimi-K2.6 取得了最高的 83.5% Pass@1,DeepSeek-V4-Pro 达到 81.0%,而 GLM-5.1 与 DeepSeek-V4-Flash 均录得 78.5%。部分底座模型如 DeepSeek-V3.2(67.1%)和 Doubao-Seed-2.0-Pro(55.7%)则表现落后。表现最高与最低之间 27.8 个百分点的断层说明,尽管沙盒和外部工具极其关键,底座模型本身的复杂上下文理解和规划能力依旧是基石;同时该榜单表现与通用代码评测并不完全重合,再次印证了 EDA 脚本对底层状态敏感性的严苛要求。
而在针对内存中未保存对象、窗口焦点切换等更严苛的 20 个动态交互场景任务中(无重试机会的单次执行模式),ZhuLong 在 PyAether 下取得了 60.0% 的 Pass@1,在 SKILL 语言环境下取得了 50.0% 的 Pass@1,证实了系统在真实跨平台 GUI 工作流中的可用性。
失败归因:大模型在 EDA 中还会犯什么错?
论文对 ZhuLong 最终未能攻克的 34 项失败案例进行了深入的白盒排查。其中 13 起为生成阶段失败,多由复杂多步骤任务消耗完上下文预算导致超时;剩下的 21 起执行阶段失败则具有高度的典型性,主要归结为两类:
一类是 API 误用(API Misuse)。大模型往往选对了功能接口族,却违背了底层由 C++ 导出的隐形契约。例如在 Task 074 中,模型传入了 Python 的原生 list,而底层绑定死板地要求特定数据封装类 CStringList;在 Task 114 中,模型调用了要求当前存在活动 GUI 窗口焦点的 aeCreateRect,而实际测试用例的环境应当使用直接基于底层句柄操作的 dbCrtRect(cv, ...)。这些未公开的契约在大模型仅凭字面猜测时极易踩雷。
另一类是 API 组合与工作流逻辑错误(API Composition Errors)。代码中的每一个 API 单独拿出来都是合法的,沙盒也不会抛出异常,但组合逻辑完全背离了测试断言。例如将题目强制要求的名称绝对相等判断误写成了字符串子串包含(in),或是调用了点集外扩函数 emyPointArrayShrinkGrow,而标准解法应当调用基于包围盒的专用扩展函数 dbExpandPoints。
这些具体的失败模式说明,后续针对工业级 EDA 智能体的演进,需要进一步引入感知类型的动态探针、更富语义的报错拦截网,并将人类专家排障沉淀的案例作为经验模块(Case-level Knowledge)纳入闭环,以实现长程自主演化。
总结
ZhuLong 的工程实践证明,在专业化极强、缺乏训练文本且强依赖状态反馈的深水区工业软件中,单纯依赖“提示工程 + 基础检索”已经难以形成生产力级别的突破。将大模型从被动的文本生成者转变为能够利用真实开发沙盒试错、验证、再规划的“实验者”,并通过离线反事实自探索弥补知识文档的固有缺陷,是推动 LLM 在芯片底层自动化工具链中实质落地的关键技术范式。