WorldExam:不仅看画质!20款视频世界模型评测揭示能力断层
WorldExam: Benchmarking World Models from Apparent Appearance to Inherent Reactivity
当视频生成模型纷纷标榜自己为“世界模型”时,行业对它们的评测标准却往往停留在两类极端:一类是看生成的画面够不够高清逼真、抽帧有没有明显的几何畸变;另一类则是看模型是否忠实执行了具体指令,比如让画面里的人“摔倒在沙发上”,便检查画面里最终是否出现了“摔倒”与“沙发”。
ArXiv URL:https://arxiv.org/abs/2608.02603
但真正的物理世界与虚拟仿真环境,其本质并不在于“听话地画出指定画面”,而在于它本身具备内在反应性(Inherent Reactivity)。在真实世界中,主体向上走,脚掌与身体高度会自动适配楼梯台阶;主体走向障碍物,不需要额外提示,世界也应该出现接触、阻挡、推挤或避让;当一个角色莽撞地冲向他人,旁观者会下意识后退。这些反应是场景状态推导出的自然因果,而不是在输入指令中一字一句写出来的脚本。
现有大多数基准测试,本质上都在评估“显式指令的达成度”。一旦把评测边界推向“在未明确交代后续后果的前提下,模型能否自发推演出环境该有的反应”,现存的视频模型到底算不算是合格的“物理世界模拟器”?
针对这一核心盲区,新基准 WorldExam 提出了从“表象外观(Apparent Appearance)”向“内在反应性(Inherent Reactivity)”跃升的四层诊断体系。该基准涵盖 1,474 个测试用例、八大专项任务,并在统一框架下对相机驱动、动作驱动和语言驱动三类主流范式的 20 款代表性视频世界模型进行了深入诊断。测试揭示了一个残酷的事实:当前所谓的视频世界模型存在显著的能力割裂,高画质与听话的表象之下,几乎没有模型能展现出真正稳健的内在物理与社交反应。
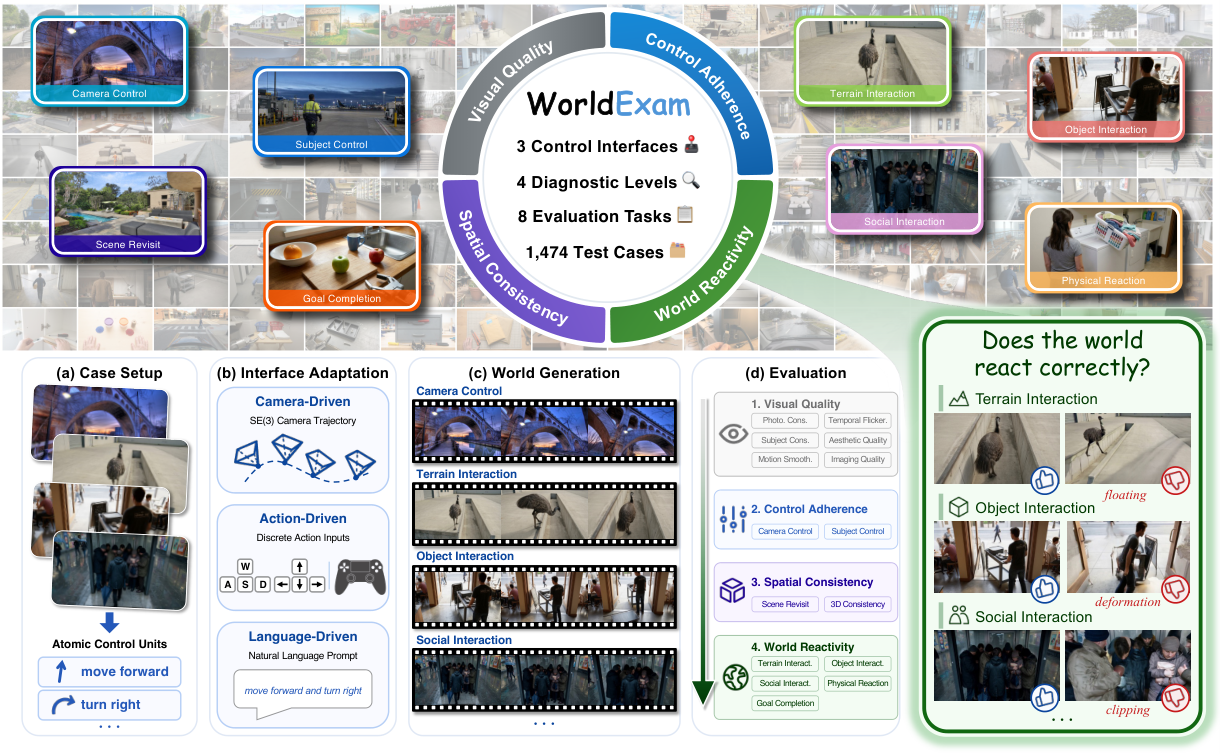
从听指令到测因果:为何需要“内在反应性”?
视频世界模型通常接收初始帧输入 $\mathcal{I}$ 和控制指令 $\mathcal{C}$,并预测未来的视频流 $\mathcal{V}$。指令的形式因模型而异:可能是相机运动的位姿序列、游戏手柄般的离散动作按键,或是自然语言 Prompt。
过去的研究在衡量这类模型时,常常将“指令依从度(Instruction Fulfillment)”与“物理仿真能力”混为一谈。例如,向模型输入“机器人推倒了积木,积木散落一地”,模型生成了积木倒下的画面。这只能证明模型理解了文本概念并完成了画图任务,却无法证明它具备“推”这一动作导致“受力倾倒”的因果直觉。如果只给模型输入“机器人以每秒两米的速度向前移动”,而积木恰好处在移动轨迹的正前方,模型是否会在输入完全未提及“碰撞”与“散落”的情况下,自发生成接触、受阻、倾覆与反作用力?
这正是 WorldExam 所界定的核心概念:内在反应性(Inherent Reactivity)。它衡量的是模型仅凭初始场景状态和基础控制输入,自主推断世界该如何响应并生成未被显式告知之后果的能力。
为了系统化解构这种能力,WorldExam 构建了一个自底向上的四层诊断金字塔:
-
视觉质量(Visual Quality):基础层,评估画面的感知合理性、时序稳定性和美学表现,属于传统的表象度量。
-
控制依从度(Control Adherence):评估受控相机或主体是否严谨执行了输入指令,如转向幅度与位移方向。
-
空间一致性(Spatial Consistency):评估模型是否具备场景持久性。在视角转出再转回的往返运动中,场景几何与物体状态是否发生幻觉漂移。
-
世界反应性(World Reactivity):最高层,在输入仅包含基础位移动作或高层目标的情况下,评估环境、物体、其他智能体及物理定律所展开的自发反应。
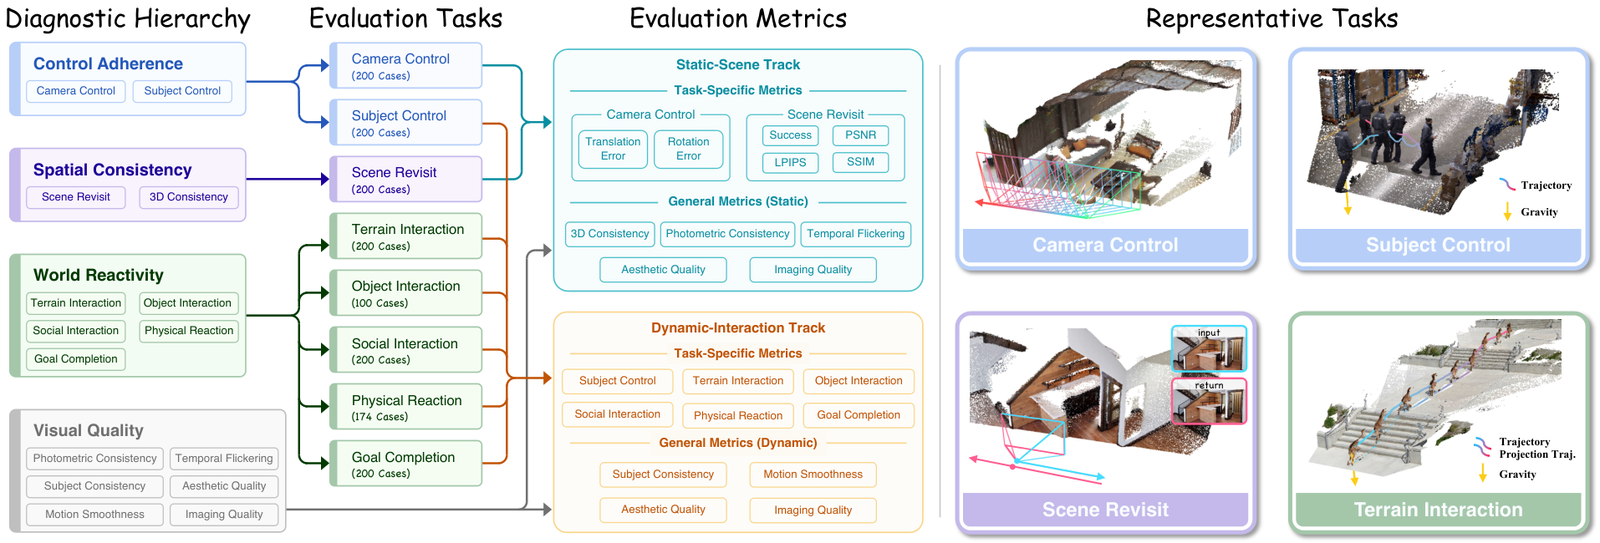
模块化解耦:八大任务与双赛道设计
异构控制接口一直是横跨不同视频生成模型横向对比的硬伤。相机驱动模型接收 $\mathrm{SE}(3)$ 相机轨迹,动作驱动模型接收诸如 ${W, S, A, D, \uparrow, \downarrow, \leftarrow, \rightarrow, \varnothing}$ 的离散按键,而通用视频大模型则依赖自然语言。
WorldExam 的设计思路是将控制行为拆解为原子控制单元(Atomic Control Units),并在统一语义下映射到各个模型的原生接口中。例如,“向前移动随后右转”这一复合行为,在相机模型中是一组时间加权的平移与旋转矩阵;在动作模型中是帧数锁定的按键序列;在语言模型中则转化为精准的自然语言动作分解描述。
这套体系在任务层被具象化为八个评测维度,并划分到两条互相独立的评估赛道中:
第一赛道:静态场景赛道(Static-Scene Track)
该赛道专注于相机控制与空间几何,适用于所有三类范式:
-
Camera Control(相机控制):测试 1 至 3 个原子运镜指令的复合执行度,严格量化平移与旋转轨迹误差。
-
Scene Revisit(场景重访):设计往返闭环轨迹(例如向左平移后再向右平移),考察相机回到原初视点后,画面几何结构、纹理与内容的保留程度,直击视频模型的“瞬间遗忘”软肋。
第二赛道:动态交互赛道(Dynamic-Interaction Track)
该赛道专门考察主体与环境的交互,排除了无法表达主体动态的纯相机驱动模型,只在动作驱动和语言驱动模型上展开:
-
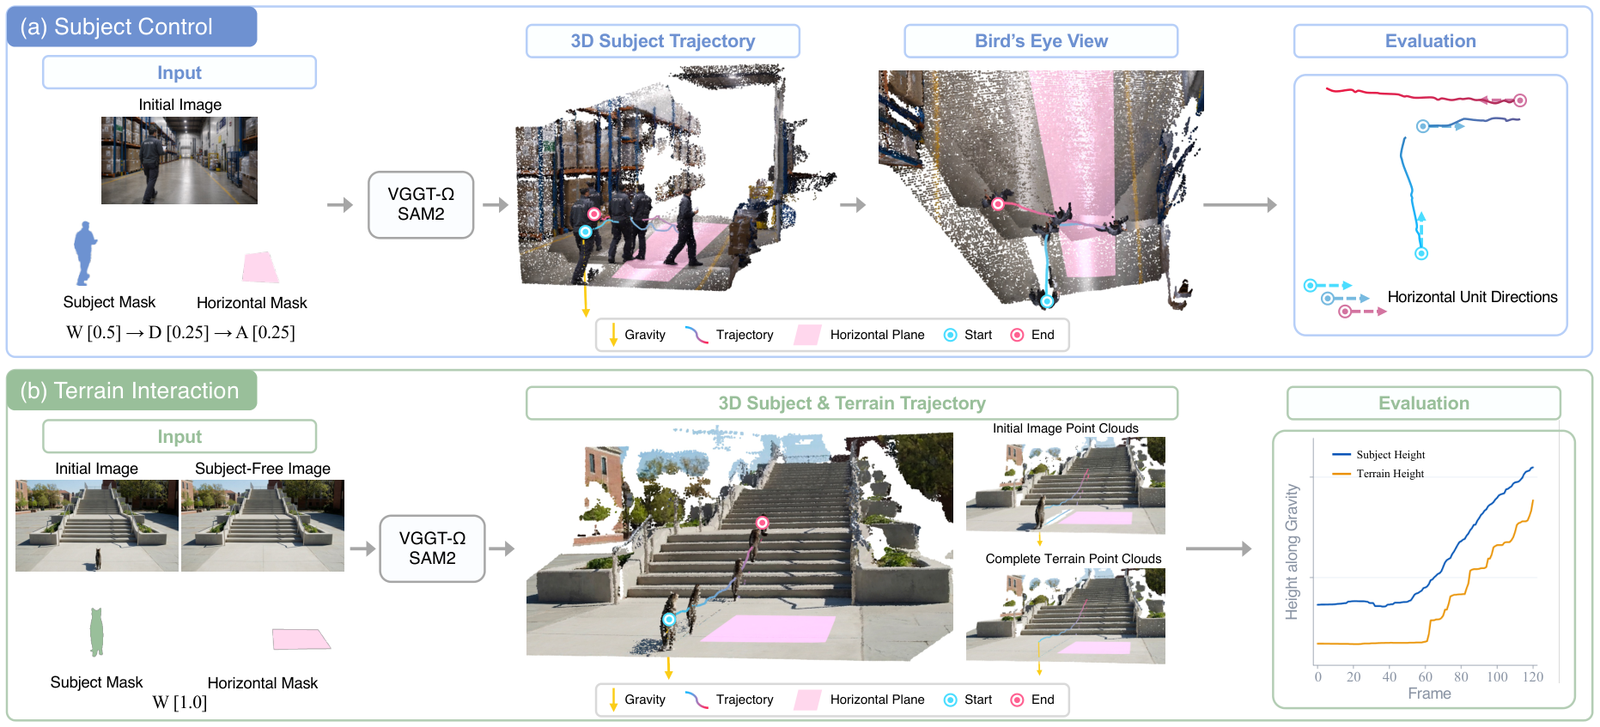
Subject Control(主体控制):测试指定主体对原子移动按键的执行准确率。
-
Terrain Interaction(地形交互):将楼梯、斜坡、桥梁或沟壑置于行进路线上,指令仅给定水平位移,模型必须自发推断出主体在重力下的垂直高度适配与脚部贴合。
-
Object Interaction(物体交互):行进路线上放置松散、柔性或刚性物体,测试接触瞬间是否引发符合材质特性的形变、移动或阻滞,而非直接发生视觉穿模(Interpenetration)。
-
Social Interaction(社交互动):让受控主体侵入其他实体的安全距离,测试非受控角色是否表现出符合常理的回避、驻足或让路。
-
Physical Reaction(物理反应):测试重力、摩擦力、动量传递、流体演变等客观物理过程的连续展开,甚至包含输入静止符号 $\varnothing$ 时的自主物理演化(如摆锤摆动、液体流动)。
-
Goal Completion(目标达成):纯语言驱动任务,仅提供高层目标(如“按高度从低到高排列三个螺栓”)与含干扰项的复杂初始场景,要求模型自主推理出动作顺序与执行步骤,而不是靠提示词手把手指导。
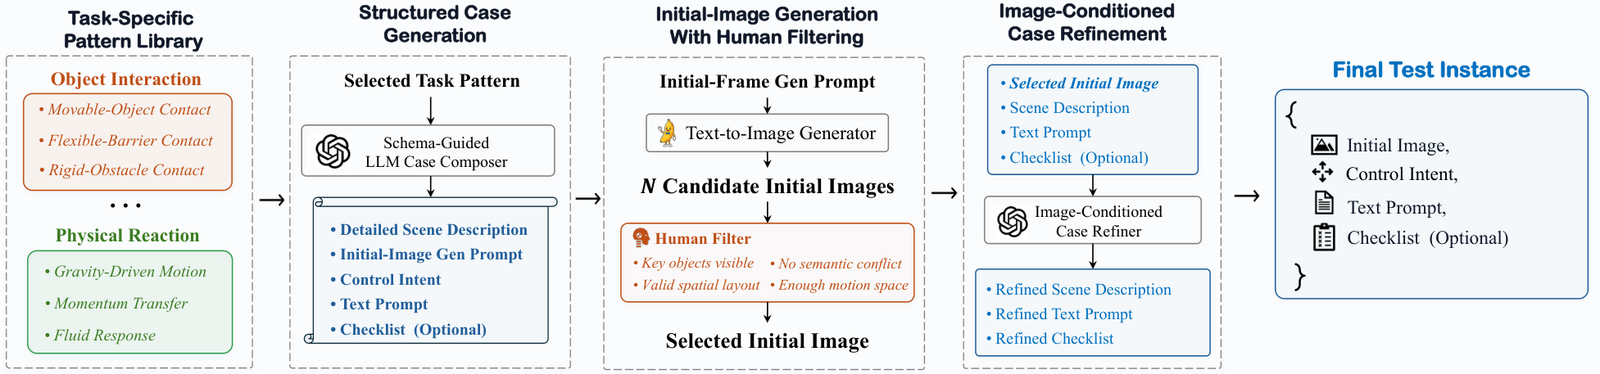
在用例构建管线上,WorldExam 绝非简单拼接随机提示词。针对六个涉及动态交互的任务,团队采用场景锚定流程:首先定义任务范式并生成结构化草案,随后合成候选初始帧并进行人工筛选;在最终确认图像后,结合图像细节反向精炼场景描述、控制 Prompt,并为后续评估构建专用的事实清单(Checklist)。这种“先有明确视觉场景,再落地控制与因果预期”的策略,确保了所有测试场景都不存在无解的物理悖论。
严谨的评测度量:3D 空间重建与语义清单
传统视频生成常使用 FVD 或 CLIP-Score 进行宏观打分,但这些指标在衡量物理因果与几何控制时几乎完全失效。为此,WorldExam 针对不同任务采取了深度与语义并行的度量方式。
对于相机控制、场景重访、主体控制与地形交互等偏重几何的任务,评测流程引入先进的 3D 几何重建模型(如 VGGT-$\Omega$),直接将模型生成的 2D 连续帧提升到 3D 空间中。
在相机控制中,直接对比重建位姿与目标参考轨迹:
\[e_{t}=\min_{s\geq 0}\frac{1}{T}\sum_{t=1}^{T}\left\|s\mathbf{t}_{t}-\mathbf{t}_{t}^{*}\right\|_{2},\qquad e_{r}=\frac{180}{\pi}\frac{1}{T}\sum_{t=1}^{T}\arccos\left(\frac{\operatorname{tr}\left(\mathbf{R}_{t}(\mathbf{R}_{t}^{*})^{\top}\right)-1}{2}\right)\]通过尺度自适应平移误差 $e_t$ 与旋转角度误差 $e_r$,精准捕捉模型是否存在运镜迟滞、超调或角度偏航。
在场景重访任务中,系统在回程窗口寻找与初始位姿欧氏距离最近的帧 $t_{\mathrm{rev}}$,并联合重访成功度指示因子 $S_{\mathrm{succ}}$ 与感知相似度指标(PSNR、LPIPS、SSIM),计算综合重访得分 $S_{\mathrm{rev}}$:
\[S_{\mathrm{rev}}=100\sqrt{S_{\mathrm{succ}}\cdot\frac{s_{\mathrm{P}}+s_{\mathrm{L}}+s_{\mathrm{S}}}{3}}\]一旦模型在相机回转后让原本的花瓶凭空消失、桌子换了朝向,或者干脆没有把视角转回原位,得分便会断崖式暴跌。
对于无法单纯用点云轨迹衡量的四个高层因果反应任务(物体、社交、物理、目标完成),WorldExam 则依赖定制的 Checklist 评估协议。每个测试用例均配有排他性的判断清单,覆盖“前置触发条件”、“合理的因果反应进展”与“必须杜绝的异常物理现象(如悬浮穿模、无故静止、提前突变)”。
评测模型(采用多模态大模型 GPT-5.5)抽取视频中均匀采样的 10 帧图像,对清单中的每一项进行严格的二值判定(Satisfied / Unsatisfied)。任何因生成模糊、穿帮、出幅或逻辑矛盾而无法验证的条目均计为失败。这一设计规避了开放式打分的打分膨胀(Prompt Injection / Sycophancy)问题,将模型对物理常识的理解压缩到了细颗粒度的规则判断中。
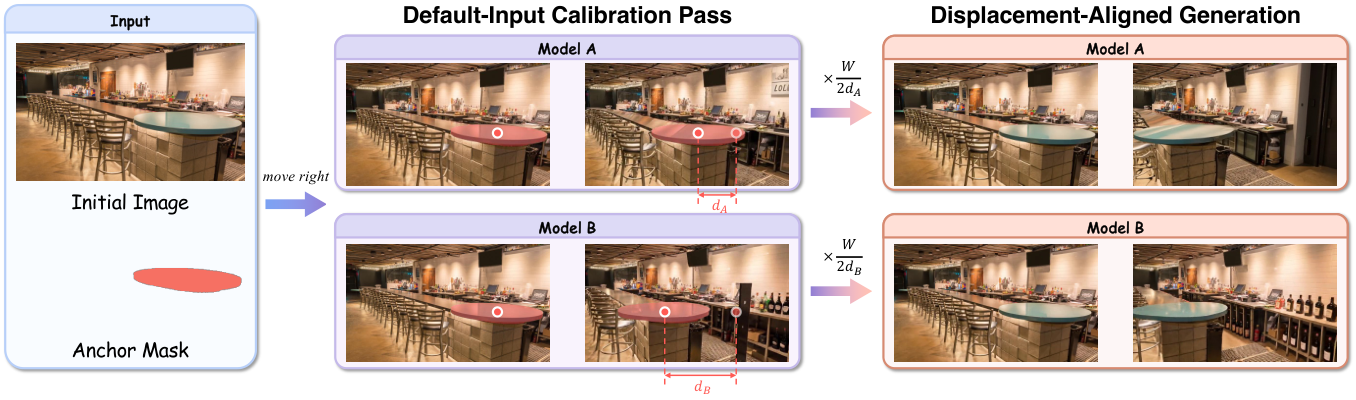
值得一提的是,评测流程还在相机驱动模型上实施了图像空间位移对齐。不同的相机驱动模型对同样的平移参数存在尺度感知差异,导致有些模型画面变动剧烈、有些仅微幅抖动。WorldExam 利用 SAM 2 追踪初始帧锚点的位移量,计算校准系数 $k_{m,c}$ 对输入平移向量进行归一化重整,消除了输入敏感度带来的评分不公。
20款模型实测:谁在裸泳?谁是合格的世界模型?
基于 WorldExam 包含的 1,474 个测试样例,研究团队系统评测了市面上 20 款代表性视频模型。这些模型被细致地划分为相机驱动、动作驱动和语言驱动三个阵营。
实验揭示的第一个关键结论是:三大驱动范式之间存在显著的“能力孤岛”与生态割裂,没有任何一个模型能在全任务图谱上实现兼顾。
相机驱动模型:精于运镜,止于交互
以 ReCamMaster、FantasyWorld 以及基于 3D 重建先验的 NeoVerse、InSpatio-World 为代表的模型,在静态场景赛道展现出了压倒性的统治力。它们能够忠实地还原复杂的推拉摇移,在 Camera Control 任务上的轨迹误差极低,重访初始视点时也能保持很高的几何一致性。
然而,这类模型的架构设计决定了它们只能控制“观测者视点”。它们的接口与内在表示不支持动态主体与环境交互。在现实需求走向具身智能和可交互仿真的当下,它们更像是“神经渲染摄像机”,而非真正意义上的交互式物理引擎。
动作驱动模型:按键精准,世界如顽石
以 WorldPlay、LingBot-World 等为代表的动作驱动模型,试图直接复现类似游戏引擎的操作体验。在 Subject Control 任务中,受控主体能够非常听话地响应按键指令,前后左右移动的动作响应干净利落。
然而,一旦进入 World Reactivity 评测层,问题便暴露无遗。当受控主体走上面前的楼梯时,模型往往不知道让角色自发抬腿抬高身体,而是粗暴地让主体贴着地面穿透台阶走过去;当推向面前的障碍物或迎面走向另一个 NPC 时,环境往往呈现出一种近乎“死亡”的冷漠反应——被撞击的箱子纹丝不动,对面的人像贴图一样对迫近的冲突毫无反应。它们学会了让主角“动”,却完全没有理解主角的动作会在所处世界中激起怎样的涟漪。
语言驱动模型:理解语义,丢失控制
主流的纯文本/图像提示视频大模型在交互自然度上表现更好。借助底模海量的多模态常识预训练,它们在 Object Interaction 和 Physical Reaction 任务上展现出相对较好的定性表现——如果让一个人走向椅子,椅子被撞歪或人自然绕行的概率显著高于动作模型。
但这种常识是以极其惨痛的代价换来的:模型几乎完全丧失了细粒度的精准时空控制。语言模型很难严格遵循“先前进三步、再右转两秒”这种严格的时序控制;面对复杂的往返 Scene Revisit,视角一旦移开,背后的场景便立刻在扩散去噪中被“重写”,空间记忆能力极其匮乏。
高画质与听指令,换不来真实的因果演化
综合整个评测结果,WorldExam 给出了一个极其明确的诊断性判断:极高的视觉保真度与精准的显式指令执行,根本无法保证模型具备内在反应性。
很多模型在单看生成的视频片段时令人惊艳——毛发丝滑、光影逼真、动态甚至达到了影视级别。然而一旦剥离显式指令的保姆式引导,单纯观察模型自发推导的反应,就会发现画质与因果推断之间存在巨大的脱节。模型学会了生成“像是在发生交互的纹理”,却并没有建立起“接触必然伴随受力”、“空间具有不可穿透性”、“移动受重力地形约束”的底层世界模型认知。
这也正是为什么统一分数的综合榜单在评估世界模型时常常具有误导性。在过往的评测中,一家模型可能因为画质分拉满、简单运镜顺滑而拿到极高的综合排名,掩盖了其在物理交互上近乎空白的本质。WorldExam 采用分级诊断、双赛道汇报的设计,恰好刺破了这一层由高饱和度画面包裹的泡沫。
从生成工具走向物理基座
WorldExam 的价值,不仅在于给现有的 20 款代表性模型打出了详尽的体检报告,更在于它为未来视频世界模型的研究树立了一个极具辨识度的标杆。
如果视频生成的终极目标是为自动驾驶、具身智能机器人以及虚拟世界提供一个可用于学习、决策和泛化的模拟器,那么研究重心就必须从“如何渲染得更漂亮”和“如何完全顺从文本”,转移到“如何让模型感知场景并遵循未言明的自然律”。
未来的世界模型不仅要能控制视角移动,还要在主体踏上台阶时自然调整步伐,在小球落地时算出弹跳的高度与反作用,在智能体彼此靠近时展现合乎常理的社会性避让。从表象外观到内在反应性,不仅是评测维度的扩展,更是一次关于视频生成模型能否真正理解客观物理世界的本质考问。