SMRC-SD:别硬喂全轨迹!电子科大用状态匹配让成功率达86.5%
When Privileged Guidance Misaligns: State-Matched Routing and Contextualized Self-Distillation for Multi-Turn Agents
在大模型驱动的多轮智能体(Multi-Turn Agent)训练中,强化学习面临着一个普遍困境:环境给出的结果奖励(Outcome Reward)极其稀疏。智能体可能在网页上摸索了十几轮,或者在虚拟房间里翻箱倒柜走了几十步,最后只拿到一个冷冰冰的“成功”或“失败”。这种粗粒度的二元信号很难告诉模型,究竟是哪一步的试错出了问题,哪一步的纠错值得鼓励。
ArXiv URL:https://arxiv.org/abs/2608.05219v1
为了解决这一难题,业界发展出了“特权在策略自蒸馏”(Privileged On-Policy Distillation)机制。它的核心逻辑非常直接:让学生模型自主在环境中探索,同时引入一个参数同步的“教师模型”。在训练阶段,教师模型享有特权信息——比如能够直接阅读一条已经验证过的完整成功轨迹。在学生探索的每一步,教师模型结合成功轨迹为学生当前生成的动作重新评估打分(Re-scoring),从而在密集的 Token 级别上提供细粒度的指导。
这种看似完美的机制在多轮交互任务中却频频遭遇瓶颈。电子科技大学的研究团队在最新论文中揭示了一个关键缺陷:无差别地向教师模型投喂完整的成功轨迹,反而会造成严重的“状态-参考失配”(State–Reference Mismatch)。当学生在探索中走出了与参考轨迹不同的分支时,照本宣科的教师会把合理的应对动作误判为错误,导致策略更新严重变形。为此,研究团队提出了 SMRC-SD(State-Matched Routing and Contextualized Self-Distillation),通过显式检验执行状态的一致性,决定何时该蒸馏、如何组织上下文。在 Qwen3-1.7B 模型上,该方法将具身交互环境 ALFWorld 的成功率从 0.746 提升至 0.865,在电商检索环境 WebShop 上也从 0.574 提升至 0.693。
为什么正确的经验会变成“有害的指导”?
要理解 SMRC-SD 的必要性,必须先剖析多轮交互中一个被长期忽视的事实:动作的有效性完全取决于它发生的物理或执行状态(Execution State),而不是任务的宏观目标。
在单轮问答或纯文本任务中,上下文是静态的,一条高质量的参考答案往往在语义上具有普适性。但在具身操作、工具调用或网页浏览等多轮交互中,环境状态在每一轮都在发生不可逆的动态演化。智能体当前所在的坐标、背包里的道具、浏览器当前打开的页面、甚至某些前置子目标的完成次序,都构成了独一无二的局部状态。一条成功的参考轨迹,本质上只是一条特定状态转移序列,它的每一步动作,都严格绑定在该动作发生前的那一个具体状态上。
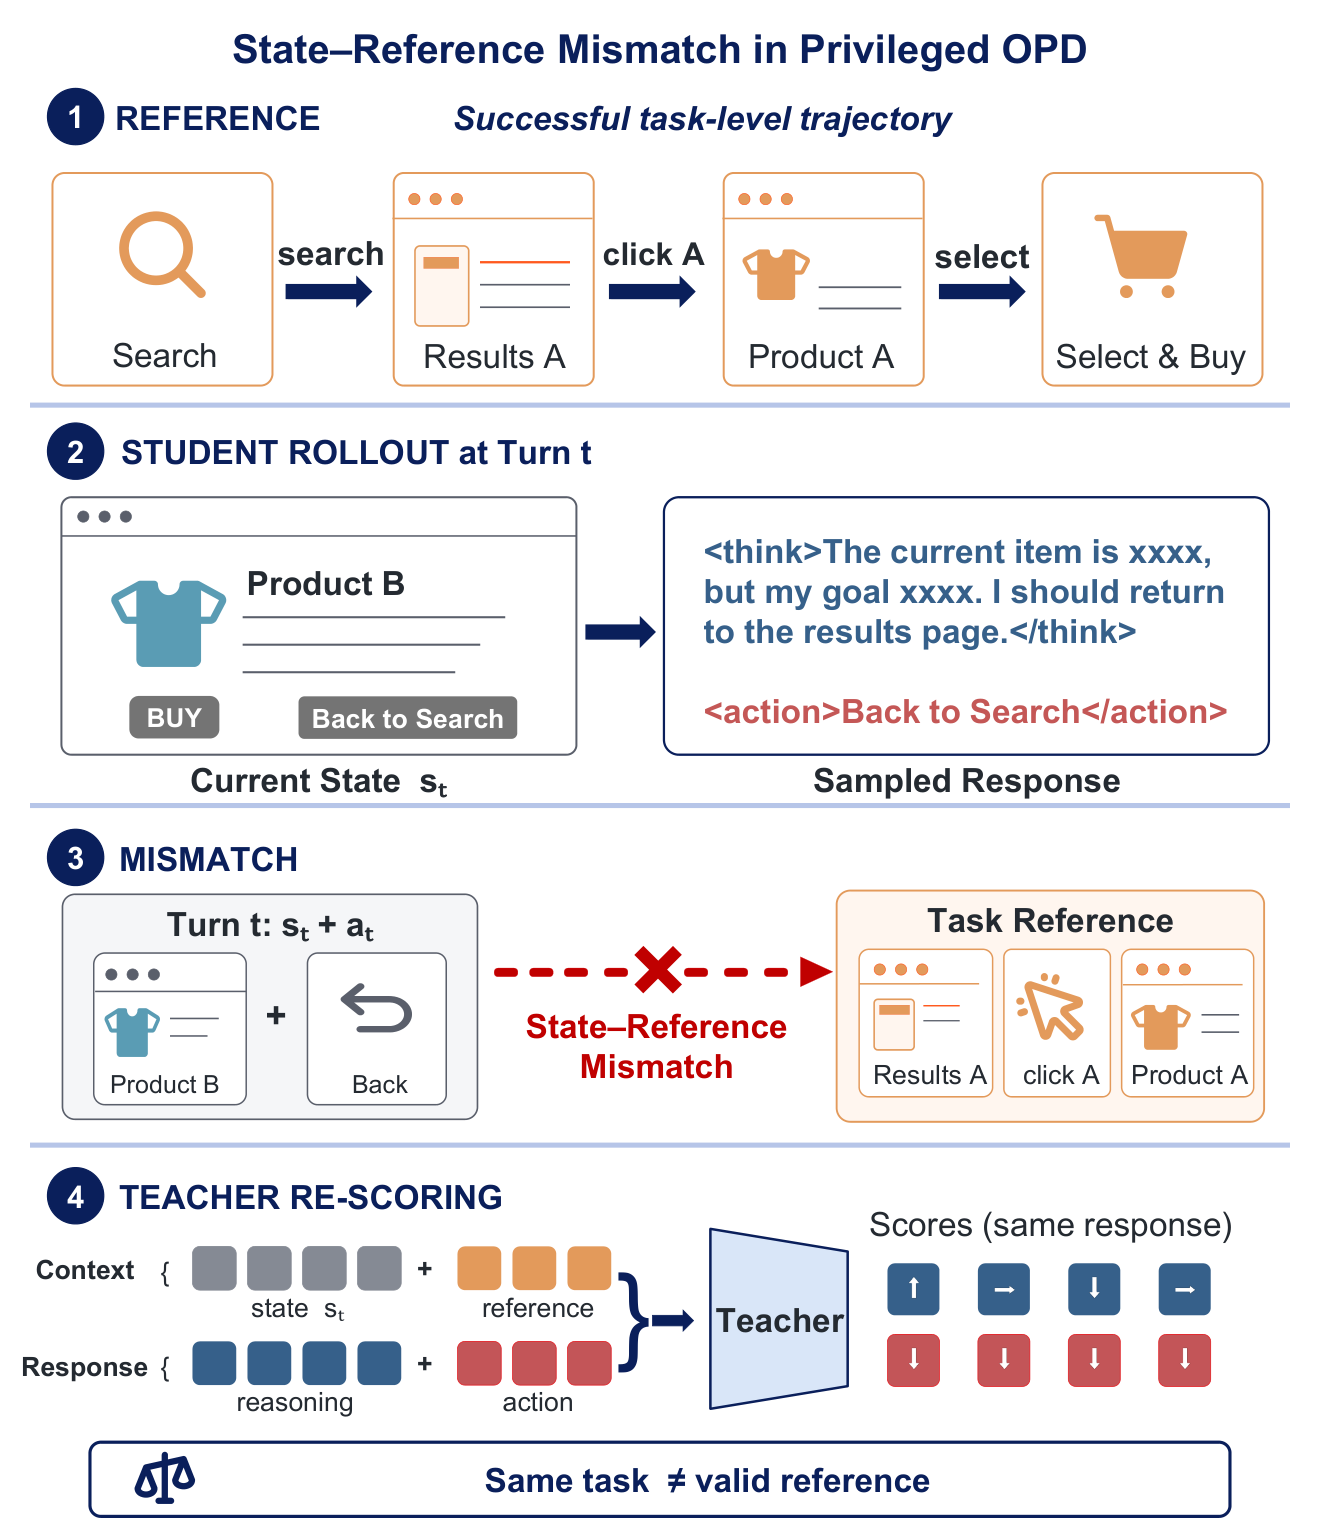
上图清晰地还原了这一灾难性失配的发生过程。假设任务是在电商平台寻找并购买某种特定的商品。参考轨迹(Reference Trajectory)的走法是在搜索结果页(Results A)中直接找到了目标商品 A,下一步动作是点击进入“商品 A 详情页”。而在实际训练中,学生模型在在策略(On-Policy)探索时点偏了,进入了无关的“商品 B 详情页”。面对这一意外偏差,学生模型采样出了一个极其合理、符合常识的恢复动作——“返回搜索结果”(Back to Search)。
在传统无条件全路径蒸馏(FullPath-SD)的设置下,教师模型在每一步都被强行塞入那条完整的成功轨迹。此时,教师模型看到的是成功买到商品 A 的全流程,并以此为基准给学生当前的动作打分。由于成功轨迹里根本没有“商品 B 详情页”,教师模型在被参考轨迹“先入为主”误导后,会认为当前最正确的动作应该是“在搜索页点击商品 A”相关的 Token,进而严重打压学生模型刚刚生成的“返回搜索结果”概率。
这就造成了一个荒谬的局面:学生做出了环境当前状态下完全正确的自愈与回退动作,却被手握“标准答案”的教师模型判定为低分并加以惩罚。一旦学生走出了不同于成功轨迹的分支,或者以不同的顺序完成了前置子任务,完整参考轨迹提供的信息就从“神助攻”变成了“毒奶”。
SMRC-SD:状态匹配路由与情境化自蒸馏
既然问题出在“状态对不上却硬要指导”,解决方案的核心就是重新定义特权经验的调用边界。电子科技大学团队提出的 SMRC-SD 不再把成功轨迹当成不可分割的文本长程提示,而是将其视为一个由状态索引构成的离散经验库。该框架由两个协同模块组成:负责判断“要不要蒸馏”的状态匹配路由,以及负责处理“如何提供指导”的情境化教师上下文构建。
状态匹配路由(State-Matched Routing)在智能体交互的每一个时间步 $t$ 发挥把关作用。模型首先提取学生当前实际到达的执行状态,并检测该状态是否存在于参考轨迹所经历的状态集合中。这种匹配并不要求学生此前的历史动作轨迹与参考轨迹一模一样,而是聚焦于底层的真实物理或环境状态是否等价。如果学生当前的状态在参考轨迹中找不到任何兼容的支持点(Supported State),路由机制就会果断切断蒸馏通道。
在被路由过滤掉的时间步中,该步的蒸馏损失权重被直接置零,不产生任何参考条件下的蒸馏梯度。这意味着智能体在完全陌生的偏离状态下,完全依赖常规的在策略强化学习目标(如 GRPO)进行无偏探索与自主反思,从而规避了被不匹配经验带偏的风险。
一旦状态匹配成功,系统才会激活第二阶段:情境化自蒸馏(Contextualized Self-Distillation)。此时,SMRC-SD 依然拒绝将整条成功轨迹丢给教师。既然已经定位到了参考轨迹中匹配的具体状态节点,系统便只截取该节点之后的兼容延续动作(Compatible Continuation),并将其与当前到达状态的精简摘要结合,组装成紧凑、局部对齐的教师上下文 $c_t$。
通过这种方式,教师模型看到的信息不再是与当下环境脱节的“平行时空”,而是从当前真实状态出发、可执行且符合因果律的后续解法。教师模型基于该上下文对学生响应重新评估输出分布 $\pi_{\bar{\theta}}(y_t \mid x_t, c_t)$,再与学生的基准策略分布 $\pi_\theta(y_t \mid x_t)$ 计算散度损失。
整个系统的联合优化目标可以精炼地表述为带有选择性加权的复合损失:
\[\mathcal{L} = \mathcal{L}_{\mathrm{GRPO}} + \lambda_{\mathrm{SDL}} \frac{\sum_{t} w_t \ell_{\mathrm{K3},t}(c_t)}{\sum_{t,i} m^{\mathrm{resp}}_{t,i}}\]这里的损失设计展现了一个精妙的数学考量。公式的分母并没有像常规加权那样只针对被选中的步数进行局部归一化,而是除以整条轨迹所有响应 Token 的总数 $\sum_{t,i} m^{\mathrm{resp}}_{t,i}$。这种设计的实际效果是:当路由机制过滤掉不兼容的步数时,它是在直接降低特权蒸馏损失(SDL)在整个策略更新中的总体占比,而不是强行放大剩下匹配步数的梯度。这保证了在策略强化学习在未知状态下的探索自由度,让特权指导在真正可信的地方发挥精准作用。
实验评测:不仅是指标跃升,更是机制的胜利
为了验证 SMRC-SD 的有效性,研究团队选择了两个极具代表性的多轮复杂交互基准:模拟家庭物理交互的具身任务环境 ALFWorld,以及高度拟真的网络电商交互平台 WebShop。实验采用 Qwen3-1.7B 作为基座模型,重点与完全无条件的成功全路径自蒸馏(FullPath-SD)以及纯在策略强化学习基线展开严格对比。
实验数据表明,SMRC-SD 取得了显著的性能跃迁。在长程具身规划环境 ALFWorld 中,由于涉及开柜、清洗、加热、放置等多步复杂操作,状态极易发生漂移,传统 FullPath-SD 的任务成功率仅为 0.746,而 SMRC-SD 直接将其拉升至 0.865。在包含大量搜索、筛选、属性比对与跳转的 WebShop 环境中,状态分支更加繁杂,SMRC-SD 同样将成功率从 0.574 大幅提升至 0.693。
为了更透彻地说明性能增益到底来自哪里,研究团队进行了细致的对照消融实验。消融结果揭示了两个模块各自不可替代的价值:
-
仅加入状态匹配路由(过滤掉失配步骤,但匹配时仍给教师喂整条轨迹):模型在两个数据集上的表现均明显优于全盘硬喂的 FullPath-SD。这直接证明了“劣质的全局指导不如不指导”,在偏离状态下强行施加不兼容的参考是导致策略震荡与退化的罪魁祸首。
-
状态匹配路由与情境化截断同时生效(即完整的 SMRC-SD):性能在单纯路由的基础上进一步稳步攀升。这表明即便状态匹配上了,去除参考轨迹中早期的冗余历史、仅保留与当前状态紧密相关的后续行动片段,依然能有效降低教师模型的注意力涣散,提供更纯净的局部 Token 级梯度。
值得关注的是,SMRC-SD 带来的性能增益完全是在训练期完成的。在实际推理部署阶段,模型面对测试环境执行任务时,既不需要提取状态签名,也无需任何参考轨迹的介入,策略网络依然以最原始的输入输出形式独立运行。这种“训练期严密约束,推理期零额外开销”的特性,使该方法极具工程实用价值。
重新审视经验蒸馏:多轮 Agent 需要怎样的监督?
回顾近年来智能体领域的研究路线,从最初的纯离线模仿学习(Behavior Cloning),到在线强化学习(PPO、GRPO),再到引入外部经验的自蒸馏,学术界一直在平衡“探索的多样性”与“高质量监督的密度”。
在以往的认知中,许多研究者默认“只要给教师模型看的示范数据本身是成功且高质量的,蒸馏过程就总能带来正向收益”。SMRC-SD 的研究有力地打破了这种惯性思维。它用清晰的因果事实指出:一条在全局上完全成功的执行轨迹,如果脱离了产生它的具体状态依赖,放到局部看完全可能是一份错漏百出的“瞎指挥”。多轮交互的本质是动态马尔可夫决策过程,智能体在前几轮哪怕仅仅改变了一个子目标的达成次序,后续环境状态就已经完全重构。
SMRC-SD 给整个多轮 Agent 训练范式带来的核心启示在于,离线经验向在线探索的迁移,绝不能停留在文本层面的全量拼接。如何将整条静态的专家轨迹拆解为局部的、以状态为锚点的微小技能经验,并在探索策略偶然触碰到兼容状态时进行高精度“空投对接”,才是提升在策略蒸馏天花板的根本解法。随着开源基础模型在推理与规划能力上的不断演进,这种兼顾探索自由度与因果相容性的细粒度监督方法,正在为下一代长程可靠智能体的自我进化铺平道路。