AgentRelBench:单次审计漏检率高达84%,智能体越轨为何抓不住?
该团队构建了针对智能体可靠性度量的评测基准 AgentRelBench ,在企业运维仿真环境 EnterpriseOps-Gym 上对 6 个主流模型家族的 9 款代表性模型进行了多达 2,128 次独立运行测试。
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
该团队构建了针对智能体可靠性度量的评测基准 AgentRelBench ,在企业运维仿真环境 EnterpriseOps-Gym 上对 6 个主流模型家族的 9 款代表性模型进行了多达 2,128 次独立运行测试。
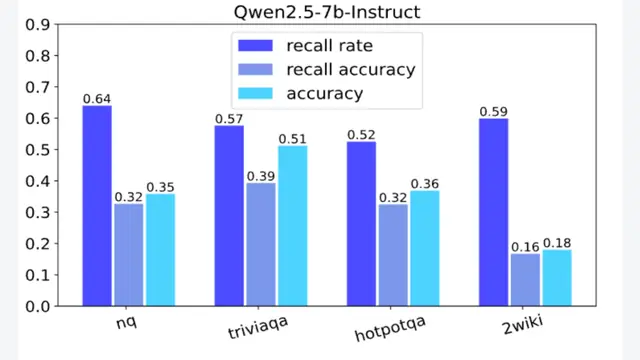
针对这一瓶颈,研究团队提出了一种轻量级的上下文提纯器(Context Refiner),并通过强化学习框架 CRRL 将动态提问提纯机制无缝融入 Agent 训练全流程,实现了在显著降低检索频次与上下文长度的同时,大幅...
针对这一核心痛点,香港科技大学与华为的研究团队提出了 InSight-doc 。该工作颠覆了以往默认必须把全量高分辨率图像一次性灌入模型的做法,将“视觉分辨率”重新定义为一种在推理阶段可被模型主动调度的计算资源。
凯斯西储大学(Case Western Reserve University)的研究团队提出了一种截然不同的解法: CoRe(Counterfactual Realignment,反事实重整) 。
东京理科大学团队提出的 GaussMemory 打破了这一僵局。该方案放弃了被动存储的死板逻辑,转向由任务驱动的“主动记忆”范式。论文的核心主张是:机器人不应该只是记录它看到了什么,而应该端到端地学会“如何去记”——自...
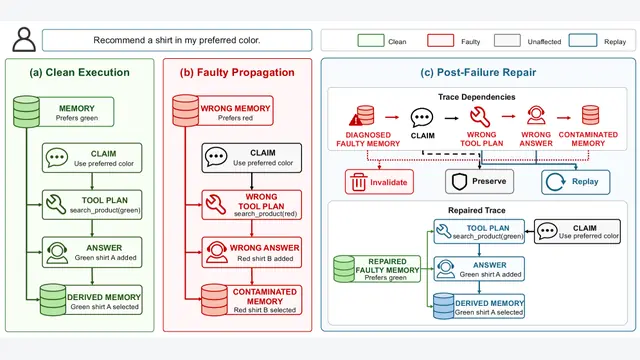
针对这一痛点,一项最新研究正式提出了 故障后记忆恢复 (Post-failure Memory Recovery)任务,并设计了一套 依赖引导的回滚修复 (Dependency-Guided Rollback Repa...
来自南洋理工大学、上海交通大学与 ACE Robotics 的联合团队提出了 ForeWAM (Foresight-without-Seeing WAM)。这项研究的核心结论是: 直接策略型的世界动作模型无需在部署阶段...
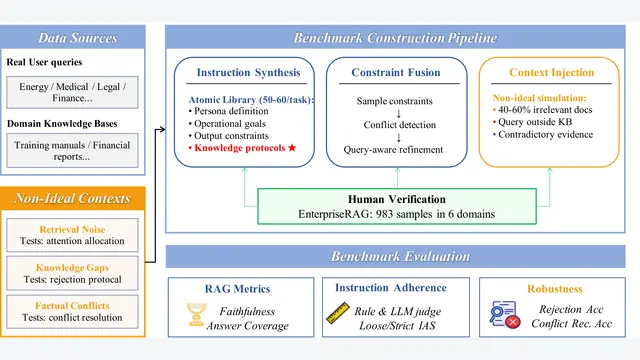
针对这一严重的工业落地痛点,中国移动等机构的研究团队提出了全新的基准测试集 EnterpriseRAG 。该项研究揭示了一个此前被传统基准广泛忽视的残酷事实:在真实的复杂约束条件下,主流大模型对单个指令约束的平均满足率...
DRNoise:为了排除检索框架与工具协议差异对实验结果的干扰,研究团队将所有参评模型置于完全相同的 BrowseComp-Plus 智能体框架内,采用标准的 ReAct(Reasoning + Acting)交互模式...
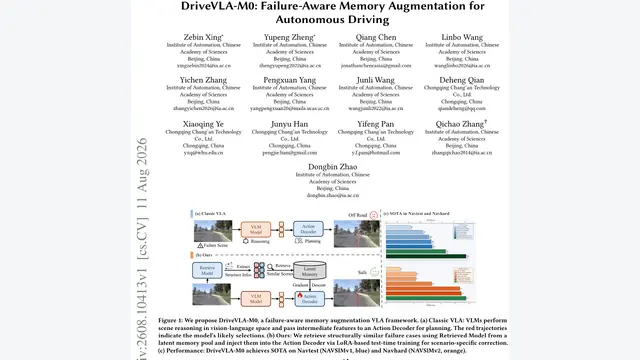
来自中国科学院与重庆长安科技的研究团队提出了 DriveVLA-M0 。这项工作不再试图通过无休止的离线全量重训来抹平所有长尾错误,而是开创性地为自动驾驶VLA系统构建了一套带有“失败感知”的结构化隐式记忆库与测试时自...
DeepMind:如果在前一到两轮,模型由于搜索空间过于宽泛而提出了边缘化、无信息增益的问题,其在后续轮次中自主“纠偏”的能力极其孱弱。早期恢复斜率分析证实,大部分开源与闭源模型在偏离正确依赖路径后,随着交互轮次增加,...
由微软研究院、英伟达、纽约大学、普林斯顿大学与耶鲁大学等机构联合提出的 Dion3,正是针对这一系列系统与算法痛点交出的全栈答案。Dion3 从底层硬件算子、数学算法重构、优化器更新机制到分布式通信策略进行了彻底改造,...
来自阿里巴巴与上海交通大学的研究团队提出了全新框架 (Compressed and Composable KV),通过解耦基座模型与缓存抽取过程,构建出一种既高倍压缩又具备“即插即用”拼装能力的 KV 缓存流形。
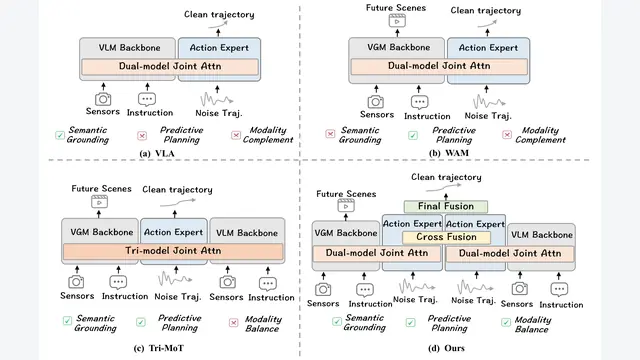
为了解决这一由于多模态注意力竞争导致的性能倒退,研究团队提出了 BrainWAM 。该框架受人类大脑左右半球分工与小脑协调机制的启发,放弃了在底层原始 Token 空间的暴力混合,转而在高维紧凑的“动作空间”中对语义先...
为了探索适合科研文献的专门记忆模式,研究团队在论文中提出了名为 Theoria 的三层记忆框架。科研人员阅读文献的过程通常是分层的:底层是具体的实证结果(Evidence),中间是由若干相似方法或流派形成的聚类群落(C...
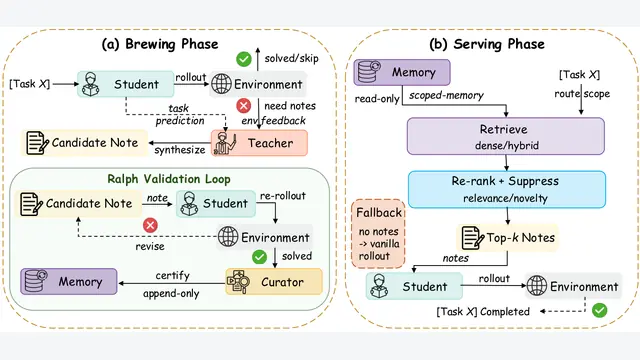
来自香港大学(The University of Hong Kong)的研究团队提出了名为 AgentBrew 的知识酿造框架,尝试从根本上重塑强教师与弱学生之间的经验传递逻辑。
此外,研究还开源了自动化归因工具 SkillTriage,并提出了一系列兼顾安全与成本的技能复用原则。评估智能体系统的失效历来存在归因难题。Agent 在复杂仓库和动态命令行中的交互轨迹充满不确定性,一个任务没有跑通,...
该团队联合推出了首个面向无人机多任务综合推理的评测基准 UAVQA-Bench ,并设计了一套免训练的航拍多智能体系统 UAV-MAS 。这套系统无需改动底层模型权重,仅依靠 Qwen3-VL-32B 开源底座,便在 ...
这篇题为《Zing: Social Mind for LLMs》的技术报告,系统性地提出了面向大模型“社交心智”(Social Mind)的完整工程与算法方案:代号为 知境 (Zing)的体系。
针对这一症结,来自北京大学、中国科学院大学与中关村实验室的研究团队提出了全新的评测基准 WorkSurface-Bench 。该工作将非结构化文档、结构化表格与文件关系图统称为“知识表面”(Surface),并在企业真...
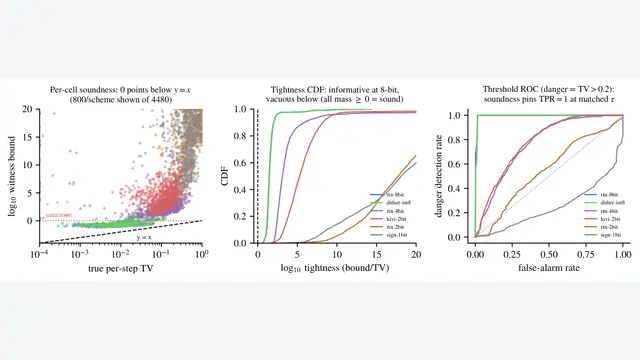
面对上述困境,WitCert 提出了极为精巧的几何分解方案,其理论核心建立在对 RoPE 结构的频域洞察之上。研究团队指出,RoPE 在数学本质上是一个关于频率对(Frequency Pairs)的分块对角正交变换。
来自中国科学院自动化研究所、北京大学、美团及伦敦大学学院的研究团队,在一项最新研究中提出了名为 UniMem 的自路由记忆框架。该框架受人类大脑互补学习系统(Complementary Learning Systems...
针对端侧 Agent 在算力成本、可靠性与云端协同之间的多重冲突,研究团队提出了名为 TSDS (Think Short, Defer Smart,意为“短思考、巧转交”)的协同框架。
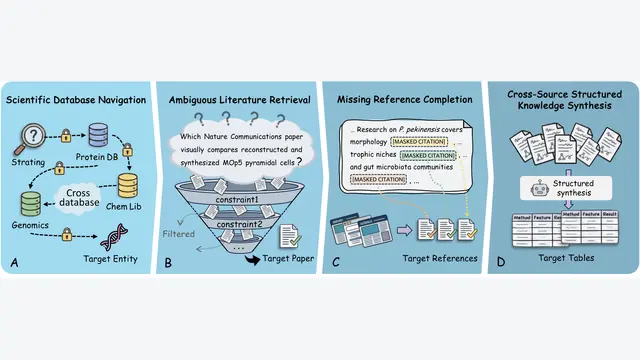
为了填补这一评测空白,最新研究提出了 SciExplore 。该基准将真实的科研信息搜寻抽象为一个渐进的认知阶梯,涵盖跨 10 多个学科的 103 项博士级深度任务,系统性评测大模型从最底层的实体推理到顶层的领域级结构...