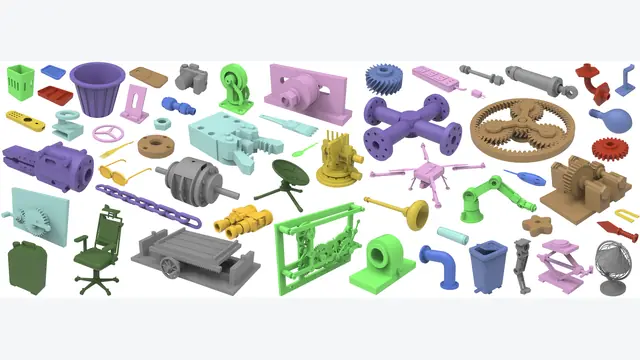
CADIR:跨软件可编辑中间表示,三大CAD环境节点重建率达100%
特别针对困扰业界的拓扑选择难题,CADIR 提出了结构化的语义选择器语法: {% raw %} {% endraw %} 该选择器通过显式指定目标类型 (点、边、面)、空间或几何参考原点 、邻接遍历算子 、几何谓词过滤...
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
特别针对困扰业界的拓扑选择难题,CADIR 提出了结构化的语义选择器语法: {% raw %} {% endraw %} 该选择器通过显式指定目标类型 (点、边、面)、空间或几何参考原点 、邻接遍历算子 、几何谓词过滤...
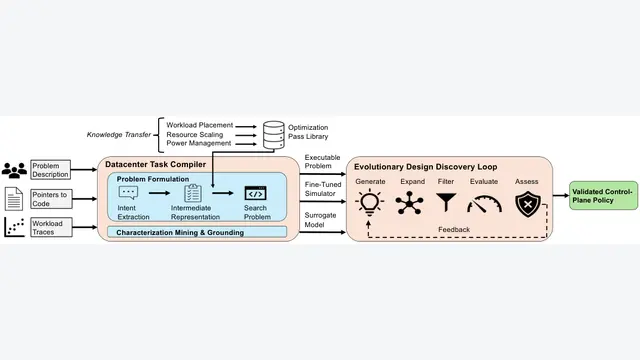
为了打破这一困局,研究人员提出了面向数据中心控制面策略生成的结构化框架 AtumAI 。该框架通过前端的“任务编译器”与后端的“演化设计发现循环”,将自然语言需求自动转化为具备严格约束保障的中间表示,并通过扩散模型、演...
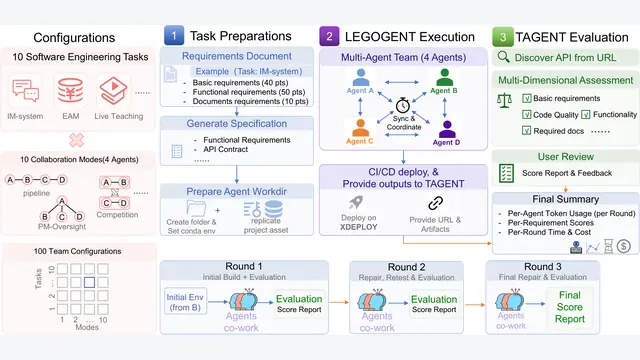
针对这一盲区,最新研究提出了多智能体从零代码构建评测基准 MSEval 。该基准将“协作拓扑(Coordination Topology)”提升为评测的核心自变量,在统一的项目需求、模型底座与自动化部署测试流水线下,系...
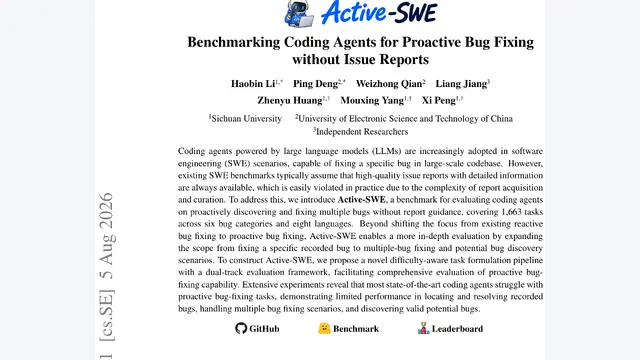
来自四川大学、电子科技大学等机构的研究团队提出了 Active-SWE ,这是首个系统评测 Coding Agent 在 脱离 Issue 报告前提下 进行“主动找 Bug 并修复”(Proactive Bug Fix...
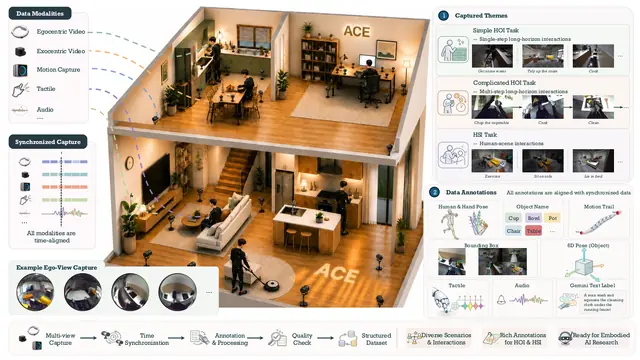
针对全维度物理交互数据的长期匮乏,最新提出的环境感知数据采集引擎 ACE (Ambient Capture Engine)及其衍生的大规模数据集 ACE-Data-0 尝试给出一套系统性的破局方案。
A/B Agent 的首要突破,在于打破了以往将 A/B 测试报告作为独立文档进行索引的粗暴做法,构建了一套 分层策略经验树 (Hierarchical Strategy Experience Tree)。在工业系统中...
针对这一长期困扰异构通信的核心冲突,研究团队提出了名为 XBridge 的免解码(Decode-free)通信协议。该方案将通信解构为离散实体锚点与连续上下文增强两个独立通道,在三大开源模型家族(Llama、Qwen、...
华为技术有限公司联合北京大学、东南大学提出了端到端智能体应急响应规划框架 STAIR(State-driven, Stage-specialized, and Experience-supported Incident...
这篇综述对当前 GUI Agent 的评测生态提出了极其犀利的批评:当前的论文看起来指标飞涨,但测试结论往往无法转化为真实可用性。最核心的问题在于 评测指标过度聚焦于单一的“任务成功率”(Task Success Ra...
为了破解这一痛点,浙江大学的研究者们提出了 SkillAligner 。它的核心观点非常清晰: 在 Agent 执行任务前,绝不能把检索到的外部技能当成不容置疑的硬性指令,而应当将其视作“可以随意修改的底稿”(Adap...
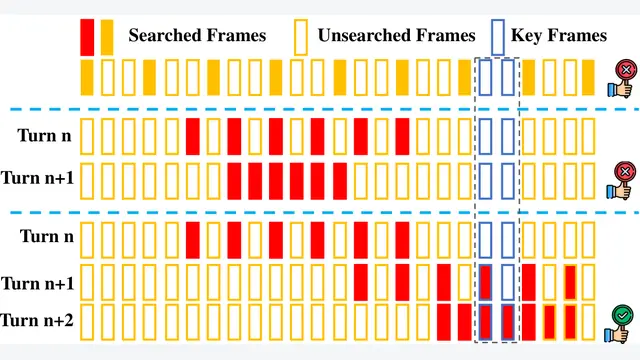
针对这一瓶颈,OPPO 联合深圳河套研究院、中山大学及香港中文大学(深圳)的研究团队提出了名为 SCOUT (Self-Checking Chain-Of-Tool-thought)的具备恢复感知能力的智能体框架。
针对这一症结,来自中国传媒大学媒体融合与传播国家重点实验室和智联英和技术团队提出了全新长程记忆框架 RippleMem 。该框架打破了传统记忆系统“单次孤立检索(Isolated Retrieval)”的思维定式,转而...
在大模型工程落地的世界里,训练后量化(Post-Training Quantization, PTQ)早已是事实上的行业标准。绝大多数团队在部署开源模型时,都默认 4-bit 权重属于“几乎无损”的安全区,3-bit ...
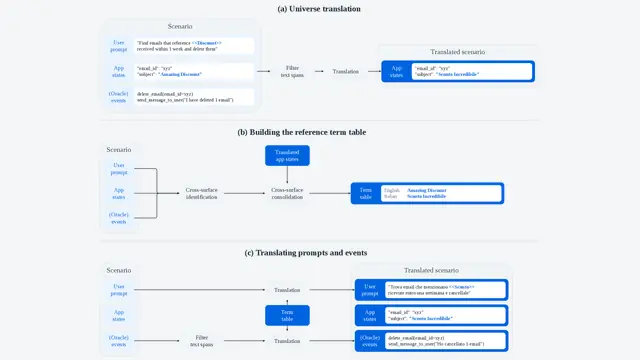
为了彻底厘清这一因果关系,Meta 团队提出了一套分层错误归因体系,结合自动化分类与人工语言学家的双重验证,对出现跨语言落差的场景样本进行了严格拆解。归因结果显示,这并非评测噪音主导的假象: - 55% 归因于纯粹的模...
MindMemOS 从根本上重构了记忆的表征形态,提出“实体–属性–时间”三维组织图谱,并配套开发了一套能够主动演化的算法引擎:在线通过紧凑检索与动态图融合吸收上下文,离线通过类似人类睡眠的“做梦(Dreaming)”...
基于此,研究团队提出了 RIFT ( Rollout-free Imagination via Future Tokens )框架。RIFT 彻底摒弃了测试阶段迭代式的视频去噪,仅通过引入一组可学习的“前瞻 Token...
为此,清华大学团队提出了一套全新检测框架,将隐性分歧的挖掘转化为 诊断性多项选择题生成 (Multiple-Choice Question Probing, MCQ Probing),并构建了基准数据集 IoA-Sui...
为了让视觉语言大模型(VLM)真正具备统揽全局的工业级规划能力,研究者提出了名为 Hugin 的全流程优化训练框架,并构建了涵盖四种工业真实布局的基准测试集 SortingBench 。实验结果表明,Hugin 在多个...
由 Scale AI 团队主导的最新研究提出了 HarnessOpt-Bench ,这是业内首个针对“端到端自动化 Harness 优化”建立的标准化评测基准。这项研究跳出了过去各家系统在自选题目、自定规则下的“自嗨式...
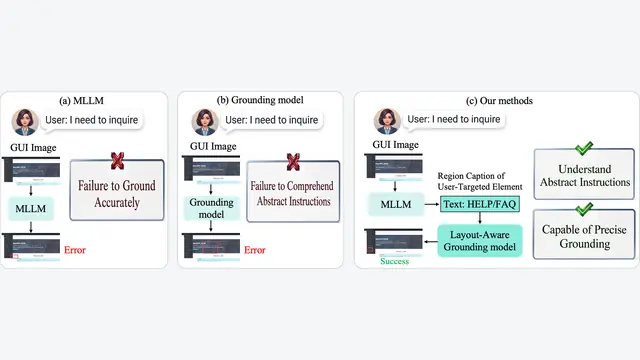
针对这一长期困扰界面的双重瓶颈,北京大学的研究团队提出了一种解耦的无回归布局感知匹配框架。该方法的核心思想非常明确: 大模型负责把复杂的自然语言指令“翻译”成富有界面布局细节的视觉描述,而精确定位则交给一个专用的轻量定...
团队提出了 GCPO(Geometrically Constrained Policy Optimization,几何约束策略优化) ,通过在参数空间施加严格的双侧正交硬约束,阻止强化学习梯度破坏预训练模型的关键流形结构。
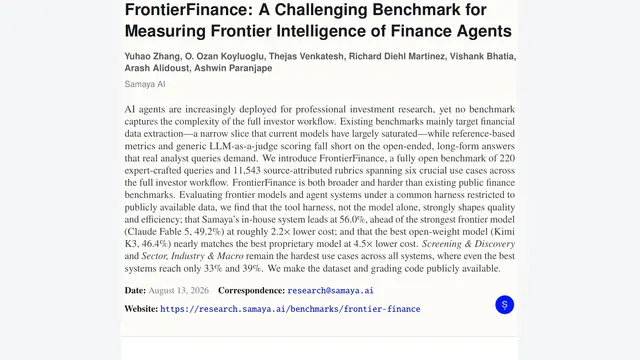
FrontierFinance:他们提出了“细粒度、源头可归因准则”(Source-Attributed Rubrics)评分机制。每一个复杂查询都被专业金融专家拆解为数个到数十个必须满足的事实判断准则,总计构成了 1...
来自中国科学院、西南大学和腾讯的研究团队在论文中提出了全新评测基准 ForestBench 。该方案跳出了大模型主观判分的窠臼,将异构的多智能体原生执行轨迹映射到统一的有向无环协作图(DAG)空间中,并提出了“参考森林...
针对这一核心瓶颈,来自复旦大学的研究团队提出了名为 FlowScout 的自动化生成框架。FlowScout 不再让大模型空想工作流,而是把工作流形式化为兼具语义推理与真实工具调用的有向无环图,并利用真实执行反馈指导蒙...