
牛津大学等提出GCTM-OT:结合LLM目标提示与最优传输重塑主题模型!
在海量文本数据中提取核心信息时,主题模型(TopicModeling)一直扮演着关键角色。从经典的隐狄利克雷分布(LDA)到近年来基于深度神经网络甚至大语言模型(LLM)的进阶方案,现有的主题建模方法在不断提升统计学意...
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
在海量文本数据中提取核心信息时,主题模型(TopicModeling)一直扮演着关键角色。从经典的隐狄利克雷分布(LDA)到近年来基于深度神经网络甚至大语言模型(LLM)的进阶方案,现有的主题建模方法在不断提升统计学意...

大型语言模型的落地部署正经历一场从追求极度规模到追求极致效率的范式转移。在这个过程中,低秩自适应(Low-RankAdaptation,即LoRA)凭借其极小的训练开销,几乎成为了参数高效微调(Parameter-Ef...

最近,强化学习(RL)在提升大型语言模型(LLM)复杂推理能力上的表现令人瞩目。特别是DeepSeekMath引入的组相对策略优化(GRPO)算法以及后续引发热潮的各类推理模型,证明了后训练(Post-training...

随着大语言模型(LLM)Agent在生产环境中的快速部署,一个反复出现的规律逐渐浮出水面:任务执行的可靠性,其实已经不再主要取决于底层的LLM模型能力,而是越来越依赖于包裹在模型外围的基础设施层——也就是所谓的“Age...

大型语言模型(LLMs)在处理复杂推理任务时,往往依赖于思维链(Chain-of-Thought,CoT)技术。通过让模型一步一步地用自然语言写出推理过程,其准确率确实得到了显著提升。然而,这里隐藏着一个根本性的效率错...

近年来,大型语言模型在软件工程(SoftwareEngineering,SWE)领域的表现,已成为衡量其真实世界推理与执行能力的核心试金石。然而,要训练出顶尖的编程智能体(Agent),往往受限于高质量代码工程任务数据...

随着大语言模型驱动的智能体(Agent)从执行简单的单次工具调用,逐步演进为能够自主执行复杂长周期任务的系统,Agent需要掌握的技能数量和种类正在急剧膨胀。为了在真实环境中有效运作,Agent必须从多种来源获取大量可...

当前,大语言模型(LLM)Agent的开发正从“手写Prompt”走向“组装技能库”的新阶段。开发者们为了让Agent能够执行特定的专业任务,往往不再从零开始编写代码,而是直接复用社区中已有的Agent技能(Skills)。

当前的大模型智能体(Agent)已经展现出令人惊叹的单点任务解决能力。面对复杂的指令,它们能够自主调用工具、反思错误,并通过与环境的不断交互找到破局之道。然而,这种成功往往是高度脆弱且孤立的。

随着大语言模型基础能力的飞跃,当前的AI智能体已经能够处理极长的上下文,熟练调用外部工具,并执行跨度极长的复杂任务。然而,当这些智能体被部署在真实的长期交互场景中时,它们不可避免地会遇到一个核心瓶颈:如何有效地记住并利...

在当今的大型语言模型和智能体系统研究中,如何让模型在复杂推理任务上表现得更好,已成为核心议题。无论是通过后训练(Post-training)让模型自我改进,还是在推理阶段(Inference)通过增加计算量来拉升性能上...

在大型推理模型的部署中,知识蒸馏(KnowledgeDistillation)是将数百亿参数模型的强大能力压缩至轻量级模型的核心手段。长期以来,离线策略(Off-policy)蒸馏占据主导地位,即让学生模型在教师模型预...

在大型语言模型的后训练(Post-training)阶段,如何将强大的闭源或超大参数模型(Teacher)的推理能力,高效地迁移到参数量较小的模型(Student)身上,一直是工业界和学术界死磕的核心命题。

大型语言模型正在从单一智能体的问答模式,向多智能体协同工作流快速演进。在这些系统中,多个智能体会进行交流、检索信息、对中间输出进行批判,并共同生成最终答复。虽然这种架构通过任务分解显著提升了系统处理复杂问题的鲁棒性,但...

当前,大语言模型的应用范式正在从单次对话向终身学习智能体(LifelongAgents)快速演进。为了应对复杂任务,这类智能体需要记住用户的偏好、迭代行动计划、积累工具使用经验,并在长周期的交互中保持敏捷的响应。然而,...

在深度学习尤其是大语言模型的训练中,优化器的设计直接决定了模型学习的效率与最终的性能上限。长期以来,AdamW等基于标量动量和方差调整的优化器占据了主导地位。然而,随着模型规模的爆炸式增长,研究人员开始将目光投向利用权...

在大语言模型(LLM)的后训练(Post-Training)阶段,强化学习(RL)已经成为提升模型特定领域能力的标准范式。无论是利用可验证奖励进行数学推理训练,还是在沙盒环境中进行代码能力的代理式强化学习,或者是基于规...

在多智能体大型语言模型(LLM)系统的部署中,开发者往往会面临一个棘手的现象:当多个专注于特定子任务的智能体协同工作时,系统输出经常会出现严重的幻觉。这种幻觉与单个模型能力不足所导致的胡言乱语不同,在很多情况下,每一个...
过去一年里,AI在科研领域的应用边界被不断拓宽,从文献检索到辅助实验,甚至是端到端的“AI科学家”框架,都展示了语言模型在科学工作流中的巨大潜力。然而,现有绝大多数自动化研究系统往往在精心挑选的示例、人类限定的主题、预...
测试时提示词学习(Test-timepromptlearning)为基础模型的部署后适配提供了一种轻量级机制。与传统的权重微调不同,这种方法通过更新提示词来应对新输入、分布偏移和失效模式,特别适合通过与环境交互来自我优...
当我们在生产环境中同时运行多个大型语言模型(LLM)智能体时,一个经典但致命的计算机科学问题正在以全新的形态复活:并发控制。无论是修复代码库、管理Kubernetes集群,还是协作编辑长文档,一旦多个智能体开始读取和修...
当大语言模型(LLM)作为智能体被组合成多智能体系统(Multi-AgentSystems)时,一个根本性的矛盾始终悬而未决:智能体之间的相互交流,究竟是会促使它们在观点和输出上趋于一致,还是会激发更多的多样性?
在过去几年中,模仿学习(ImitationLearning,IL)已经成为理解和训练大型语言模型(LLM)的核心范式。从最基础的指令微调(SFT)到更高级的模型对齐,我们都可以将其视为让一个学习者(模型)去模仿一个专家...
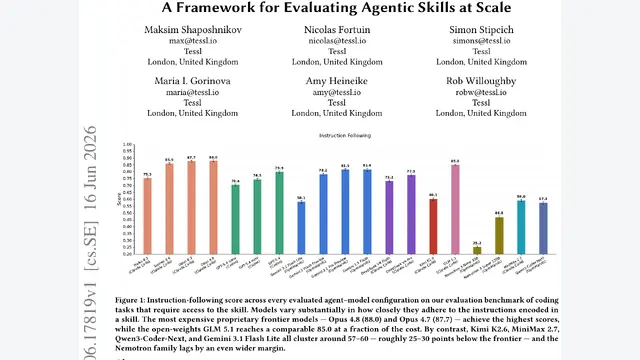
大语言模型(LLM)驱动的Agent正在迅速重塑软件开发、数据分析和复杂工作流的自动化方式。为了让通用模型能够胜任特定领域的复杂任务,行业内形成了一种标准的做法:为Agent注入“技能”(Skills)。