ACH:面包屑伪造互证链诱捕搜索Agent,攻击成功率达71.4%
研究提出的“权威链劫持”(Authority-Chain Hijack, ACH)策略,通过在智能体推进检索时动态投喂看似来自不同独立信源、实则彼此印证的协同证据,直接破解了智能体的多源交叉验证防线,在 SafeSea...
AI Agent推理
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
研究提出的“权威链劫持”(Authority-Chain Hijack, ACH)策略,通过在智能体推进检索时动态投喂看似来自不同独立信源、实则彼此印证的协同证据,直接破解了智能体的多源交叉验证防线,在 SafeSea...
BlueLM-GUI 提出了 MobileGUI-VBench 以及一套“配额驱动”(Quota-driven)的动态评测方法学。该方法彻底抛弃了“专家挑选一些主观难题组成固定测试集”的旧模式,将基准拆解为业务场景、任...
为了打破这一“能力天花板”,来自北京理工大学和深圳北理莫斯科大学的研究团队提出了一种全新的 零阶自进化框架 。该方法彻底跳出了“必须先采出正确轨迹才能训练”的传统思维,而是对大模型的 LoRA 参数施加微小扰动,仅依据...
研究团队提出的黑盒攻击框架 SkillClone 证明:哪怕底层文件被严密保护、不发生任何文本泄露,仅凭普通的任务交互与闭环差分修复,攻击者依然能以极低的成本重构出可独立执行的等价程序克隆。
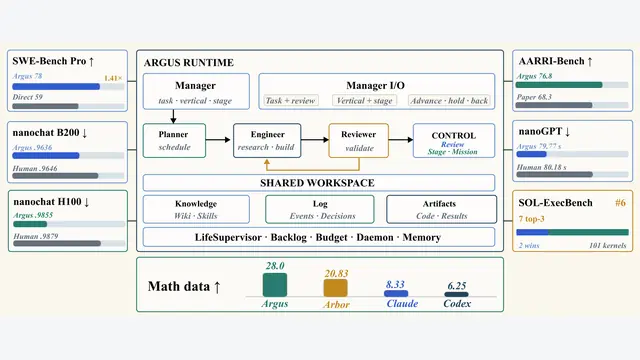
由微软、上海交通大学、清华大学、北京大学等机构联合提出的 Argus ,正是为了打破这一长期困境而设计的通用 Agent 运行时。Argus 的核心思想非常直接却极具颠覆性:长程推理的关键不在于更长地维持一个固定计划。
面对这种隐蔽而危险的群体性误导,传统的过滤门禁与只看讨论记录的法官模型几乎全线失效,而研究团队提出的“独立裁判(Referee)”机制,通过在会后向模型发起一次私下重质询(Private Re-query),以非介入式...
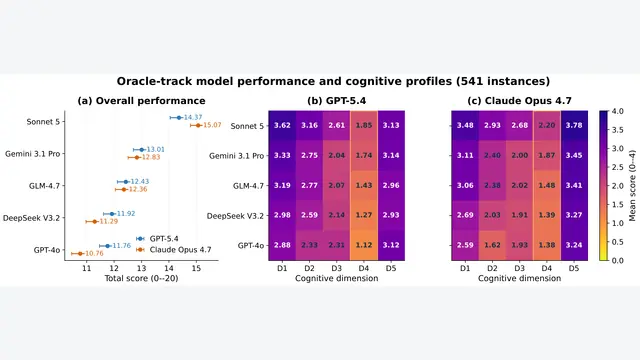
清华大学与蚂蚁集团的联合研究团队指出了现有记忆基准的这一结构性盲区,并提出了全新的评测基准 TANGLE (Testing Agents’ Navigation of Genuine, Latent, and Enta...
针对这一困境,来自北京邮电大学、哈尔滨工业大学、北京大学与腾讯的研究团队提出了 ToolHazard ——一个能够端到端、规模化合成可执行有状态对抗环境的自动化框架。
为了严格证明这一点,研究团队提出了名为 TextCall (只调用、不返回图像)的训练与评测机制:模型照常生成完整的工具调用脚手架(Scaffold),但在工具执行完毕后,系统完全不回传裁剪后的新图像,而是直接用一个固...
针对这一系列落地痛点,腾讯云与浙江大学的研究团队提出了名为 SkillEvo 的智能体技能自进化框架。研究的核心判断在于: 制约技能持续自进化的瓶颈,从来不是大语言模型的文本重写能力,也不是迭代轮数的多少,而是评估反馈...
来自微软研究院和东北大学的研究团队在最新论文中提出了一个跳出传统思路的解法: SHAPER 。该框架指出,现代具身智能体本质上是一个围绕基座模型构建的复杂系统,其执行表现不仅由模型权重决定,更受外部程序化指导(技能 S...
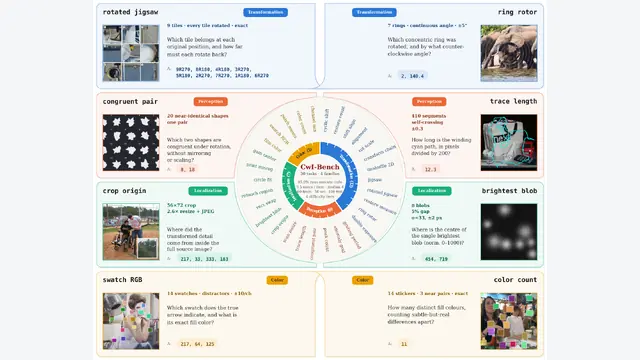
由诺基亚、香港理工大学以及佐治亚大学联合提出的 Code-with-Image 框架,彻底推翻了以往“工具提供视觉碎片、语言产出最终答案”的协作逻辑。研究团队给大模型配置了一个纯粹的 Python 解释器,没有任何预设...
针对这一矛盾,上海交通大学的研究团队提出了一种名为 ReTree 的自纠错树状工作记忆机制。ReTree 并没有将搜索历史简单视为线性文本流或单向压缩的草稿,而是将搜索过程建模为带有依赖演化关系的证据树。
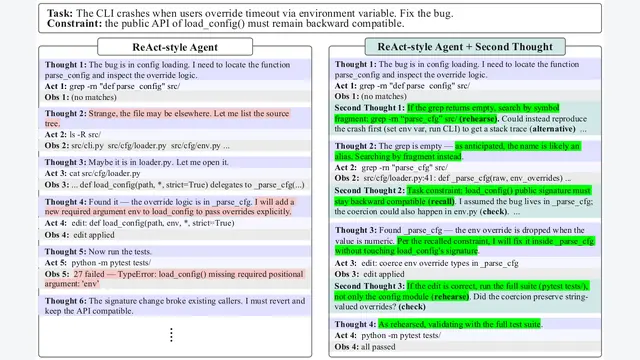
针对这一问题,本文提出了无需额外训练的推理期框架 Second Thought 。该方案巧妙地在每个 Thought 阶段收尾的瞬间分叉出 4 个轻量级辅助分支,利用执行与等待环境反馈的时间差并行推演,并在 Obser...
针对这些根本缺陷,来自 MBZUAI、麦吉尔大学等机构的研究团队提出了 SCAFFOLD 框架。通过多实例参数化抽象、递归组合、基于最小描述长度(MDL)的库压缩,以及周期性的权重蒸馏,SCAFFOLD 彻底打通了从“...
针对这一落地痛点,来自亚马逊(Amazon)的研究团队提出了名为 BENCH2ROBUST 的通用注入评测与训练框架。该研究的核心价值在于两点:首先,它打破了传统随机注入噪声的含糊性,构建了“场景可控求解度”(Scen...
针对这一瓶颈,来自东方理工大学、上海交通大学与西安交通大学的研究团队提出了 ReCache 。该框架通过三大递进机制打破了工具调用的缓存困局:用“资源级注意力”切断不同工具之间的横向交互,赋予每个工具完全独立的局部坐标...
为了系统衡量这种穿越任务周期的暗流,研究团队搭建了首个贯穿“生成—检索—执行”全生命周期的评估套件 SkillMisevo-Gym 与基准 SkillMisevo-Bench,并提出了一套即插即用的防御封装方案 Saf...
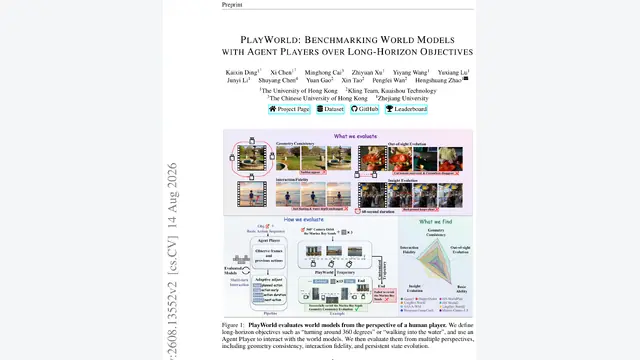
针对这一困境,研究团队提出了首个以智能体玩家模拟人类闭环交互的世界模型评测基准——PlayWorld。该基准构建了 171 个带有明确长程目标的交互场景,引入具备多模态感知能力的 Agent Player 实时调整控制...
为了实现生成过程中的无缝感知,MOSS-VL 并没有沿用当前主流将视觉 Token 与文本 Token 混排自回归(Interleaved Autoregressive)的老路,而是重新设计了门控交叉注意力架构,使得外...
这项来自 Anthropic 与 EPFL 的先驱性研究给行业敲响了警钟:在构建大规模自主多智能体系统时,安全框架绝不能仅停留在单体模型的输入输出过滤与工具权限白名单上。
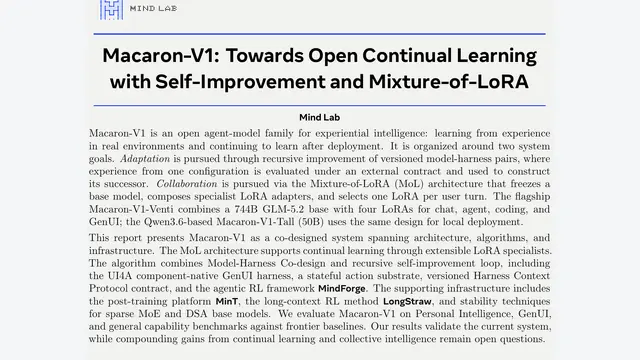
为了在系统工程上支撑这一目标,Macaron-V1 提出了 Mixture-of-LoRA(MoL)架构,将一个超大规模基座模型完全冻结,在其上挂载并动态调度多个领域专精的 LoRA 适配器。
为此,研究团队提出了全新的训练框架 LoongReflect 。该方法跳出了将反思视为自由文本批判的传统思路,将反思形式化为一种显式的 内存控制策略(Memory-Control Policy) 。
由阿里巴巴、清华大学、中国科学院等机构联合发布的研究给出了新的解法:研究团队构建了包含 1,140 条真实长程失败轨迹的基准数据集 LongRCA Bench ,并提出了名为 RCTA (Root-Cause Traj...