不看代码不发请求:MCPSec仅凭描述挖出98.9%的MCP注入漏洞
针对这种“无从下手”的极端攻防环境,亚利桑那州立大学(Arizona State University)的研究团队在一篇前沿论文中开创性地提出了 无盒漏洞分析(No-Box Vulnerability Analysis...
多模态&视觉
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
针对这种“无从下手”的极端攻防环境,亚利桑那州立大学(Arizona State University)的研究团队在一篇前沿论文中开创性地提出了 无盒漏洞分析(No-Box Vulnerability Analysis...
NCP-ArchPreview:实验结果显示,仅仅对这 17M 权重在 Magicoder、Orca-Math 等特定语料上进行低成本迭代,模型便能在完全不遗忘通用能力的前提下,迅速完成对目标领域的概念重对齐。其数学与...
由 Apple、香港中文大学(CUHK)、EPFL 等机构联合提出的 Modus ,直接打破了这一工程惯例。它证明了: 不需要为每个模态定制专门的预测头,也不需要外挂专有损失函数或复杂的任务管道,完全基于统一的单解码器...
作者团队提出了模型无关的中间件协议 MemTX ,首次将数据库经典的事务机制、隔离级别与信念提交管线引入智能体记忆架构,实现从未成熟记忆到动作执行、再到撤销级联修复的全生命周期治理。
为了解决长程机器学习工程中的上下文膨胀与搜索效率低下问题,来自佐治亚理工学院(Georgia Institute of Technology)的研究团队提出了名为 Matryoshka Agent 的全新分层智能体框架。
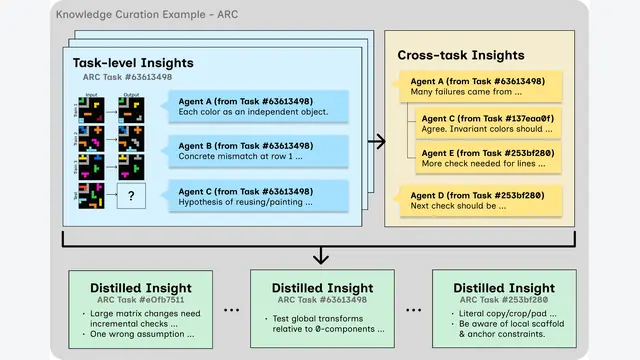
最新研究提出了一个截然相反的互补范式:以知识为中心的自我改进(Knowledge-Centric Self-Improvement)。在这个架构中,核心假设被彻底颠倒——执行具体任务的 Agent 不再是长期维护、日益...
这一发现为当下狂热的 Agent 架构设计泼了一盆清醒的冷水。要把一本数十万字的长篇书籍交给 Agent 解答,工程上有多种不同的组织形态。以往的经验分享往往将文件切分颗粒度、目录索引存放位置与递归深度混为一谈。
研究者从理论上严格证明了 Token 级与轮次级强化学习在策略梯度目标上的数学等价性,并在此基础上提出了全新的 HyGAE 框架。该框架不仅巧妙融合了两者的优势估计,还通过理论证明消解了训练两个独立价值网络的算力负担。
由蚂蚁集团、北京邮电大学与中国移动研究院联合提出的 HiSkill 框架,为这一难题提供了一套系统性的图结构解决方案。该研究打破了将经验视为纯文本片段的传统范式。
在此诊断之上,团队提出了带有硬件感知稀疏特性的残差量化机制 Rollout-ResQ,并结合三级层次缩放的 HiFloat4(HiF4)格式,在 Qwen2.5-3B 和 Qwen2.5-Math-7B 上,将全链路 ...
研究团队借鉴自监督学习(Self-Supervised Learning, SSL)“从无监督数据中构造辅助代理任务(Pretext Task)以获取标签”的核心思想,提出了 RLSVR(Reinforcement L...
为了兼顾环境的逼真度与评测的完全可控性,E-Bench 采取了“全合成(Fully Synthetic)”的底层设计方案,并提出了核心原则: 将环境合成与任务合成彻底解耦 。许多传统合成评测往往采用“为任务定制快照”的...
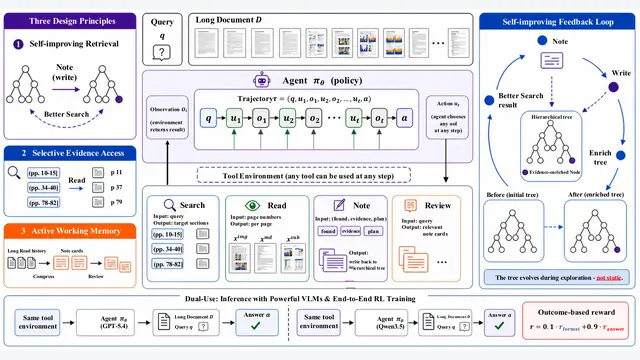
研究团队提出了名为 DocAtlas 的文档交互外壳(Document Harness),让检索树索引、笔记库和已探索页面随着 Agent 的探索实时演化。该框架在业界引发关注的核心在于两组数据:在极具挑战的多模态长文...
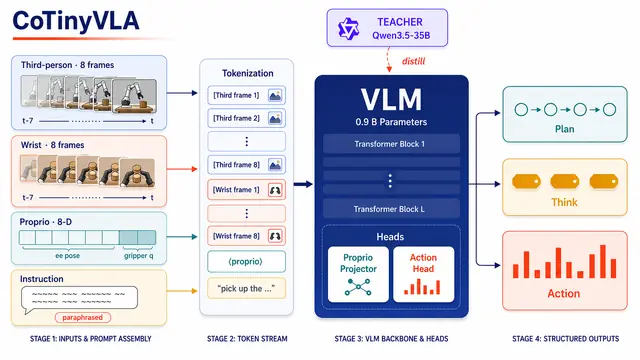
CoTinyVLA 提出的三个组件到底各自发挥了什么作用?作者在 Spatial 套件上进行了细致的因果消融与测试期干预,结果展示出清晰的正交性: 1. 时序输入决定运动学抗扰度 :当把双视角 8 帧历史缩减为单帧时。
HybridDeepResearch 的提出,给当前过热的“智能体深度研究”浪潮浇下了一盆及时的冷水。它清晰地表明,能够在单一模态下刷出高分的大模型,一旦被置于需要多系统无缝衔接的真实生产力场景下,其表现依旧脆弱不堪。...
针对这一瓶颈,该团队提出了 AutoMem ——一个基于“文本梯度”(Text-Gradient)递归自优化的自动化记忆架构搜索框架。该方法将记忆系统解耦为编码(Encode)、存储(Store)、检索(Retriev...
英伟达团队的技术假设在于:自然语言的广阔表达空间更符合高阶数学的探索本质,而消除逻辑谬误的关键,不在于引入外部编译器,而在于构建专门化的后训练模型组合,并设计高算力驱动的测试时搜索与纠错机制。
针对这一前沿交叉地带,一项名为 ABLE (Agentic BAIM–LLM Evaluation)的评估基准正式提出。该基准专门设计用于测试大模型智能体调用专业生物 AI 工具完成蛋白质设计全流程的能力。

基于此,作者团队提出了一种轻量且高效的防御范式 AGRI(Action-Guiding Reasoning Intervention),通过实时探测模型的隐层状态动态激活思维链干预,在极难的 AgentDojo 基准上...

腾讯的研究团队在论文中提出了名为 WikiLoop 的反馈耦合框架,尝试打破这一长期存在的单向壁垒。该方案的核心思路在于:构建一套专为智能体机器导航设计的原生维基知识库(Agent-Native Wiki),并将知识库...

基于这一洞察,作者提出了 CoMem(Comprehension Memory,理解记忆) 架构。该方法放弃了在 Token 轴上硬扛完整深度 KV 的传统思路,转而沿 模型层深(Depth Axis) 对长文本记忆进...

TREK 的诞生不仅为旅行规划这一细分场景提供了高难度的压力测试场,更对大模型智能体评估的方法论提出了新的范式转移。它向整个社区传递了一个明确的信号:依赖大模型裁决软性评分的时代应当被重新审视,特别是在那些关乎真实业务...

为了让 TransMem 学习到通用的“信息提取与利用能力”,而非特定的事实知识,作者提出了一种优雅的训练策略: 证据条件自蒸馏(Evidence-Conditioned Self-Distillation, ECSD...

基于这一底层机理,研究团队提出了一个极为简洁却极其有效的轻量防御方案 SafeKeep :在推理时将“安全审计”与“工具执行”彻底解耦。在安全评判环节,把原本结构化的 Schema 剥离成扁平的自然文本叙述,瞬间唤醒模...