Google实测352万次提交:AI代码很少急性崩溃,却让算力开销增加5-8%
Google:实验结果清晰地表明了“盲目提示”与“精准开药”的差距。仅仅依靠第二阶段的泛化指令,模型往往在代码外围做无用功,甚至引发代码膨胀;而一旦在第三阶段提供精准的缺陷分类反馈,模型便能准确识别此前遗漏的性能陷阱。
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
Google:实验结果清晰地表明了“盲目提示”与“精准开药”的差距。仅仅依靠第二阶段的泛化指令,模型往往在代码外围做无用功,甚至引发代码膨胀;而一旦在第三阶段提供精准的缺陷分类反馈,模型便能准确识别此前遗漏的性能陷阱。
针对这一核心瓶颈,来自 AweAI、中国人民大学及独立研究团队的研究者们提出了 CalibForge 。这是一套基于 对抗求解器校准 (Adversarial Solver Calibration)的自主终端任务合成系统。
针对这一根本隐患,研究团队提出了 观察校准自蒸馏(Observation-Calibrated Self-Distillation, OCSD) 。该方法通过构建两套结构完全对齐、仅差真实环境观测的回放视图,精准剔除回...
为了打破单次判决的局限,来自南京大学、南洋理工大学与新加坡管理大学的研究团队提出了 AgentAntibody 。该工作借鉴生物学中的自适应免疫系统(Adaptive Immune System),首次为大模型智能体建...
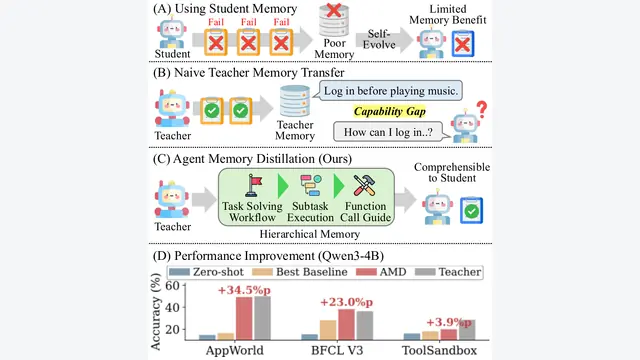
为了攻克这一难题,来自韩国科学技术院(KAIST)与 DeepAuto.ai 的研究团队提出了一种无需重新训练参数的全新框架:Agent Memory Distillation(AMD,智能体记忆蒸馏)。
来自上海交通大学的研究团队提出了名为 ABC(Answer-Backtracked Credit Assignment,答案倒推信用分配) 的全新框架,并基于 Qwen3.5-4B 训练出了长程搜索智能体 ABSeek...
针对这一根本痛点,来自北京大学、北京理工大学、EvoPhys AI 以及香港科技大学等机构的研究团队提出了名为 WorldSimProbe 的系统性诊断基准。该研究不再把世界模型当成单纯的视频生成器,而是将其拉回物理模...
中关村学院等机构提出的 World Tokens 给出了一条极具启发性的破解思路: 将世界模型完全限制在训练阶段,推理部署时彻底剥离 。该方案既保留了世界模型带来的物理时空演进监督,又让在线推理维持在毫秒级的纯 VLA...
研究人员深入剖析后,提出了极具解释力的“对话优先溯源假设”(Conversation-First Provenance Hypothesis)。真正的可复用模块应当具备自包含、可移植与接口清晰的软件工程属性。
针对这一工业落地痛点,来自亚马逊(Amazon)的研究团队提出了名为 TRACE (TRajectory Attribution for Automated Context Engineering)的自动化反馈回路框架...
为了彻底纠正这两种扭曲,研究团队提出了名为 ToolVision 的能力对齐视觉工具调用框架。ToolVision 在 SFT 阶段通过多智能体管道探索轨迹,并由包含学生尺寸模型的委员会量化评估逐步证据增益,只保留学生...
但由南方科技大学等机构联合发表的最新研究 SkillSmith 提出了截然不同的诊断结论:端侧模型的核心短板并非通用智能不足,而是缺乏特定任务环境的规则与操作常识。
为了解决这种典型的“模型不匹配”(Model-Mismatch)难题,来自哈工大、上海人工智能实验室、上海交通大学以及清华大学的研究团队提出了 SKILLER 。
为了解决这一痛点,腾讯联合武汉大学提出了面向生产级数仓任务交付的端到端自动化智能体系统 —— SiriusDeliver 。该系统不仅能写代码,更接管了从业务需求解析、环境元数据对齐、工件全生命周期质检到平台自主提交与...
来自阿里巴巴达摩院与湖畔实验室的研究团队提出了具身价值基石模型 RynnValue 。该工作放弃了主观的偏好标注与归一化的虚拟进度,直接回归最优控制理论中最本质的物理物理量: 时间距离(Temporal Distanc...
本文提出了名为 Repeat-After-Me 的黑盒自适应视觉提示词注入框架。该方法不依赖梯度,无需白盒权限,在正常的良性用户任务干扰下,成功诱导前沿商业模型泄漏隐私数据,甚至精准触发原生工具调用(Native To...
不列颠哥伦比亚大学(UBC)的研究团队提出了 MDA (Model Discovery Agent,模型发现智能体)。这项研究打破了以往“纯大模型试错”与“传统静态贝叶斯推断”各自为战的局限,首次将大语言模型的开集假设...
近期,来自同济大学、南京大学、西北工业大学、中国人民公安大学以及巴黎高等师范学院的研究团队提出了名为 MIRA (Medical Image Reflection for Agentic Diagnosis)的全新医疗...
来自卡内基梅隆大学(CMU)、加利福尼亚大学洛杉矶分校(UCLA)、上海交通大学等机构的研究团队提出了 MERA (Model Evolution and Routing with Skill Adaptation)。
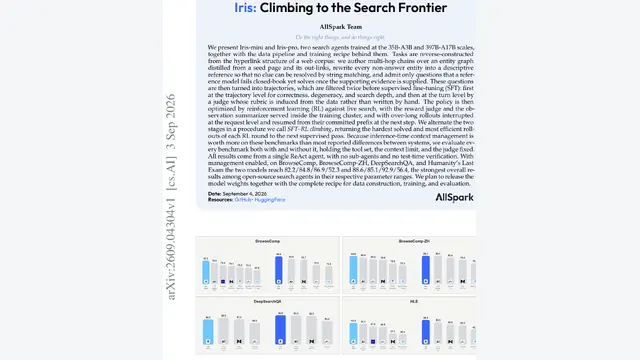
Iris 对此提出了由粗到细的二级清洗策略。粗粒度过滤针对整条轨迹进行硬性指标截断: 首先是端到端正确性门控,轨迹必须正常终止,且提取的最终答案必须通过大模型裁判的语义对齐检验; 其次是基于 zlib 压缩率的退化检测...
针对这一盲区,字节跳动 Seed 联合清华大学、北京大学的研究团队提出了专门针对代码智能体的指令遵循基准 Harness-IF 。该工作将指令拆解为可被执行证据逐一判决的原子规则,涵盖真实运行环境中的多层“指令表面”(...
Harbor-Index:为了确保转译过程不破坏基准原有的评测语义,研究团队并未采取粗暴的代码重写,而是设计了由自动化检查、初审和终审构成的三阶段人工代码审查机制,累计在 GitHub 上产生了超过一万条审核讨论;同时...
针对这一根本缺陷,该团队首次形式化定义了 执行状态遗忘(Execution-State Unlearning) ,并提出了 出处导向的选择性重放(Provenance-Guided Selective Replay) ...
然而由 Salesforce Research、北卡罗来纳大学教堂山分校(UNC Chapel Hill)与威斯康星大学麦迪逊分校(UW-Madison)联合提出的最新基准 EvoHarnessBench ,却揭示了一...