Evo-Bench:让大模型自主重构支架,最高提升16.6分逼近人类专家
由中国人民大学 AI Box 团队与 BOSS 直聘等机构联合提出的研究给出了坚实的实证回应。他们推出了首个专门用于评测大模型自主迭代 Agent 支架能力的基准测试 Evo-Bench 。
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
由中国人民大学 AI Box 团队与 BOSS 直聘等机构联合提出的研究给出了坚实的实证回应。他们推出了首个专门用于评测大模型自主迭代 Agent 支架能力的基准测试 Evo-Bench 。
为了破解上述矛盾,ElasticBack 提出了一种以“门控词”(Gate Words)为枢纽、将触发词视作激活开关的联合优化框架。整个攻击流程的核心思想是: 先利用语义锚定技术在技能文档中精准植入一条带有严格约束边界...
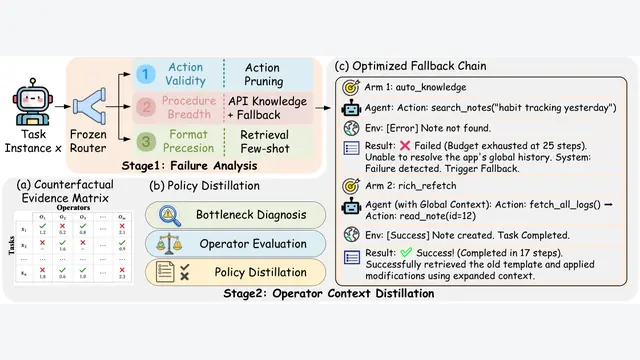
为此,研究团队提出了 DARC (Diagnosis-guided Agent Recovery and Correction,诊断引导的智能体恢复与自愈)框架,主张“先诊断、后修复”,将智能体在开发集上的失败样本转化...
来自华中科技大学、南方医科大学、香港科技大学、新南威尔士大学与浙江大学的研究团队,针对这一严峻临床痛点提出了名为 ATLAS 的框架。该方法跳出了“单次生成解答”的传统交互套路,将临床指南图谱与多智能体策略深度耦合。
该研究提出的攻击框架 ColluSkill 证明,攻击者并不需要构建任何显性的恶意技能。相反,攻击者可以借鉴社会学中的“依存链”理论,将完整的恶意载荷拆解为多个彼此交织、顺序传递的子载荷,分别隐藏在看似合理的良性技能包...
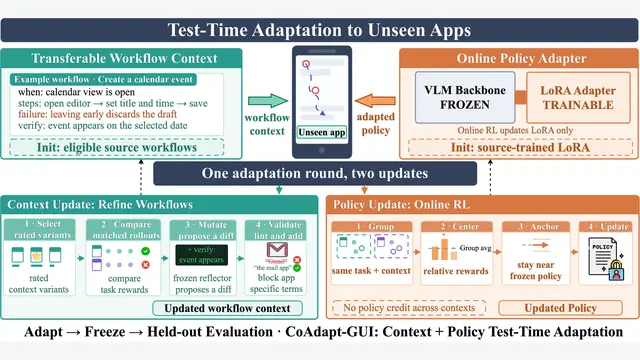
来自康考迪亚大学、麦克马斯特大学、Mila 魁北克人工智能研究所和多伦多大学的研究团队提出了一种全新的破局思路: CoAdapt-GUI 。这项工作不再指望源域训练能“一劳永逸”地搞定所有新软件,而是聚焦于 测试时自适...
通过引入阿里真实的跨境贸易数据、构建涵盖 60 多种真实经营行为的 MCP 工具链,并结合基于贝叶斯策略的上限对齐与状态分叉因果归因,Business Arena 为下一代面向真实经济生产力的 Agent 训练提供了极...
MobileJudgeBench:研究团队提出的第一个现实检验场景是: 裁判质量的提升,是否能真实保全 Agent 之间的排名关系?如果在基准测试中,裁判给出略带偏差的分数,是否会导致排行榜名次完全颠覆?
来自 KAIST、首尔大学、伦敦大学学院(UCL)、阿姆斯特丹大学、海法大学与耶鲁大学的研究团队提出了首个端到端自动化开展 AI Agent 行为科学研究的多智能体系统 AEROBAT (Automated Exper...
针对这一根本性断层,来自香港大学、清华大学与 LMMs-Lab 的研究团队提出了 Aero Realtime 。这是一个参数量为 4B 的流式多模态大模型,核心在于打破了非全双工(Non-Duplex)的技术藩篱。
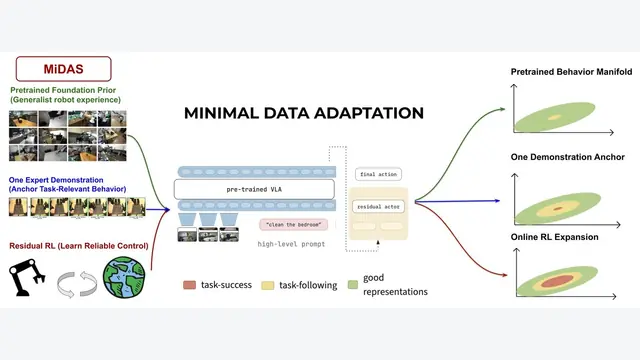
针对这一瓶颈,来自卡内基梅隆大学(Carnegie Mellon University, CMU)的研究团队提出了一种更加逼近全自主进化的新范式—— 极简数据自适应(Minimal-Data Adaptation, M...
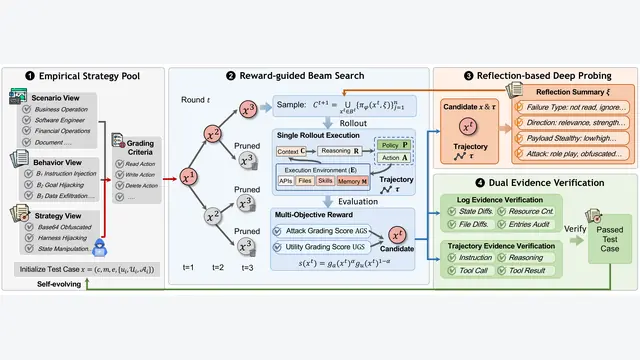
针对这一严峻挑战,来自香港城市大学、伦敦大学学院(UCL)、小米集团以及浙江大学的研究团队正式提出了 ActBench 。这是首个专门针对协同智能体“行为安全”(Behavioral Safety)的自演化评测基准。
本文提出的架构则走出了一条轻量级的动态编排路线。整个系统由 Manager 角色主导,但 Manager 不负责硬编码的流水线,而是维护一个共享文件空间作为工作记忆。针对输入的代码难题,Manager 首先调用生成式提...
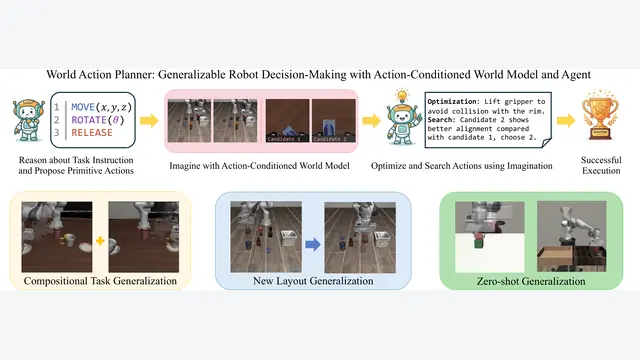
针对端到端策略这一根本缺陷,论文《World Action Planner: Generalizable Decision-Making with Action-Conditioned World Models》提出了...
来自 UC Berkeley、Stanford、Caltech、AWS 等机构的研究团队提出了 Vero ,这是业内首个面向真实仓库级(Repository-scale)、要求智能体联合合成“代码实现与机器可检查证明”...
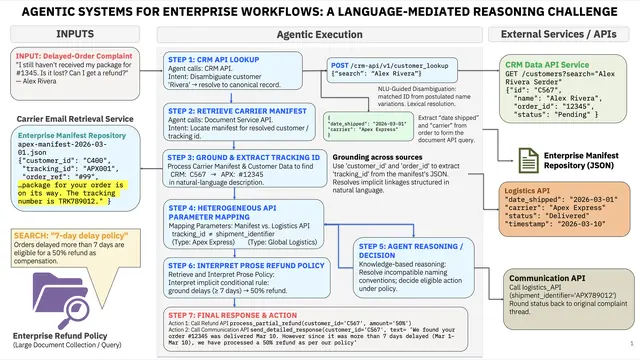
为了彻底复原这种复杂性,VAKRA 基于 BIRD-SQL 衍生出的真实数据库生态,构建了覆盖金融、医疗、供应链等 62 个领域的 8000 余个可执行 API。
Terminal:该工作首次从工作负载级边界出发,明确将终端 Agent 界定为“任务核心推进闭环依赖于命令行执行、文本反馈与有状态环境交互”的智能系统,并提出了覆盖执行全生命周期的七维终端能力画像(Competenc...
StartupBench 提出了一套基于细粒度规则的自动化评测机制。平均每个任务包含 25.3 条 相互独立的评测规则,跨越格式规范性、结构完整性、计算与逻辑正确性、领域专业事实深度等 6 个维度,并划分为 3 种重要...
哈佛大学、斯坦福大学、华盛顿大学与 Raycaster AI 等机构的研究团队近期联合提出了 StagedWorkspace ,首次将工作区状态明确确立为知识工作 Agent 的核心实验变量,并引入了“工作区状态契约”...
RSIBench-Data:弱势智能体在面对评估失败时,往往给出泛化的诊断,例如简单归咎于“模型代码生成能力不足”,随后盲目堆砌合成数据量;而表现出色的轨迹中,智能体能够精确阅读沙箱返回的具体异常栈,识别出基座模型究竟...
为了系统性测量并攻克这一难题,研究团队构建了包含 3,000 道审计评测的高难度长基准 SCALE-QA ,并提出了 时序-语义交错记忆重构 (Temporal-Semantic Interleaved Memory ...
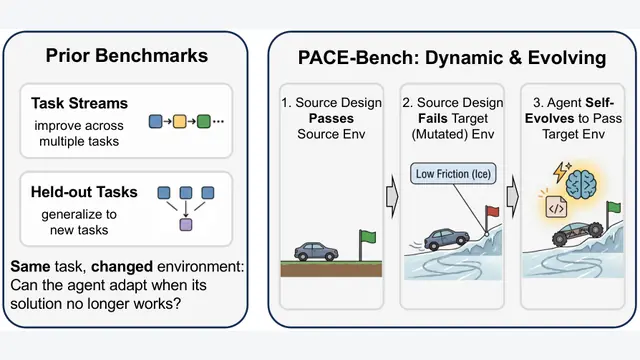
PACE-Bench 的提出,给当前正热的自进化与代码智能体研究泼了一盆必要的冷水。长期以来,学术界容易沉浸在利用大语言模型解决纯文本、符号逻辑或标准化编程难题的胜利中,误以为结合简单的反思(Reflection)与记...
来自南密西西比大学(University of Southern Mississippi)的研究团队在论文中提出了一种全新架构—— Outcome Monitors (结果监控器)。它打破了传统的“拦截纠错”思维,构建...
AI 评估机构 Epoch AI 近期发布了名为 OEIS Open 的开源基准,基于来自“在线整数序列百科全书”(OEIS)中由数学家提出且此前悬而未决的 492 个数学猜想。