KernelArc:不是单Agent死磕,而是共享记忆协同!登顶B200算子榜
为了打破这种“单兵死磕”的局部最优困境,来自 IMEC 与 AILabs 的研究团队提出了名为 KernelArc 的多 Agent GPU 内核协同优化架构。
AI Agent模型优化
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
为了打破这种“单兵死磕”的局部最优困境,来自 IMEC 与 AILabs 的研究团队提出了名为 KernelArc 的多 Agent GPU 内核协同优化架构。
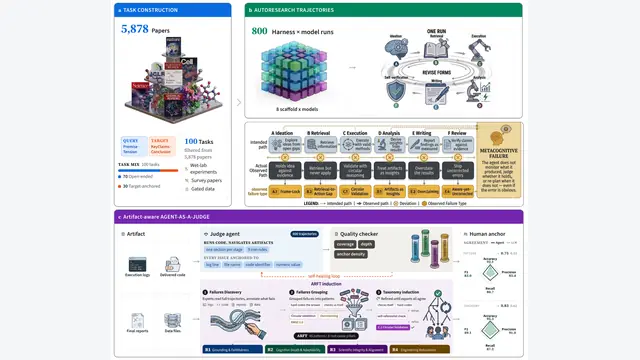
来自斯坦福大学(Stanford University)、Prentis AI 以及 Titan Holdings 的联合研究团队在最新工作中提出了 AutoResearchEval 评测基准与实证失效分类法 ARFT...
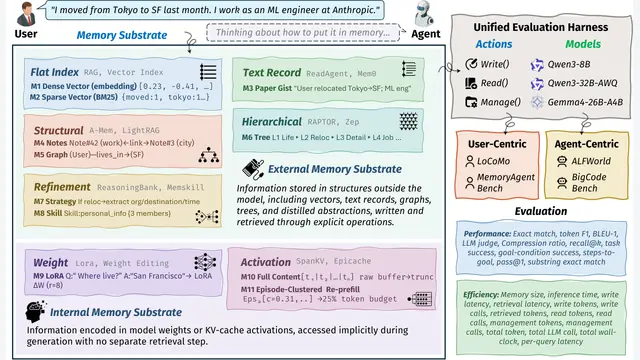
研究团队在系统梳理了 2023 至 2026 年间 52 个代表性记忆增强智能体系统后,指出了当前评测的三大结构性缺陷。超过六成的评测指标被完全集中在 LoCoMo 和 LongMemEval 等纯对话问答基准上,而真...
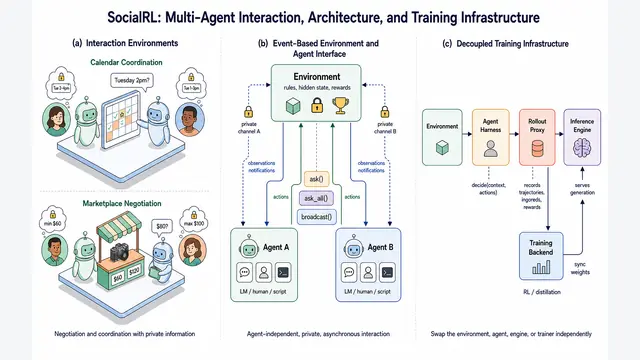
研究团队提出了名为 SocialRL 的完整训练架构,仅用一个 4B 参数规模的小语言模型,在六大典型博弈环境中展开训练。实验结果表明,经过领域内博弈训练的 4B 模型不仅在多项谈判指标上超越了未微调的基线,甚至在平均...
由 UIUC、亚马逊、宾夕法尼亚州立大学、埃默里大学等机构联合提出的 Evo-Harness 框架,正是为了击破这一瓶颈。该研究重新定义了“在线脚手架学习”(Online Harness Learning)范式,不再把...
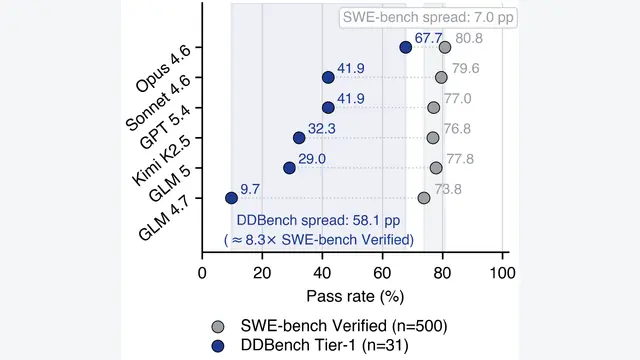
DDBench:同时,研究人员设计了一组严格对照实验:一边只给模型故障现象与仓库(Symptom-only),另一边额外喂入轻量且受控的调试上下文(Context-augmented,包含日志、追踪、运行时快照等,中位...
来自深圳国际工业与应用数学中心、中大深圳、深数院以及中山大学等机构的研究团队提出了 ERSkill(Evolving Retrieval Skill) 框架。这项工作跳出了“只优化记忆构建或推理引导”的旧范式,首次将 ...
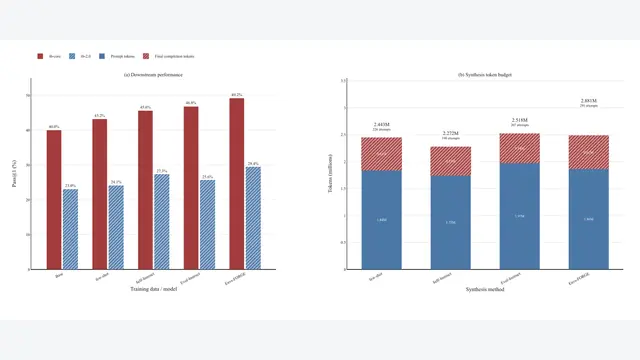
针对这一问题,来自香港科技大学、IDEA 研究院和 DataArcTech 的联合团队提出了 Envs-FORGE 。该研究放弃了静态的 Prompt 模板,转而将环境合成形式化为一个由验证器奖励驱动的 动作决策问题 。
该研究整合了 164 篇学术成果、100 份工业界实践记录、29 个主流基准及 17 个真实运行系统案例,提出了一个串联评测与运行的“可靠性依赖链”(Reliability Dependency Chain)架构,并提...
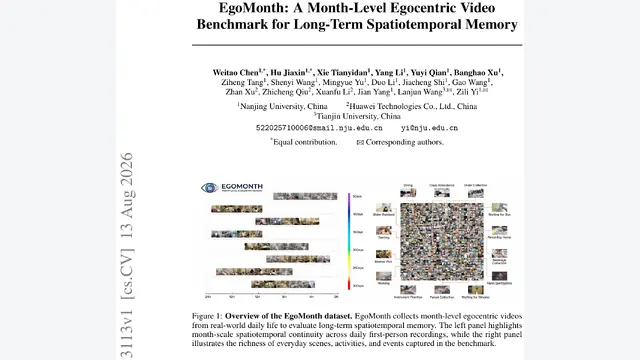
基于这些长周期数据,EgoMonth 提出了一个受到认知心理学与工作记忆理论启发的 14 任务评估体系,将其清晰地划分为由浅入深的三个认知层级: 1. 图式巩固(Schema Consolidation) :评估模型从...
然而,伊利诺伊大学厄巴纳-香槟分校(UIUC)的最新研究提出了一个截然相反且直击痛点的论断: Agent 在长程交互中犯错,往往不是因为“找不到事实”,而是因为“记错了版本”。随着交互时间推移,现实世界中的事实、用户约...
为了系统性评估资源劫持威胁的广泛程度,研究团队首先打破了“资源仅指 API 密钥与算力”的狭隘认知,提出了一个覆盖六大维度的智能体高价值资源分类框架: 1. 物质资源(Material Resources) :包括智能...
针对这一顽疾,研究团队提出了 多样性感知提案采样框架(Diversity-Aware Proposal Sampling,简称 DAPS) 。在严格隔绝的“闭环-审计-双盲”三层验证协议下,DAPS 将算法语义聚类的衰...
针对这一困境,来自 NVIDIA 与加利福尼亚大学圣克鲁兹分校(UC Santa Cruz)的研究团队提出了 BaT(Benchmark-as-Teacher) 。该方法颠覆了传统基准测试只作为静态考卷的固有定位,将其...
回溯整篇论文的工作,AsymSpec 的价值不仅在于提出了一个精巧的推测解码新变体,更在于它向大模型工程界传达了一个深刻的认知升级: 在长文本与智能体时代,“让所有模型处理相同输入”是一场巨大的算力浪费。现代 Agen...
然而,来自 Salesforce AI Research 与 伊利诺伊大学厄巴纳-香槟分校(UIUC) 的研究团队在最新论文《AI4AI at Test-Time: Strong-to-Weak Capability ...
ADeptS-Bench:实验结果揭示了各家模型在安全架构底层逻辑上的三条分水岭: 第一种是 工具依赖型防御(Tool-dependent) ,典型代表为 Gemini 3.1 Pro。在移除拒答工具后,该模型的恶意被...
为彻底解决这一问题,ABot-World-0 提出了核心训练创新—— LongForcing 。LongForcing 的本质是在更长的时序跨度上,对 Student 自身的长程自推演轨迹(Self-rollouts)...
WeatherNext 3 选择在模型内部彻底打通这一环节,提出了针对离散观测的“站点输出头”(Station Output Head)。这一机制的本质是将天气预报转化为连续时空的函数查询任务: 在给定预报时刻,模型提...
SWE-Bench:论文中举出了一个极具代表性的案例:在 NASA 的 F'Prime 飞行软件框架中,一项将单体头文件拆分为全新统一定义入口的重构任务,要求 Agent 同时协同修改跨越自动化代码生成器、设备驱动、操...
他们提出了一种具备自我修改能力的 Lean 证明智能体框架,核心亮点在于打破了“固定评测基准评判自修改代码”的传统范式,引入了智能体与基准题库的 协同进化(Coevolution)机制 。
LinkedIn 建立了一套高度解耦的模块化评估框架,将客服交互质量拆解为互不干扰的独立维度,并分别设计评估策略: - 接地性与事实依据(Groundedness) :专门校验 Agent 生成的每一条事实性断言是否严...
为打破这一僵局,来自北京航空航天大学、京东科技与北京大学的研究团队提出了可扩展的数据合成管线 MAGE ,并基于其构建了首个大规模家电操作规划数据集 UseAppliance 。
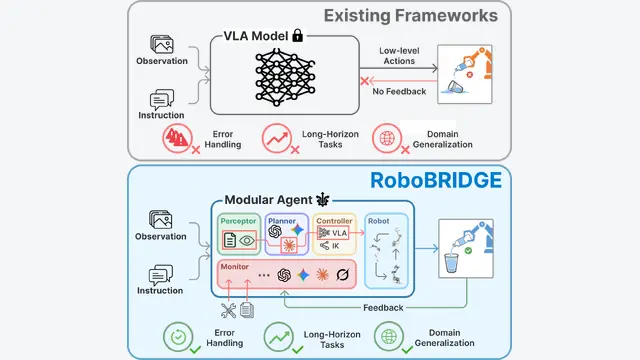
针对此瓶颈,最新提出的 RoboBRIDGE 框架给出了一种模块化编排方案:它不对底层 VLA 进行伤筋动骨的重训,而是在控制策略外层构建了一套由监控器(Monitor)、感知器(Perceptor)、规划器(Plan...