
宁可多写兜底也不删废代码?CanItDelete揭示大模型编程硬伤
从 CanItDelete 暴露出的断层,到仅需 0.7% 数据微调便能大幅缓解的实验结果,论文指向了一条清晰的演进路径:未来的代码大模型后训练,必须将“减法能力”提升到与“加法能力”对等的战略高度。
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
从 CanItDelete 暴露出的断层,到仅需 0.7% 数据微调便能大幅缓解的实验结果,论文指向了一条清晰的演进路径:未来的代码大模型后训练,必须将“减法能力”提升到与“加法能力”对等的战略高度。

针对这一问题,本文提出了一种轻量且通用的后训练框架—— TAPO (Transition-Aware Policy Optimization)。该方案的核心突破在于: 不采集任何额外的专家数据,不增加任何多余的在线采样...

面对一台已经被攻击者通过网络渗透拿下的云主机,Agent 能否像资深安全专家一样,根据告警日志与底层只读磁盘快照,层层抽丝剥茧还原整个入侵链路,找齐所有隐蔽后门,并提出一套真正可用且完成闭环验证的处置修复方案?来自阿里...

针对这一系列痛点,来自开源社区的研究者提出了 SearchMaster ,这是一个兼具“落地约束(Grounded)”与“行为规范(Regulated)”的搜索智能体自我博弈框架。

近期发表的这项工作提出了 SciDisco 框架,试图彻底改变这一现状。其核心思路不是在推理阶段堆叠复杂的 Prompt 工作流,而是构建了一个原生支持过程验证与多轮信用分配的训练闭环。

针对这一评估盲区,来自学术界的最新研究提出了首个专门用于受控评估终身智能体路径依赖特性的评测框架 PATH-Bench 。该框架利用多模型上下文学习(ICL)预先估计任务之间的有向迁移关系,构建以固定“探针任务”(Pr...

CMU:更进一步,团队提出了一种成本感知的选择性路由架构:先用轻量级统计特征过滤出高风险异常时段,仅在可疑度达到阈值时才唤醒开销巨大的强模型进行精细语义研判。实验表明,这种按需调用的动态策略在取得 0.629 的 Bu...

RadixArk:随着 Miles 开源生态的演进,前沿尺度的 Agent 训练技术门槛将被进一步拉低,为学界与工业界构建真正具备自我演进能力的复杂智能体提供了稳固可靠的工程底座。

针对这一矛盾,最新研究提出了 Meta-Task 框架,其核心哲学非常直接而巧妙: 与其用外部流水线生硬拼接任务,不如把“合成终端任务”本身定义为一个标准的 Terminal-Bench 格式任务(即元任务,Meta-...

HoF-Bench 的实验结果重构了软件工程团队对 AI 辅助代码安全分析的固有认知。它明确证实了利用廉价模型搭建实用级 SAST 分析器的可行性。以往企业往往受困于大参数前沿模型高昂的 Token 费用和有限的速率配...

为了从根本上改变这一表征维度的瓶颈,本文提出了 G-ReAct (Graph-guided Reasoning and Acting)框架。该工作不再寄希望于依靠纯粹扩大模型规模或堆叠数万条轨迹的强化学习(RL)来硬抗...

为此,研究团队提出了 FRAMES (Feedback-driven Reasoning with Adaptive Mutation and Evolution of Skills,自适应突变与技能演化的反馈驱动推理...

为了彻底打破这种“自测自纠”中的共谋缺陷,来自佐治亚理工学院、微软研究院(MSR)和威斯康星大学麦迪逊分校的研究团队提出了 ExecCritic 。该工作将测试生成与代码修复彻底拆分为两个相互独立的智能体角色,通过硬核...

针对这一空白,来自蚂蚁集团与浙江大学的研究团队提出了专门针对深度搜索 Agent 的端到端分层评估基准 HAE-GEO 。该基准将原本不可见的交互过程拆解为从“暴露”到“恢复”的五阶行为轨迹,并在控制变量的真实网页环境...

近期,小米团队提出了名为 DriveZero 的全新端到端自动驾驶框架,试图从底层打破对人类轨迹监督的绝对依赖。这项研究的核心结论非常直截了当:即便 完全不使用任何人类驾驶轨迹作为训练目标 ,端到端系统不仅能够学会复杂...

Wix 团队在其线上生产环境提出并部署了一套 三阶段技能选择流水线 ,引入了 确定性可执行性门控(Deterministic Executability Gating) 机制。

Data:实验结果令人咋舌:原生未经微调的 Qwen3-0.6B 基座在开启思考链时的得分为 67.4%,但经过 Raw-OS 训练后,性能不仅没有提升,反而断崖式下跌至 55.1%,出现了严重的“负向迁移”。

针对这一困境,华南理工大学的研究团队提出了 CoRL(Co-Evolutionary Reinforcement Learning)框架,尝试从博弈论和动态演化的视角彻底重塑防御体系。
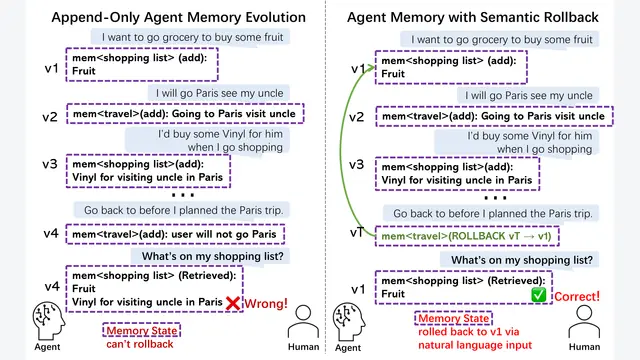
ChronoMem 的提出,不仅为开源社区提供了一个开箱即用的工程插件,更指明了 Agent 记忆机制演进的必然趋势。以往的研究和商业实现,大多将重心放在了“如何让 Agent 记住更多、关联更广”,但忽视了“如何让 ...
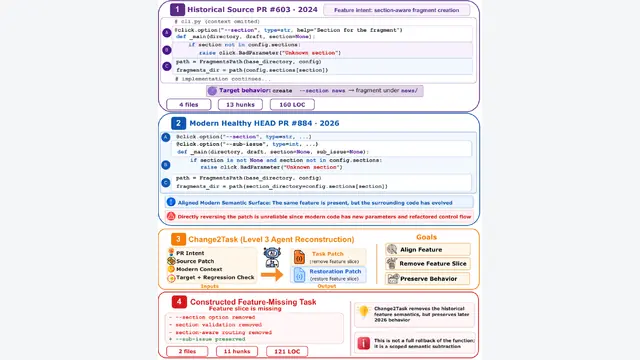
为了破解“真实性”与“现代可执行性”之间的两难困境,研究者提出了名为 Change2Task 的系统性框架。该系统的核心逻辑在于: 不再费尽周折地去维护老旧历史快照,而是将代码库历史中已合并的真实 Pull Reque...
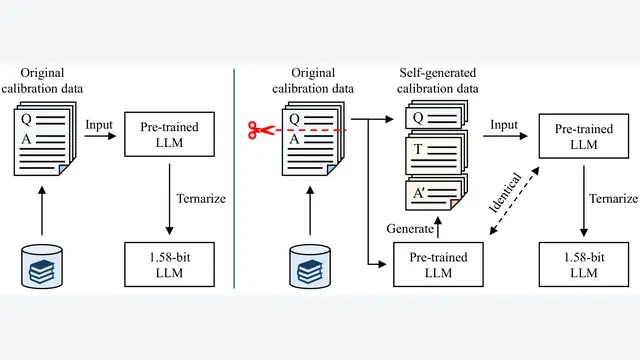
针对这一困境,研究人员提出了全新的三值化 PTQ 框架 ScaleQ-1.58 。该框架的核心洞察非常尖锐:在极低比特的重构过程中,传统 PTQ 沿用通用网页文本进行校准的做法从根本上忽略了思维链(Chain-of-T...
AppSim-Bench 专门设计了 183 个包含数值推理属性的子任务,涵盖四类具体操作: - 计数(Counting) :需要连续滑动并统计界面上符合条件的卡片或列表项总数; - 算术计算(Arithmetic C...
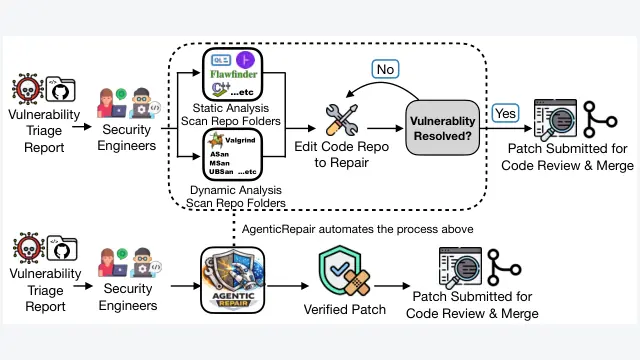
针对这一核心瓶颈,最新研究提出了 AgenticRepair 框架。这项工作不单是在单 Agent 循环中添加更多工具,而是提出了 多维程序上下文工程(Multi-Faceted Program Context Eng...
快手技术团队、南洋理工大学与东南大学联合提出的 AgentBrew 框架,试图打破这一死局。该方案放弃了对外部验证器和模拟器的依赖,仅凭单次采集的原始离线交互数据,便在三个真实的 MCP 复杂应用(GitHub、Not...