MegaMem:解耦超大长效记忆与生成证据,6.5亿Token下正确率达86.5%
来自埃默里大学因果动力学实验室(Causal Dynamics Lab, Emory University)的研究团队提出了名为 MegaMem 的超大上下文记忆检索系统,试图从根本架构上破除这一两难处境。其核心洞察在...
RAG
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
来自埃默里大学因果动力学实验室(Causal Dynamics Lab, Emory University)的研究团队提出了名为 MegaMem 的超大上下文记忆检索系统,试图从根本架构上破除这一两难处境。其核心洞察在...
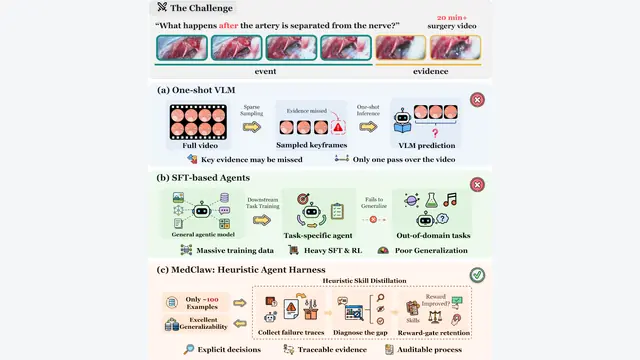
由北京交通大学、北京天坛医院、首都医科大学、西湖大学等机构联合提出的 MedClaw ,尝试通过一种完全不同的范式打破这一死锁。该系统提出了一个完全无需调整模型权重的 Agent 框架(Agent Harness),在...
研究者在此基础上提出了“对比消除”的设计。如果仅向模型灌输“打分器偏爱列表推导式而非 for 循环”,模型随后开始狂写列表推导式,实验者依然无法辨析模型是为了讨好打分器,还是产生了一种“既然打分器喜欢,那么用户大概也更...
韩国大邱庆北科学技术院(DGIST)的研究团队针对这一长期未解的痛点,提出了名为 LT-Mem 的易变性自适应时空记忆演进框架。该框架不把环境中的所有实体视为静态背景,也不对其进行无差别的纯文本历史流水账记录,而是建立...
从技术实现与应用落地来看,K-Bench 的结论向所有试图构建垂直科研智能体的从业者发出了一条清晰信号:当前通用大模型的基础底座,在面对非结构化现实需求时,依然缺乏严谨的自省与工程化定力。要在科研领域真正替代繁杂的体力...
针对这一长期困扰智能体进化的瓶颈,福州大学、香港理工大学、MemTensor、中国科学技术大学与西安交通大学等机构的研究人员提出了一种免训练的记忆与技能共进化治理框架——MSCE(Memory-Skill Co-Evo...
论文通过一个直观的例子揭示了这一机制如何瓦解系统的安全性:在一个自动化部署脚本中,包含一段用于清理构建残留的清理逻辑,其指令预设会根据环境变量 GITHUB WORKSPACE 理所当然地存在并指向代码仓库路径;然而在...
针对这一困境,研究团队提出了 EchoPath ——一种模型无关且环境无关的执行级可重放记忆框架。它不再将历史经验作为冗长的 Prompt 上下文喂回大模型,而是将经过终局验证的 GUI 执行轨迹提炼为标准化的“可调用...
然而,来自穆罕默德·本·扎耶德人工智能大学(MBZUAI)的一项最新研究提出了一个极具颠覆性的发现: 攻击者根本不需要诱导模型违背安全规则,也不需要模型在回复中吐出任何敏感词句,仅仅发送一组完全无害的普通提问,就能以极...
为此,研究团队提出了一种全新的系统级防御框架 FlowSeal。它不再指望大模型在同一个对话窗口里“既当裁判又当选手”,而是跳出模型上下文,在工具调用层构筑起基于数据溯源和信息流控制(Information Flow ...
为了全面覆盖机械工程设计流程,CADWorld 系统梳理了机械设计与制造领域的系统知识,构建了涵盖 11 个工作流类别的任务分类学(Taxonomy)。基准包含的 200 个任务覆盖了 183 个具体机械知识点。
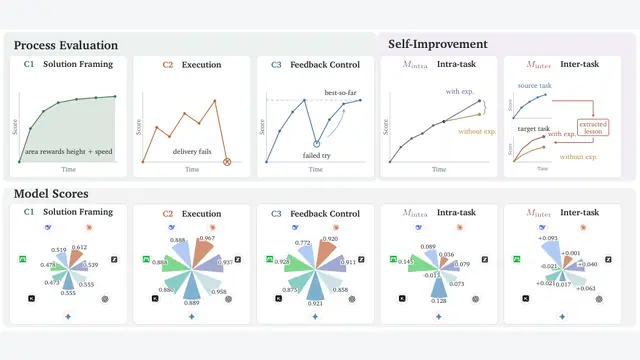
为了搞清楚研发过程中的增益与损失发生在何处,研究团队将 Agent 的研发闭环显式拆解为三大正交的能力维度: 1. 方案构想(Solution Framing, C1) :衡量模型在最开始能否提出合理、有潜力的优化假设。
为了精准刻画并探究这一瓶颈,阿里巴巴集团联合清华大学提出了面向通用移动智能体的高难度基准 GMA(General Mobile Assistants)。这项研究不仅构建了一个包含 7 款深度定制开源应用的多样化 And...
来自 Databricks 与马萨诸塞大学阿默斯特分校(UMass Amherst)的研究团队在最新论文中提出了一个截然不同的视角: 文档在进入检索系统前的表示形式,不应该是一成不变的预处理超参数,而应当被视作可优化的...
来自清华大学、北京大学、华中科技大学、美团、MBZUAI、上海交通大学和香港中文大学等机构的研究团队提出了 AutoDesign 框架。这项工作跳出了“微调底层多模态模型权重”的传统路径,而是引入了 元脚手架优化(Me...
来自耶鲁大学(Yale University)与 Sea12 Technologies 的研究团队在一篇最新论文中提出了基准测试 AlloBench ,首次系统评估了大语言模型在严格资源预算约束下的在线工具投资分配能力。
针对这一核心矛盾,Alaya Lab 提出了全栈开源的交互式长程视频世界模型 AlayaWorld 。该模型基于约 15B 参数的视频扩散 Transformer(DiT)骨干,能够在 540p 和 720p 分辨率下...
西北工业大学与清华大学的研究团队提出了 Act2Intention 框架,首次系统性地构建了覆盖“意图理解(Understanding) 意图预测(Prediction) 经验执行(Execution)”全链路的主动式...
为了验证这套设计准则在现实世界中的有效性,研究团队将 EffVLA 算法配方原封不动地迁移至低成本开源机械臂 SO-ARM101(6-DOF)上。在完全不改动动作头结构与推理配置的前提下,仅将预训练数据替换为该机械臂的...
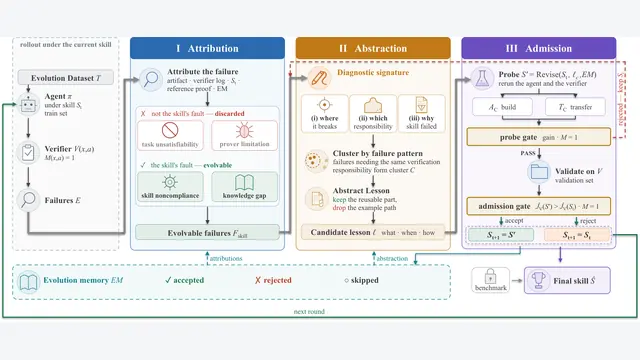
为了破解这一死局,研究团队提出了专门面向程序验证的技能自进化框架 VeriSkill 。它跳出了通用自进化框架“见错就改”的粗放范式,建立了一整套兼顾“归因诊断、抽象泛化与语义保真”的进化闭环:首先在责任归因中剔除环境...
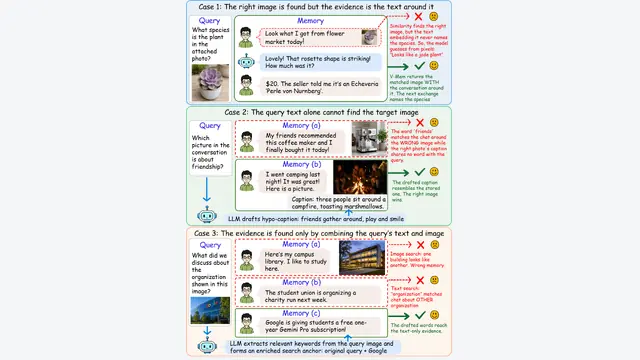
为此,研究团队提出了 V-Mem 。该框架放弃了在统一表征空间硬碰硬的暴力跨模态检索,转而通过轻量化的“模态路由”解耦多模态记忆管理。在极具挑战性的多模态长记忆基准 Mem-Gallery 上,V-Mem 斩获了 0....
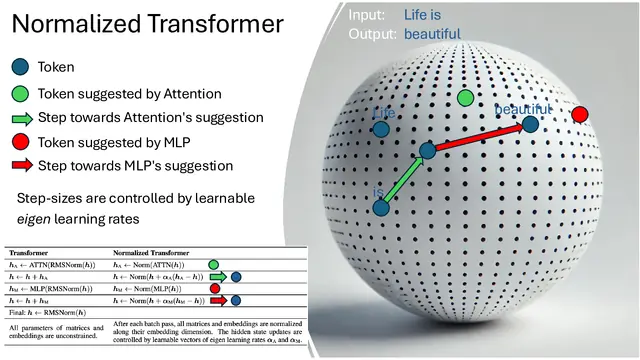
此前提出的归一化 Transformer(normalized Transformer,简称 nGPT)试图从几何根源解决该问题:将模型的所有参数矩阵与激活向量全部约束在单位超球面上,把前向传播直接重构成在超球面流形上...
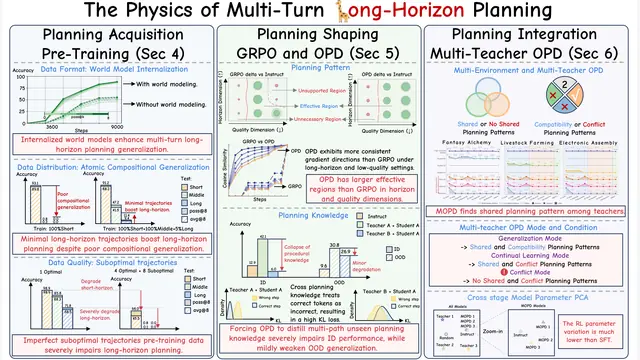
针对这一黑箱困境,中国科学院与中国科学院大学的研究团队提出了系统剖析多轮长程规划“底层物理学”(Physics of Multi-Turn Long-Horizon Planning)的分析框架。
来自伊利诺伊大学厄巴纳-香槟分校(UIUC)的研究团队提出了一种兼具轻量与强悍特性的推理时干预方案: V-Steer 。该方法完全免微调(Training-Free),不修改任何模型参数,仅在 Prefill 阶段针对...