FlashDrive:打破VLA四级瓶颈,10B自动驾驶大模型提速4.7倍跨入实用门槛
针对这一核心痛点,研究团队提出了名为 FlashDrive 的算法-系统协同优化框架。FlashDrive 并没有大动干戈去重构模型底座,而是针对流水线中四个阶段的具体冗余。
具身智能多模态&视觉
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
针对这一核心痛点,研究团队提出了名为 FlashDrive 的算法-系统协同优化框架。FlashDrive 并没有大动干戈去重构模型底座,而是针对流水线中四个阶段的具体冗余。
他们提出了 FACT(Failure-Aware Causal Training)框架,打破了“先脑补未来、再倒推动作”的定势,颠倒为“先决策动作、再因果推演未来与任务进展”。
卡耐基梅隆大学(Carnegie Mellon University, CMU)机器人研究所的研究团队针对这一系列瓶颈,推出了全新的协同多智能体闭环评测基准 CMU-Drive ,并提出了首个将协同感知、语言推理与动作...
针对这一困境,来自蚂蚁集团、清华大学、明尼苏达大学和浙江大学的研究团队提出了一套名为 HARD (Harness-based Autonomous Runtime Defense Evolution)的自演化运行时防御框架。
为了彻底终结“以代码能否运行来衡量科研真伪”的评估偏见,研究团队提出了名为 ABE-Ralph 的全自动科学审计框架。该框架将科学复现与验证形式化为一个带有资源上限的 约束满足问题 (Constraint Satisf...
Ant:作者将这一现象形式化为 奖励公平性问题(Reward Fairness Problem) ,并提出了系统性的解决方案 ARC(Advantage Regularization via Conditioning) 。
来自蚂蚁集团、普林斯顿大学与斯坦福大学的研究团队在最新论文中给出了截然不同的解法,他们提出了名为 AQuA (Recursively Self-Improving Quantitative Trading Resear...
为此,研究团队提出了完全免训练的长程记忆框架 WorldTrace ,以及专门用于评估场景回访一致性的基准测试 LoopBench 。在不改变原有模型权重、不增加显存峰值的前提下,WorldTrace 实现了 15.5...
然而实验结果显示,模型的指令遵循率不足 1%。即便面临违规惩罚,大模型依然顽固地使用英语枢纽来拆解任务。这解释了那近 30% 的策略丢失从何而来:非英语语种被迫引入的翻译转换步骤、由翻译不准确诱发的二次重试、以及从非英...
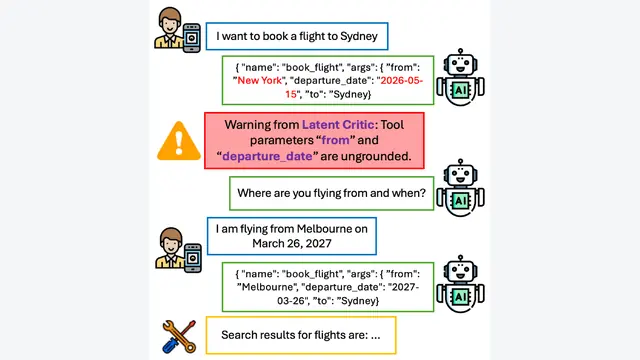
针对这一核心痛点,Samsung Research America 的研究团队提出了 Latent Critic 架构。该方案并没有引入庞大的外部检查模型,而是通过一个与冻结基座模型并行推理的轻量级低秩适配器(LoRA)。
破局的关键,在于提出了类似网络协议分层思想的 Agent Task Protocol(ATP)。在 Task Layer 中,ATP 抽象出了四类核心标准对象:TaskInput、AgentBinding、AgentR...
为了穿透这种“正确性的幻觉”,两位研究者提出了一套契约级验证器(Contract-Grade Verifier),并设定了 12 道对抗性的测试门禁。当这套工具对准知名开源体系 Dr. Kernel / KernelG...
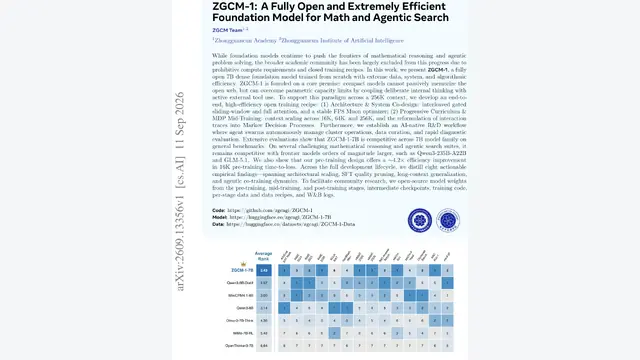
凭借这一范式与多项系统级协同设计,ZGCM-1-7B 在 16K 预训练中实现了约 4.2 倍的训练效率提升(Time-to-loss),支持原生 256K 上下文,并在数学推理与复杂 Agent 搜索基准上。
复旦大学与上海市数据科学重点实验室的研究团队提出了名为 HarnessLens 的自演进框架。该框架打破了传统自优化方案“大水漫灌”式的评测逻辑,提出以“行为感知验证”(Behavior-Aware Verificat...
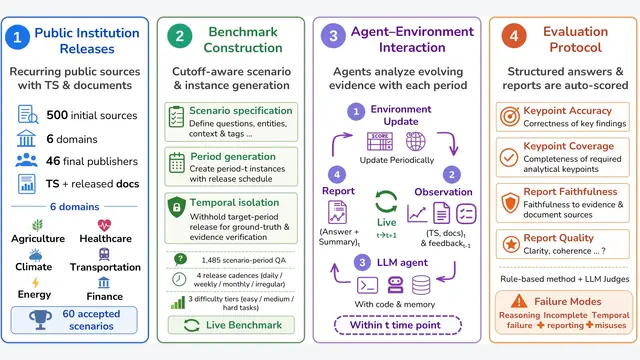
TimeSage-EV:目前大模型社区在时序理解上的评测,大多遵循类似 ChatTime-TSQA 或 TSRBench 的思路:给定一段历史数值曲线,向模型提出几个关于极大值、极小值、平均趋势或简单周期的定点问题。另...
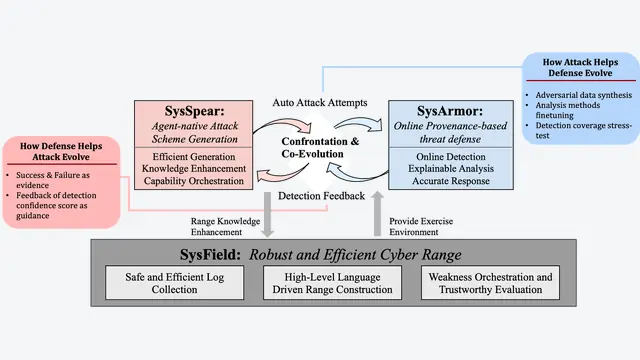
为了打破这一困局,研究团队提出了首个 AI 原生、安全且自主的攻防共进化系统 SysEvolve 。该系统通过协同设计的靶场平台 SysField 、自主攻击系统 SysSpear 和实时防御系统 SysArmor ,...
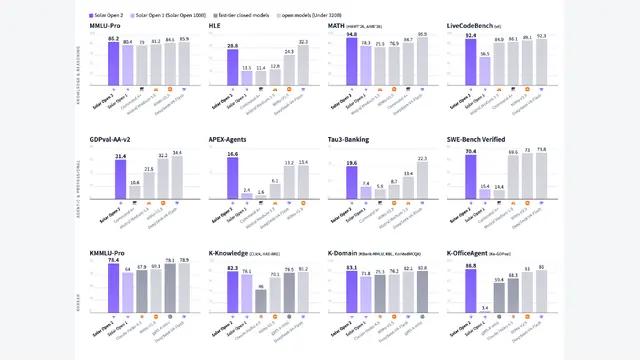
Solar Open 2 提出了一种名为“选择性权重迁移”(Selective Weight Transfer)的热启动策略,打破了传统认知中“架构大幅改变必须从头预训练”的铁律。模型上一代版本 Solar Open ...
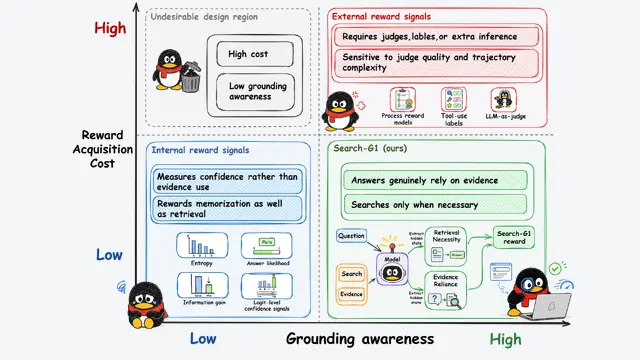
针对这一瓶颈,腾讯与复旦大学的研究人员在论文《Search-G1: Grounded Search Agents via Representation-Based Intrinsic Rewards》中提出了 Sear...
针对这一瓶颈,中国科学院与中国科学院大学的研究团队提出了 SciDSK(Scientific Data Skill,科学数据技能) 框架。这项工作的核心构想十分巧妙:不再试图去重构现有的底层数据仓储,也不把数据集当作笨...
针对这一隐蔽威胁,研究团队同时提出了一种无需调用大模型、零推理开销的输入端防御策略——显著性归一化(Salience Normalization),成功将攻击率压制至 15.3%。传统 RAG 系统在处理知识密集型问答...
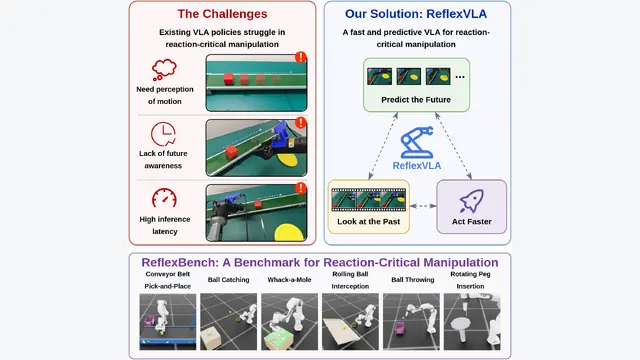
研究包含两项核心成果:一是提出专门解耦环境推进与控制计算的动态评测基准 ReflexBench ,支持在同步与异步模式下精准注入真实物理延迟;二是构建了参数量不足 1B 的紧凑型模型 ReflexVLA 。
来自清华大学、中国科学院、Shopee、北京工业大学和东南大学等机构的研究团队,将这种认知直觉转化为一种原生的后训练框架,提出了 OmniReasoner 。该工作不再执着于通过无限扩展上下文窗口去强行“硬吞”全部音视...
我们往往在对方话音未落时就已经开始在大脑中构建回应,在开口陈述当前句子的同时构思下一句表达,即使中途被打断也能迅速吸收新信息并调整思路。然而,当下绝大多数基于大语言模型(LLM)构建的语音智能体(Voice Agent...
针对这一长期被忽视的痛点,来自中国科学院(CAS)、Memorax AI 等机构的研究团队提出了 MemChain 。这项工作颠覆了“检索后直接喂给模型”的粗放模式,首次在检索与回答生成之间引入了一个独立的可训练“检索...