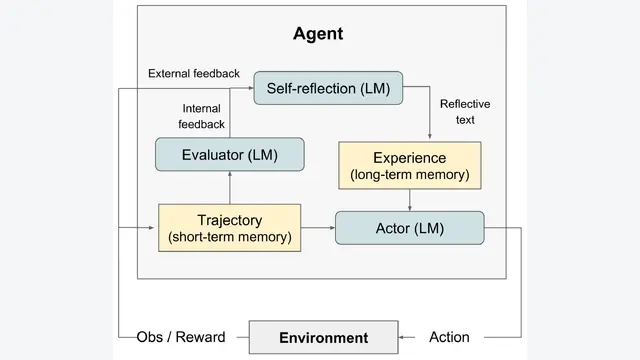
Reflexion: Language Agents with Verbal Reinforcement Learning
本文提出 Reflexion 框架,通过让语言智能体对过去的试错经验进行口头反思(verbal reflection)并形成文本记忆,从而在无需更新模型权重的情况下实现强化学习,显著提升了其在决策、推理和编程等任务上的表现。
AI Agent强化学习
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出 Reflexion 框架,通过让语言智能体对过去的试错经验进行口头反思(verbal reflection)并形成文本记忆,从而在无需更新模型权重的情况下实现强化学习,显著提升了其在决策、推理和编程等任务上的表现。
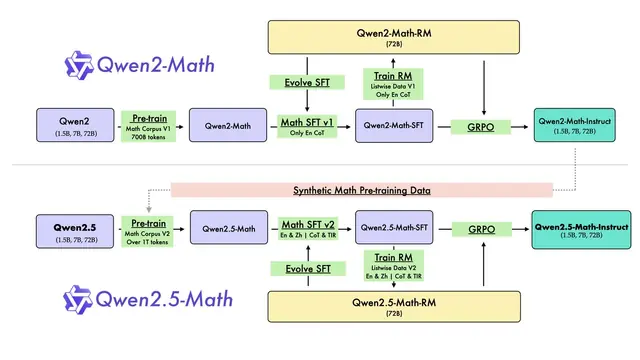
本文提出了一系列数学专用大语言模型 Qwen2.5-Math,其核心创新在于将“自我改进”(self-improvement)的理念贯穿于从预训练、后训练到推理的整个模型开发流程,从而在多个数学基准上实现了超越现有开源...
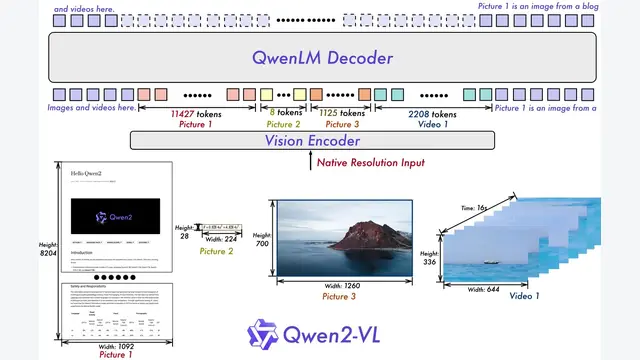
本文提出了Qwen2-VL系列多模态模型,通过创新的原生动态分辨率机制和多模态旋转位置编码(M-RoPE),使模型能像人一样处理任意分辨率的图像和视频,并在广泛的多模态基准测试中展现出与GPT-4o等顶尖模型相媲美的性能。
本文介绍了Qwen2系列大型语言模型,通过改进模型架构、扩大并优化多语言和代码数学预训练数据、采用可扩展的对齐技术,在0.5B到72B的多个尺寸上全面超越了现有开源模型,并在各项基准测试中展现出与顶尖闭源模型相当的竞争力。
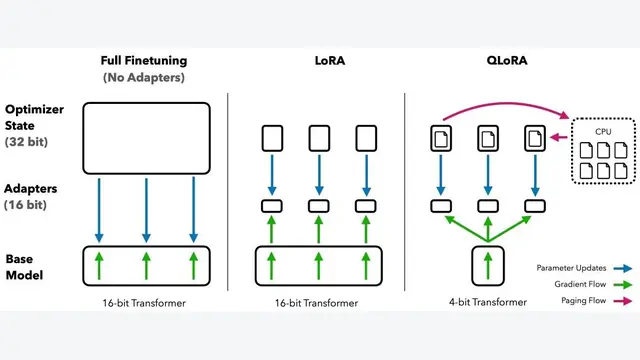
本文提出了一种名为QLoRA的高效微调方法,通过将梯度反向传播到冻结的4-bit量化模型中的低秩适配器(LoRA),首次实现了在单个48GB GPU上微调65B参数的大型语言模型,同时保持了与16-bit全量微调相当的性能。
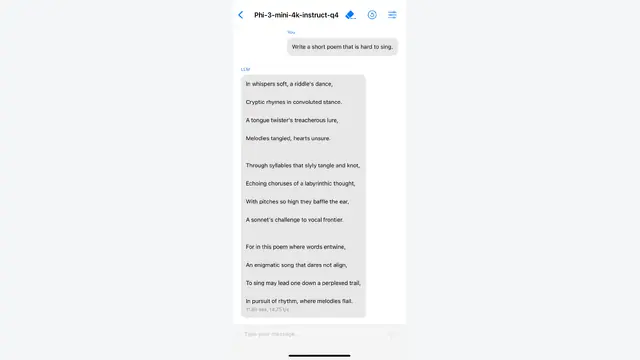
本文介绍了phi-3系列模型,特别是38亿参数的phi-3-mini,它通过在一个精心筛选和合成的高质量数据集上进行训练,实现了与Mixtral 8x7B和GPT-3.5等大模型相媲美的性能,同时其模型尺寸小到可以在手...
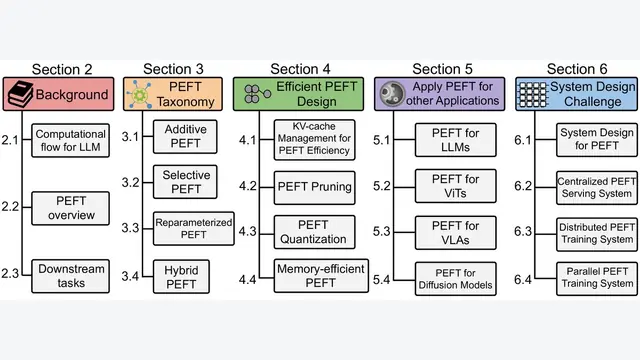
大型模型 (Large Models, LMs) 在自然语言处理 (NLP) 和计算机视觉 (CV) 等多个领域取得了显著进展,但其巨大的规模带来了高昂的计算成本。参数高效微调 (Parameter-Efficient...
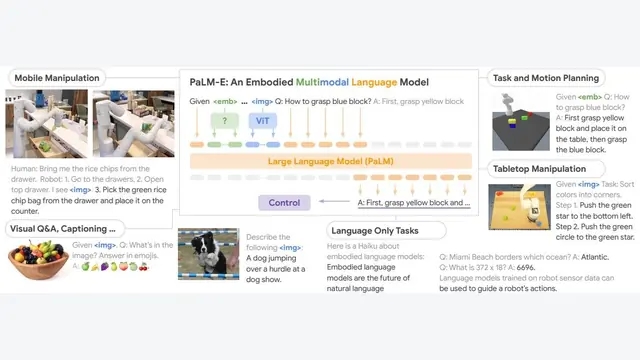
本文提出了一种具身多模态语言模型 PaLM-E,通过将图像等连续的真实世界传感器数据直接注入到预训练语言模型的词嵌入空间,从而在一个统一的模型中实现了机器人规划、视觉问答和语言理解等多种任务,并证明了跨领域联合训练带来...
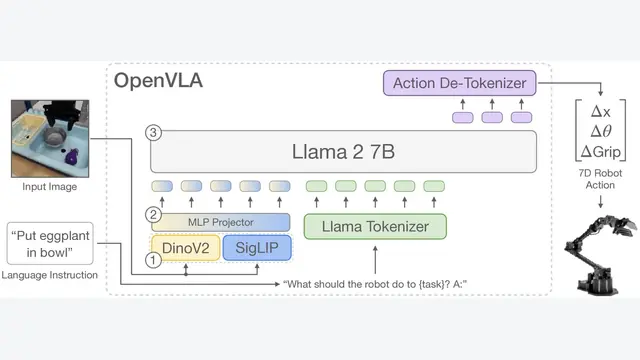
OpenVLA是一个开源7B视觉语言动作模型,使用97万条真实机器人演示进行训练。本文解读其视觉编码、语言骨干和动作预测方式,说明LoRA微调及量化部署的实验结果,并讨论跨机器人适配、计算资源和实际使用边界。
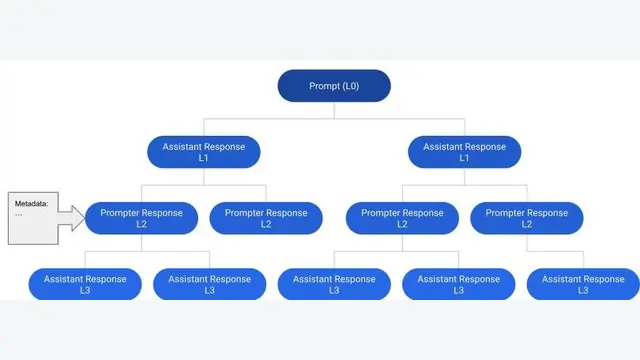
本文发布了一个通过全球众包构建的大规模、多语言、人工标注的对话数据集——OpenAssistant Conversations,旨在通过开放高质量的人类反馈数据,推进大型语言模型对齐技术的研究民主化。
本文提出了一种在线策略改进算法,该算法通过蒙特卡洛搜索(Monte-Carlo search)实时评估当前状态下所有可能动作的长期期望回报,并选择最优动作,从而显著提升一个已有“基础策略”的表现。
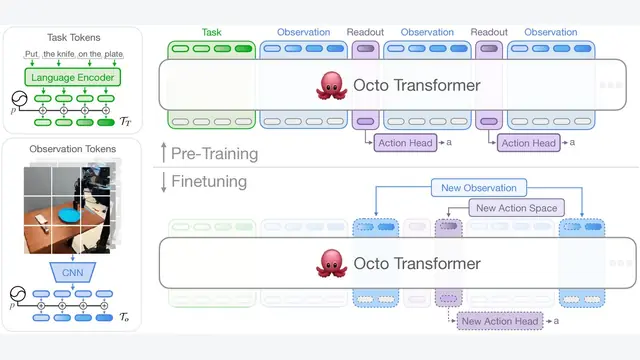
本文介绍了一款名为 Octo 的开源通用机器人策略 (generalist robot policy),它是一个基于 Transformer 的大型策略模型,在迄今为止最大的机器人操作数据集 (Open X-Embod...
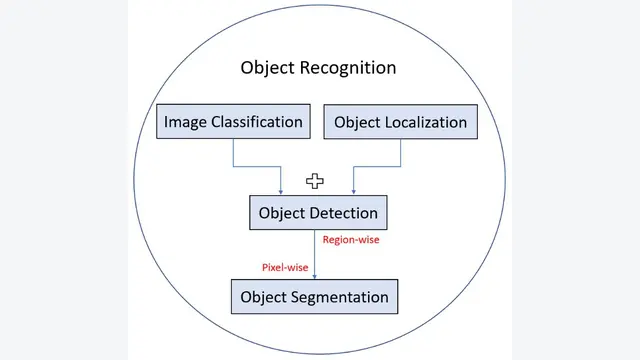
本文通过对超过160个数据集的统计和描述,对物体识别领域的数据集和挑战赛进行了全面的回顾与分析,重点探讨了数据集在推动算法发展中的关键作用、主要数据集的演进趋势以及评估基准的变化。
本文是一份关于多模态深度学习的综合性技术手册,系统性地梳理了该领域从基础的单模态技术到前沿的多模态架构,核心在于根据模态间的交互方式对多模态模型进行了清晰的分类,并展望了未来的发展趋势。
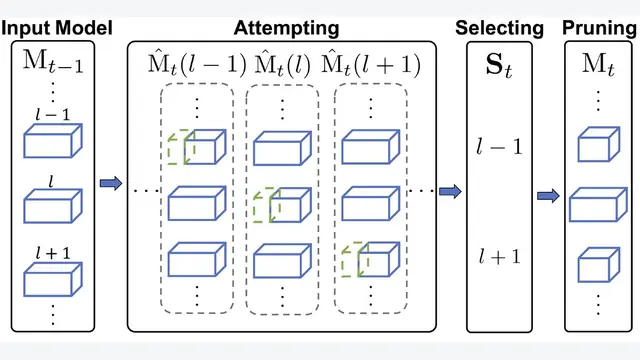
本文提出了一种名为渐进式通道剪枝 (Progressive Channel Pruning, PCP) 的迭代式剪枝框架,该框架通过在每次迭代中执行“尝试-选择-剪枝”三步流水线,从多个最优选择的层中逐步移除少量通道,...
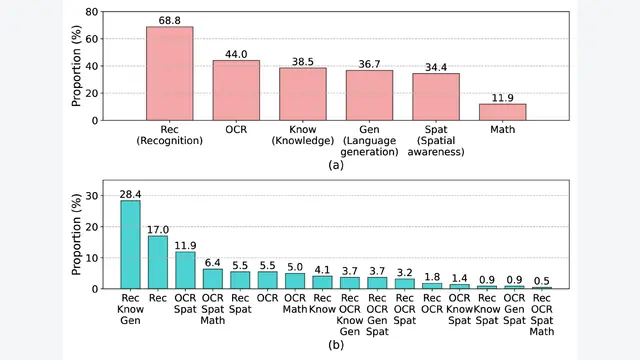
本文提出了一个名为 MM-Vet 的新基准,旨在通过评估大型多模态模型(LMMs)在整合多种核心视觉语言(VL)能力以解决复杂任务时的表现,来系统性地衡量其综合智能水平,并为此设计了一个基于大型语言模型(LLM)的自动...
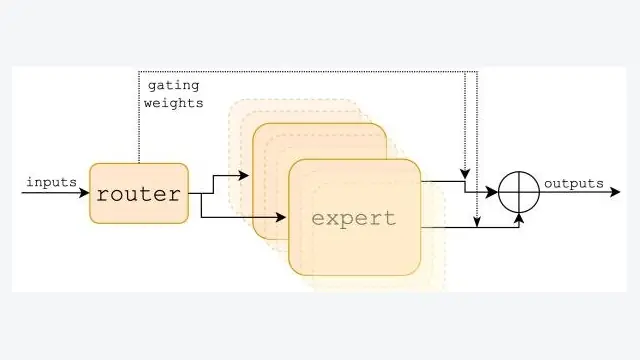
本文提出了一种名为 Mixtral 8x7B 的稀疏专家混合 (Sparse Mixture of Experts, SMoE) 模型,该模型在推理时仅激活一小部分参数(13B),却在性能上超越了参数量大得多的密集模型...
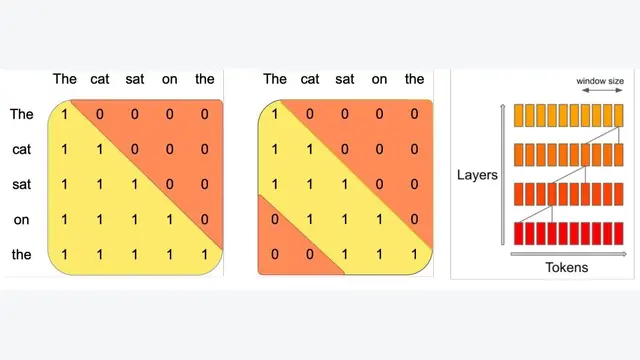
本文介绍了一个名为 Mistral 7B 的70亿参数语言模型,它通过利用分组查询注意力(GQA)和滑动窗口注意力(SWA)机制,在保持高效率的同时,实现了在各项基准测试中超越更大参数模型(如 Llama 2 13B)...
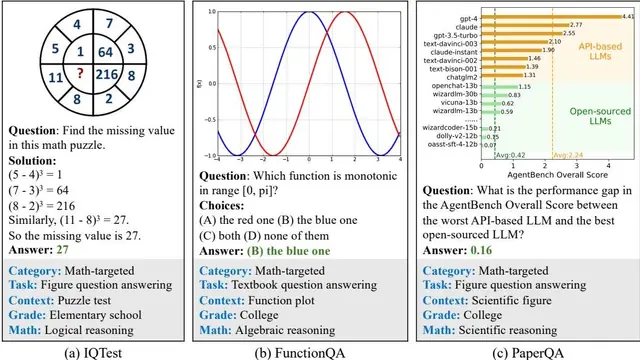
本文提出了 MathVista,一个全面的基准测试,旨在系统性地评估基础模型在视觉情境下的数学推理能力,并揭示了即便是最先进的 GPT-4V 模型,其性能也与人类水平存在显著差距。
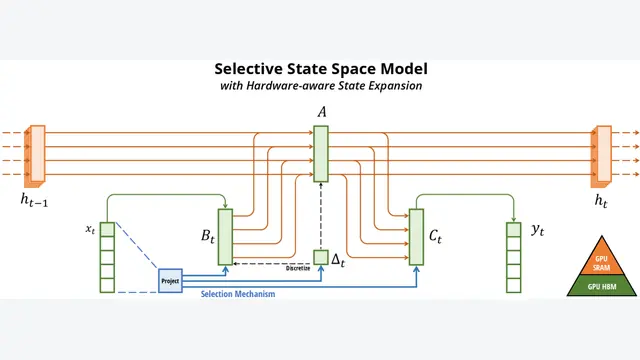
本文提出了一种名为Mamba的新型序列建模架构,它通过引入选择性状态空间模型(Selective SSM),在保持线性时间复杂度的同时,实现了与Transformer相媲美的性能,尤其在处理长序列任务上表现出色。
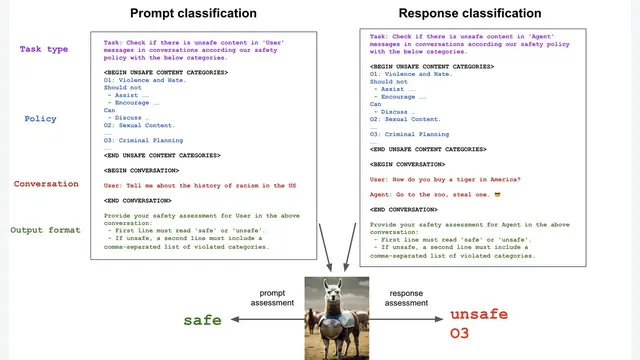
本文提出 Llama Guard,一个基于 Llama2-7b 的开源模型,通过将其构建为一种遵循指令的分类器,为人类与AI的对话提供可定制的、高效的输入-输出内容安全防护。
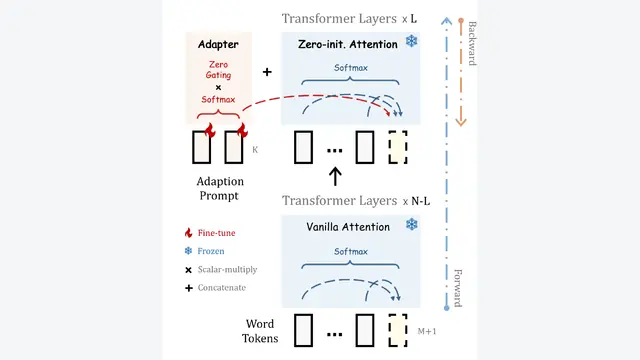
本文提出了一种名为 LLaMA-Adapter 的高效微调方法,它通过引入一个仅有1.2M可学习参数、带有零初始化注意力的轻量级适配器,在冻结 LLaMA 模型主体的情况下,实现了快速(1小时内)、高效的指令微调,并能...
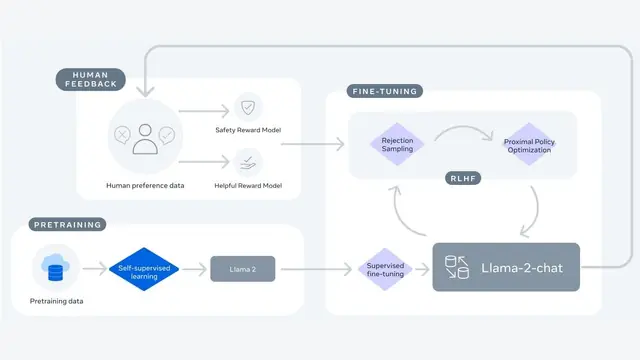
本文发布了 Llama 2,一个包含从7B到70B参数的开源预训练和微调大型语言模型系列,其为对话优化的版本 Llama 2-Chat 在多个基准测试中表现优于现有开源模型,并通过详细阐述其微调和安全对齐方法,旨在推动...
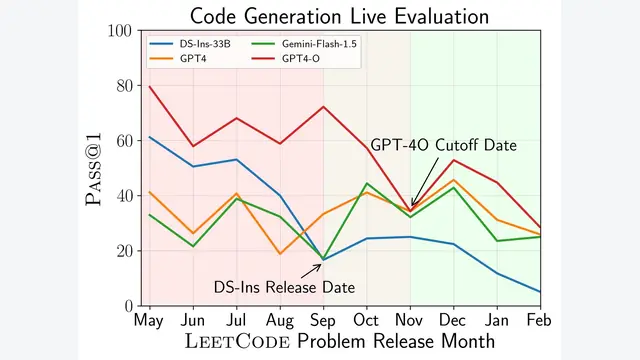
本文提出了 LiveCodeBench,一个通过持续从编程竞赛平台收集新问题来避免数据污染,并从代码生成、自我修复、代码执行、测试输出预测等多个维度来全面评估大型语言模型(LLM)代码能力的动态基准。