GPQA: A Graduate-Level Google-Proof Q&A Benchmark
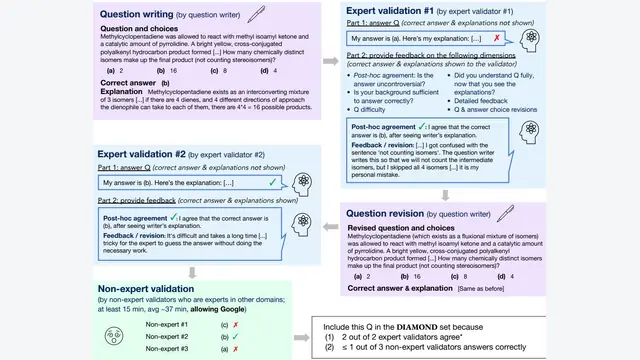
本文提出了 GPQA,一个包含448道由生物、物理和化学领域专家编写的研究生水平多项选择题数据集,其设计目标是“防谷歌化”(Google-Proof),即对于拥有不受限制网络访问权限的熟练非专家来说也极其困难,旨在为未...
AI评测
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了 GPQA,一个包含448道由生物、物理和化学领域专家编写的研究生水平多项选择题数据集,其设计目标是“防谷歌化”(Google-Proof),即对于拥有不受限制网络访问权限的熟练非专家来说也极其困难,旨在为未...
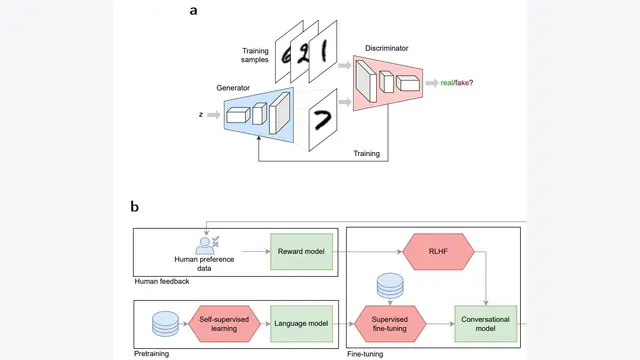
Generative AI。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
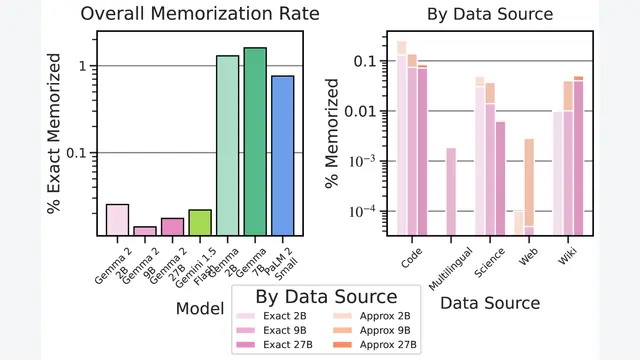
本文介绍Gemma 2系列开放语言模型(2B、9B、27B),通过在Transformer架构中交错使用局部-全局注意力、采用分组查询注意力,并对2B和9B模型应用知识蒸馏进行训练,实现了在同等参数规模下的最佳性能,甚...
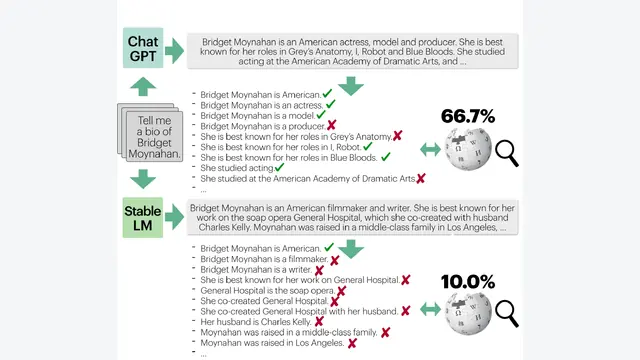
本文提出了一种名为 FActScore 的新评估指标,通过将长文本分解为一系列原子事实并计算由可靠知识源支持的事实比例,来精细化地衡量语言模型生成内容的事实准确性,同时还开发了一个自动化模型来低成本、大规模地估算此分数。
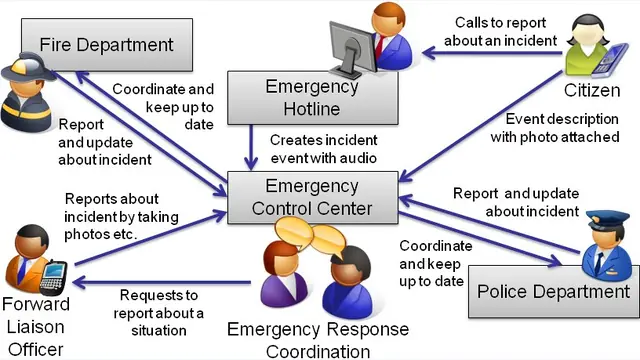
本文提出了一种名为 Event-Model-F (F) 的事件形式化模型,该模型基于 foundational ontology (基础本体) DOLCE+DnS Ultralite (DUL),通过一种模式驱动的方法...
解释预测中最近邻方法的成功。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
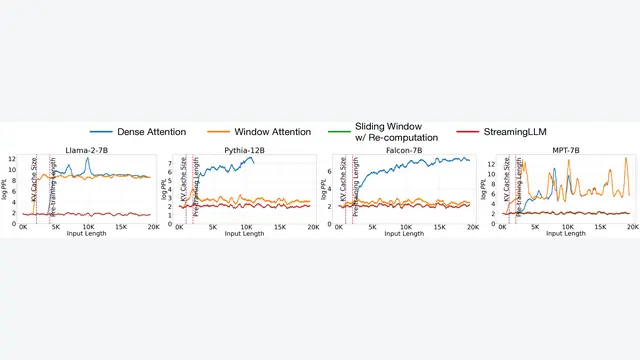
本文提出了一种名为 StreamingLLM 的高效框架,通过保留少量初始 Token 作为“注意力池 (Attention Sinks)”来稳定注意力分布,从而使预训练好的大语言模型无需微调即可处理无限长的流式输入。
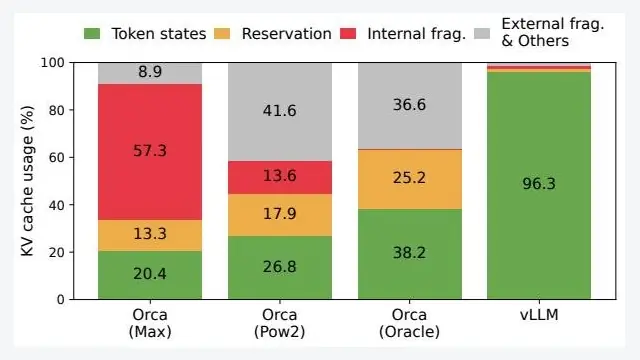
本文提出 PagedAttention,一种受操作系统虚拟内存和分页机制启发的注意力算法,通过将键值缓存(KV Cache)划分为非连续的内存块进行管理,解决了大型语言模型(LLM)服务中因内存碎片化和无法共享而导致的...
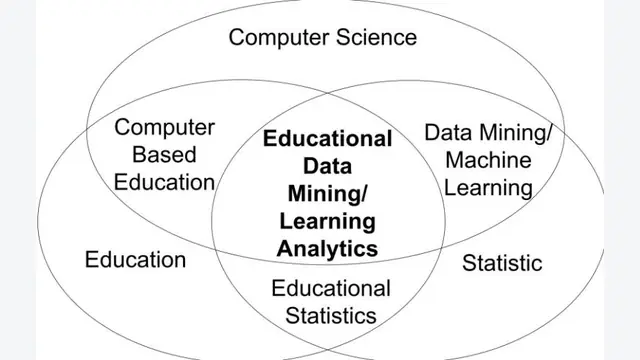
本文是一篇关于教育数据挖掘(EDM)和学习分析(LA)领域的更新版综述,系统性地回顾了该领域的关键术语、发展历程、知识发现流程、主要应用环境、方法论、工具集以及未来发展趋势,旨在为研究人员和实践者提供一份全面的最新知识图谱。
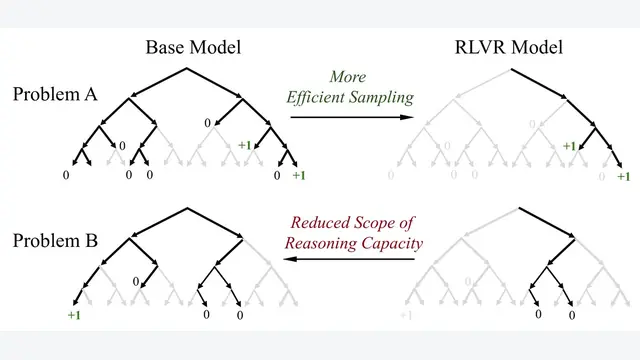
通过系统性地使用大 值的 指标进行评估,本文发现当前的带可验证奖励的强化学习(RLVR)方法并未赋予大语言模型超越其基础模型的新推理能力,而仅仅是提升了对基础模型已有能力的采样效率,甚至可能缩小了模型的推理范围。
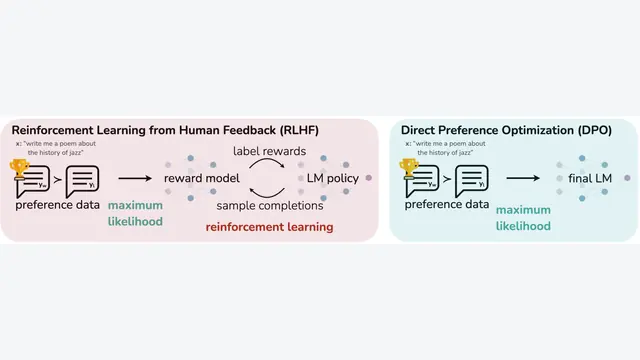
本文提出了一种名为直接偏好优化(DPO)的新算法,它通过一个解析性的映射关系,将传统强化学习中带约束的奖励最大化问题,巧妙地转化为一个简单的分类损失函数,从而无需显式训练奖励模型或进行复杂的强化学习,就能高效地使语言模...
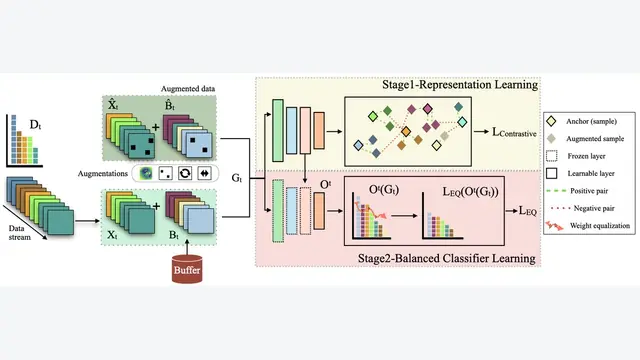
本文提出了一种名为 DELTA 的解耦学习框架,通过两阶段训练策略(监督对比学习 + 均衡损失)有效解决了长尾在线持续学习(Long-Tailed Online Continual Learning, LTOCL)中的...
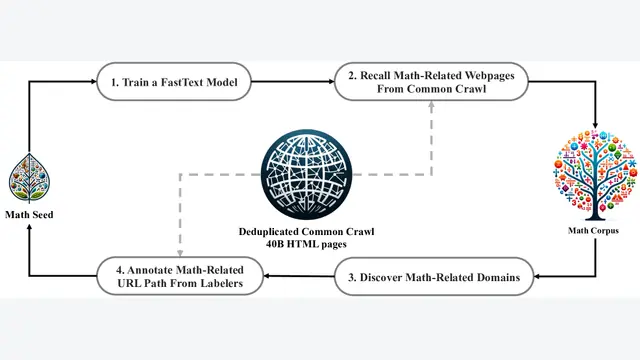
本文介绍了DeepSeekMath,一个通过在精心构建的120B数学语料上进行持续预训练,并采用一种名为GRPO的新型高效强化学习算法,从而将开源模型的数学推理能力推向接近GPT-4水平的7B语言模型。
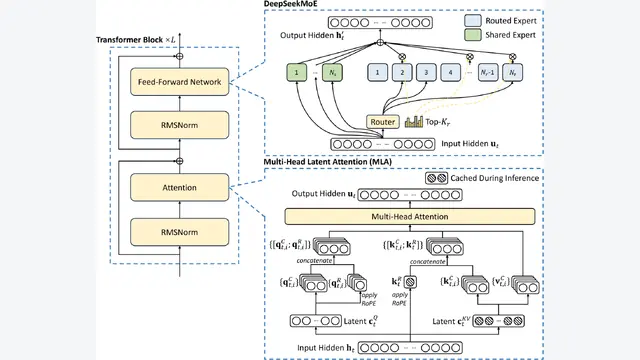
本文提出了一种名为 DeepSeek-V3 的671B参数的强混合专家(MoE)模型,它通过创新的无辅助损失负载均衡策略、多Token预测训练目标以及高效的MLA和DeepSeekMoE架构,以极高的训练效率和经济成本...
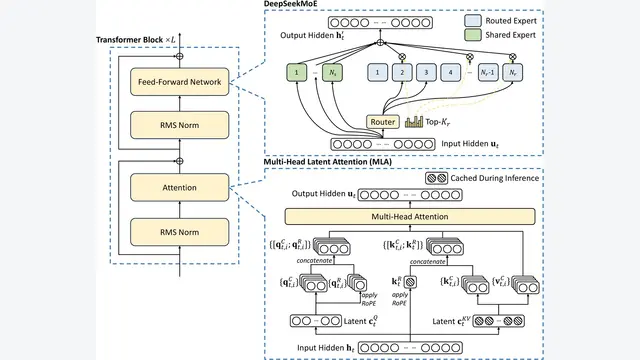
本文提出了一种名为DeepSeek-V2的强混合专家(MoE)语言模型,该模型通过创新的多头潜在注意力(MLA)和DeepSeekMoE架构,在实现顶尖性能的同时,显著降低了训练成本并提升了推理效率。
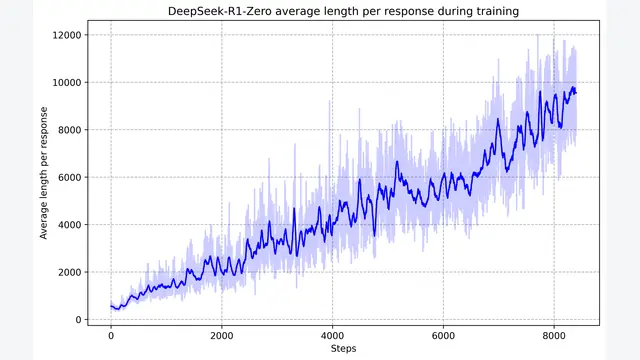
本文通过大规模强化学习(无论是纯粹应用于基础模型还是结合少量冷启动数据),成功地激发并显著增强了大型语言模型的推理能力,推出了DeepSeek-R1系列模型,并验证了可以将这种高级推理能力通过蒸馏有效地迁移到更小的模型中。
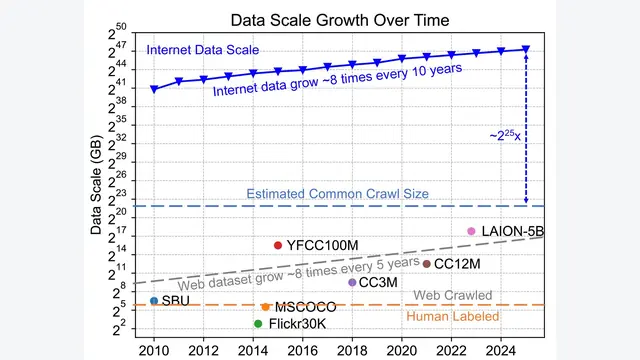
本文提出了一种名为 InfoGrowth 的高效在线算法,通过实时评估数据流中每个数据点的噪声和冗余度,动态地清洗和选择信息量高的数据,以实现高质量数据集的持续、高效增长。
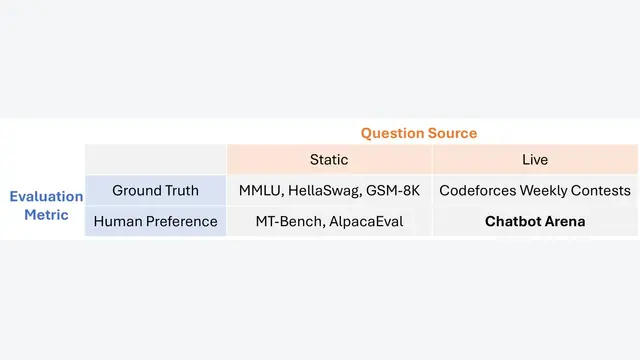
本文介绍并验证了一个名为 Chatbot Arena 的开放平台,该平台通过众包用户的成对比较和偏好投票,来评估和排名大型语言模型(LLM),并为此设计了一套高效、可靠的统计方法论。
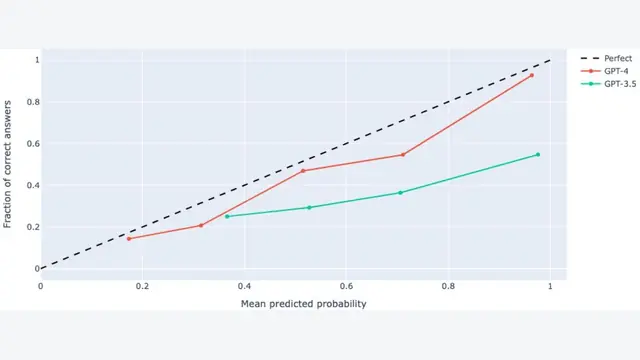
本文通过对美国行医执照考试(USMLE)等权威医学基准的全面评测,表明通用的GPT-4模型在未经任何领域专业化微调的情况下,其医学知识水平和推理能力已远超之前的通用模型(GPT-3.5)和医学专用模型(Med-PaLM...
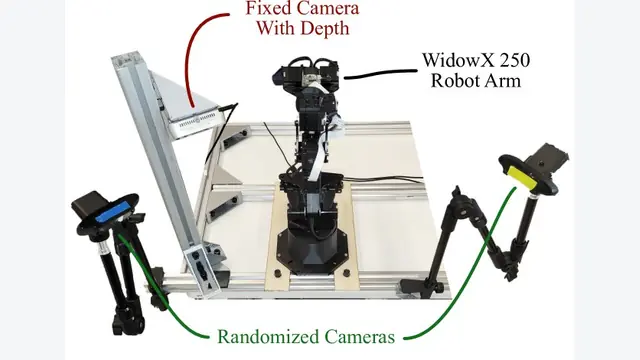
本文介绍了 BridgeData V2,一个大规模、多样化的机器人操作行为数据集,旨在推动可扩展机器人学习的研究。该数据集包含在24个环境中、使用一个公开可用的低成本机器人收集的超过6万条轨迹,并证明了其能够支持多种主...
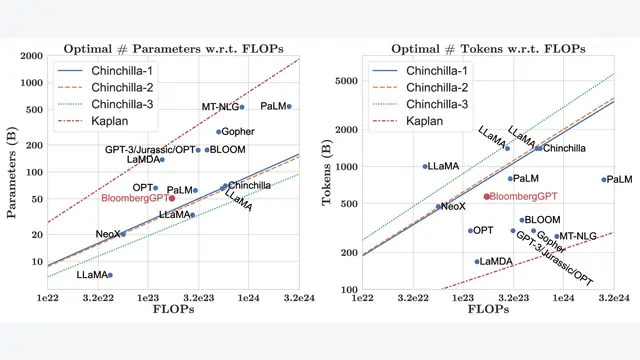
本文提出了一种为金融领域专门打造的500亿参数大型语言模型——BloombergGPT,它通过在一个包含大量高质量金融数据和通用数据的混合数据集上进行训练,在金融领域的任务上取得了远超现有模型的性能,同时在通用LLM基...
大型语言模型 (Large Language Models, LLMs) 的崛起已从根本上改变了语言技术。然而,这些模型在取得巨大成功的同时,也可能会学习、延续并放大有害的社会偏见,这些偏见源于不平衡的社会群体表征、刻...
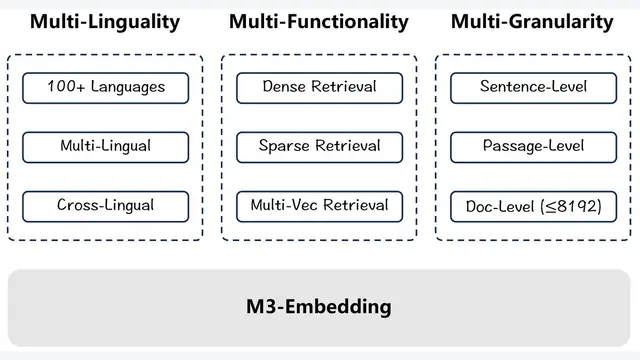
BGE-M3以自知识蒸馏统一多语言、多功能和多粒度文本嵌入,兼顾不同长度文本的检索需求。本文解读其训练框架、稠密检索、稀疏检索和多向量检索的协同方式,并说明实验设置、检索效果及适用边界。
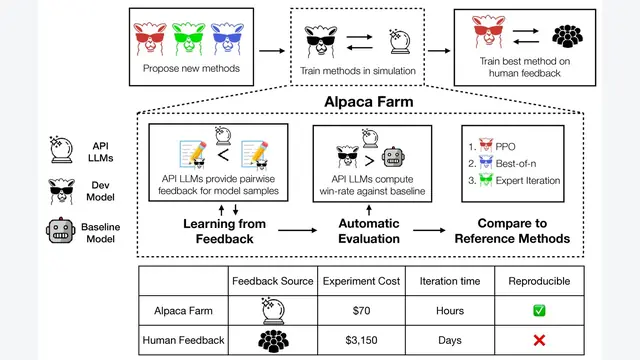
本文提出了AlpacaFarm,这是一个旨在使用大型语言模型(LLM)模拟人类反馈,从而以低成本、高效率地研究、开发和评估人类反馈学习方法的仿真框架。