Reinforcement Learning Improves Traversal of Hierarchical Knowledge in LLMs
告别“对齐税”!Meta新研究:RL将LLM变身知识导航员,分层知识检索飙升24%。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
强化学习
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
告别“对齐税”!Meta新研究:RL将LLM变身知识导航员,分层知识检索飙升24%。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
Agent智能进化论:阿里港科大万字综述,揭秘GEF三步循环。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
AI标注成本直降90%!字节ACT框架:让大模型学会「批判性思维」。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
AI算力新范式:斯坦福提出“每瓦特智能”,本地模型能效两年提升5.3倍!。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
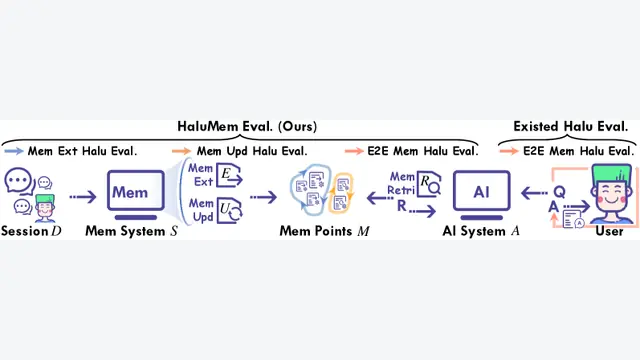
AI Agent记忆也“幻觉”?HaluMem:首个记忆系统“CT扫描”基准,精准定位错误根源。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
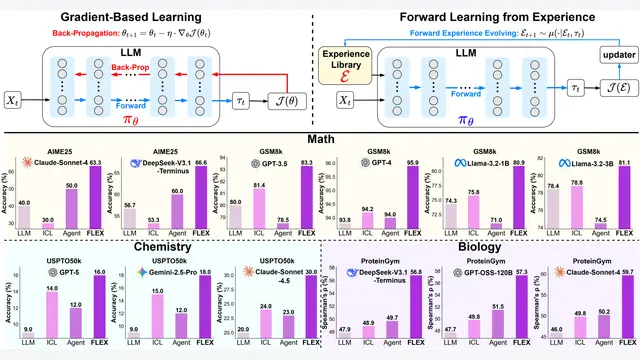
让AI像人一样“吃一堑长一智”:FLEX框架使Agent性能飙升23%。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
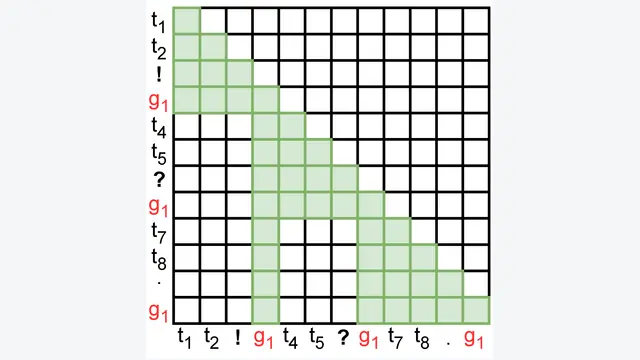
LLM长文本“瘦身”8倍:新方法让模型按“句”读取,性能几乎无损。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
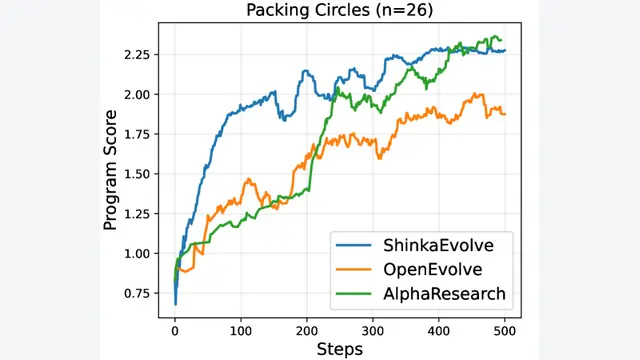
AI当上科学家:字节跳动AlphaResearch,8项难题2次击败人类专家。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
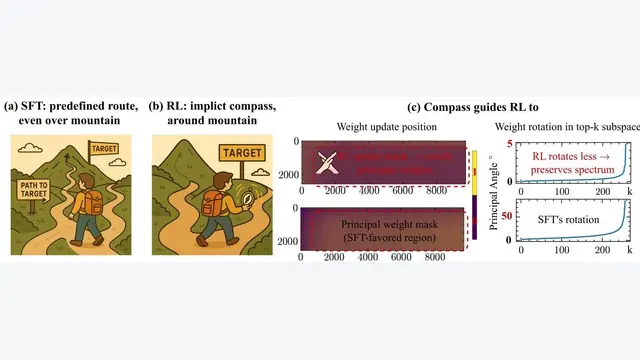
强化学习“另辟蹊径”:避开90%关键参数,模型推理能力竟能大幅提升。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
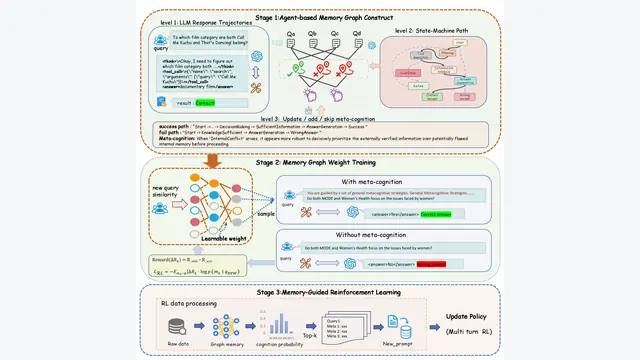
让Agent经验“活”起来:可训练图记忆,助小模型性能飙升25.8%!。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
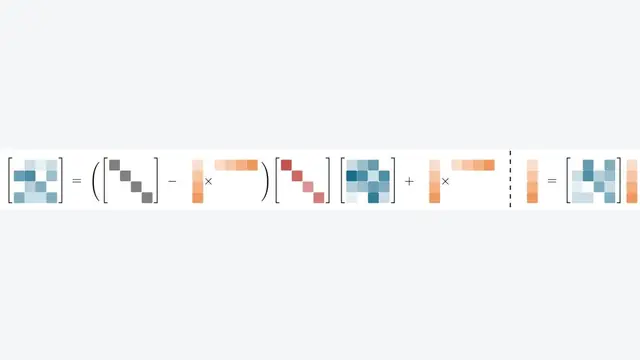
KimiLinear揭秘:首次全面超越全注意力,1M上下文解码提速6倍!。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
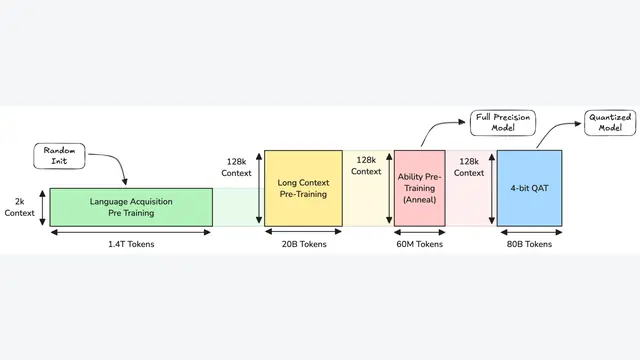
Meta MobileLLM-Pro:10亿参数手机模型称王,四大创新超越Gemma与Llama 3.2。
让大模型学会“专注”:AWS发布Focal Attention,参数减42%,长文本性能飙升82%!
本文提出了一种基于收缩估计 (shrinkage estimators) 的新型基线 (baseline) 方法,通过在统计上更优地结合单个提示 (per-prompt) 和跨提示批次 (across-prompt) ...
Sampling and Loss Weights in Multi-Domain Training。
Rethinking Retrieval-Augmented Generation for Medicine: A Large-Scale, Systematic Expert Evaluation and Pract...
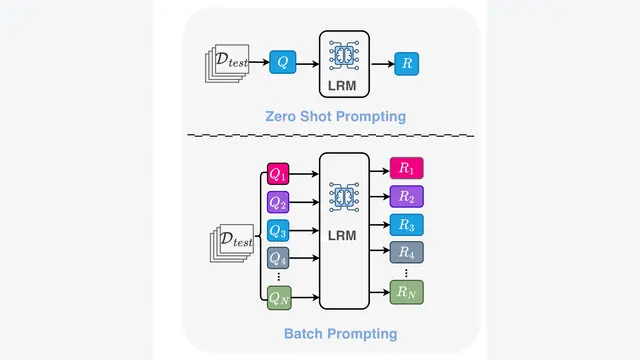
本文发现,批处理提示 (Batch Prompting) 不仅能摊销推理成本,还能作为一种有效的推理时正则化器,抑制大型推理模型(LRM)的“过度思考”行为,从而在保持精度的同时大幅减少推理Token消耗。
本文通过一项在受控环境中进行的系统性实证研究发现,现有的模型编辑方法在更新代码大语言模型(code LLMs)以适应API演进时,表现出有限且不稳定的适应能力,普遍导致模型性能显著下降,且多数成功案例依赖变通方案而非真...
本文解读《LLM-as-a-Judge: Toward World Models for Slate Recommendation Systems》,梳理核心方法、关键实验结果与工程实践启示。
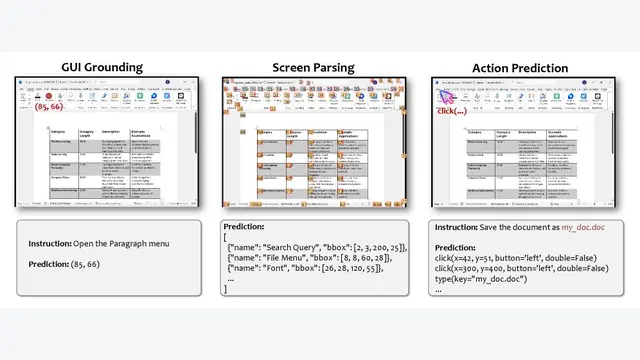
本文提出 GUI-360,一个用于推进桌面级计算机使用智能体(CUA)的大规模、综合性数据集与基准测试套件,它通过一个由 LLM 增强的高度自动化流程构建,旨在解决真实世界任务稀缺、数据收集标注困难、以及缺乏统一基准的...
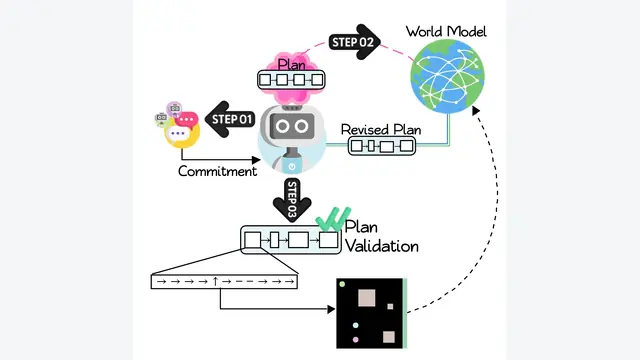
本文提出了DR. WELL,一个去中心化的神经符号框架,该框架通过结构化的协商协议和动态演化的符号世界模型,使基于大语言模型(LLM)的具身智能体能够高效地进行协作规划、学习与自我优化。
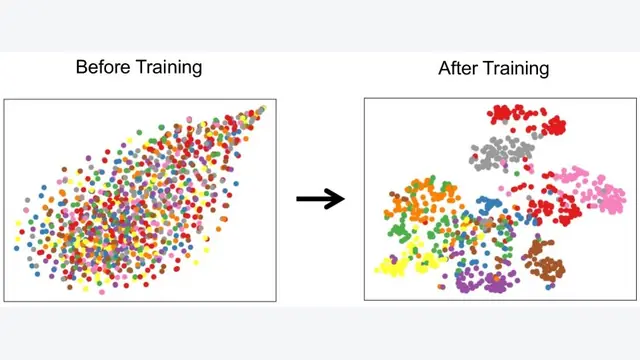
本文提出了一个“增强重叠”(Augmentation Overlap)理论,通过揭示同一类别的不同样本在数据增强下会产生重叠的视图,解释了实例级别的对比学习为何能学习到具有类别区分性的表示,并基于此推导出了更紧密的下游...
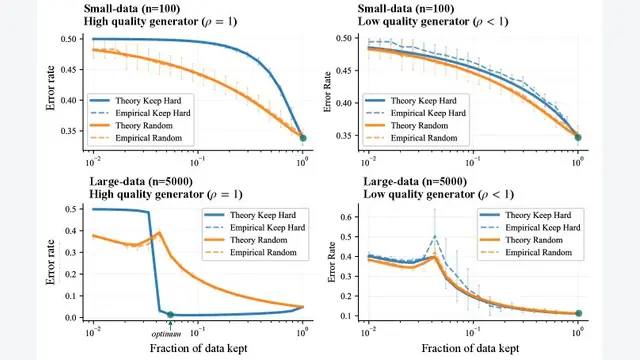
本文建立了一个理论框架,通过推导精确的缩放定律,揭示了在何时以及为何精心筛选(curate)一小部分数据进行训练,会比使用全部数据获得更好的性能,从而解决了“少即是多”与“多即是多”的矛盾。
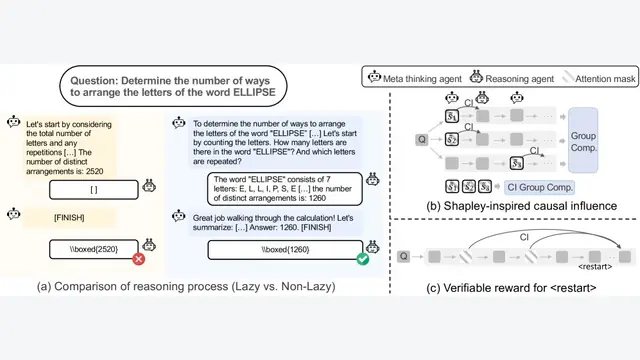
本文识别并解决了多智能体 LLM 推理框架中的“懒惰智能体”问题,通过理论分析揭示其源于现有强化学习目标的内在偏差,并提出了一种名为 Dr. MAMR 的新框架,该框架利用夏普利启发的因果影响测量和一种可验证的深思熟虑...