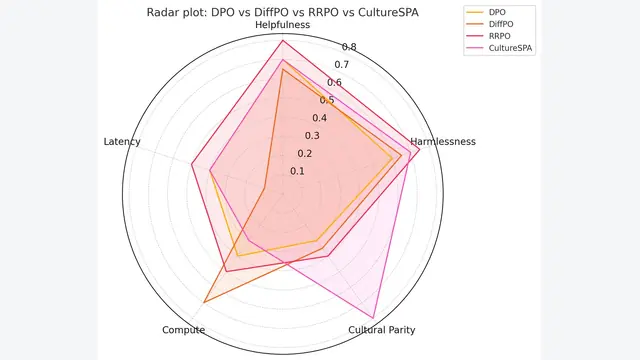
RLHF: A comprehensive Survey for Cultural, Multimodal and Low Latency Alignment Methods
RLHF: A comprehensive Survey for Cultural, Multimodal and Low Latency Alignment Methods。
多模态&视觉AI安全
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
RLHF: A comprehensive Survey for Cultural, Multimodal and Low Latency Alignment Methods。
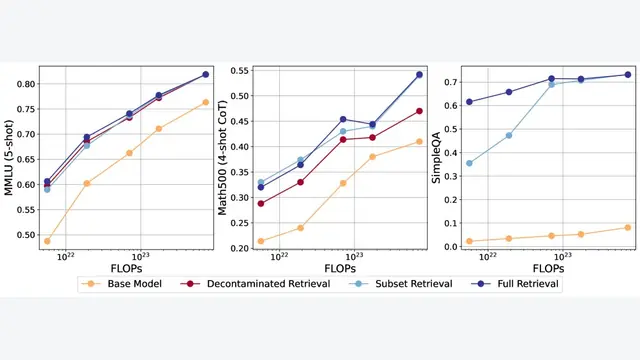
本文提出,在测试时通过检索增强的方式重用模型的预训练数据,可以显著提升大语言模型的性能,这种方法相当于一种高效的“计算倍增器”,证明了当前预训练方法并未充分利用数据中的信息。
智能体间信任模型:Brief、Claim、Proof、Stake、Reputation 和 Constraint 在智能体网络协议设计中的比较研究。
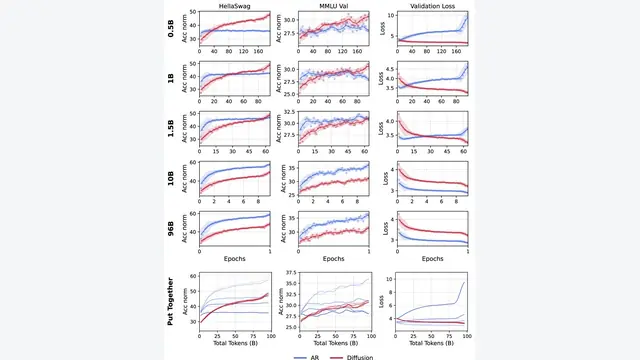
扩散语言模型(DLM)研究发现,在训练数据有限、计算资源充足的实验条件下,扩散模型可能比同规模自回归模型获得更好的数据利用效率。本文解读这种“智能交叉”现象的实验设计、计算开销和适用条件,避免将特定设置下的结果推广为全...
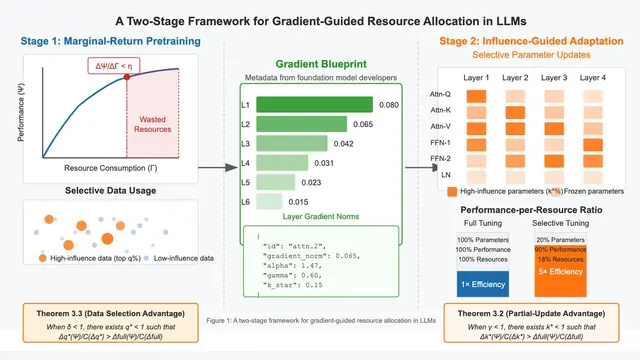
本文主张用“单位资源能力”而非单纯的规模来衡量AI进展,并提出了一个基于梯度指导资源分配的理论框架,通过识别和优先利用高影响力的参数和数据,来显著提升大语言模型(LLM)生命周期中的效率。
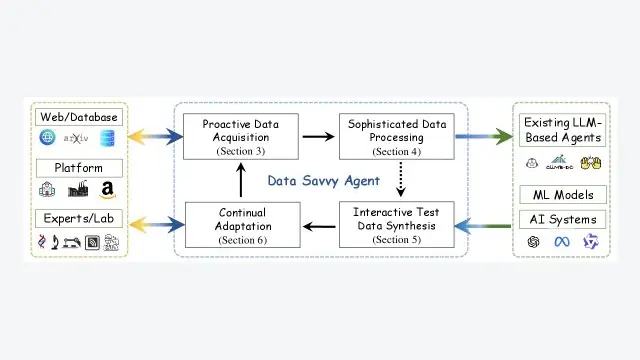
近期,能够自主交流、与人类协作并使用多种工具的AI智能体 (agents) 的兴起,为各种真实世界场景解锁了巨大的机遇。然而,尽管这些基于大型语言模型 (LLM) 的智能体在自然语言理解和问题解决方面取得了显著进展,它...
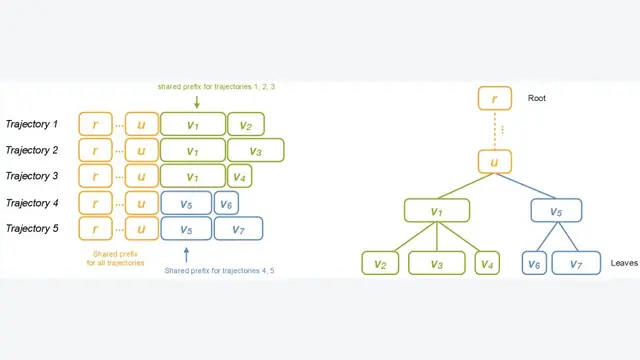
本文提出了一种名为 Tree Training 的新训练范式,通过将智能体交互产生的树状轨迹数据进行高效打包和计算复用,在训练的前向和后向传播中对共享的前缀(prefix)只计算一次,从而显著提升了智能体大语言模型(A...
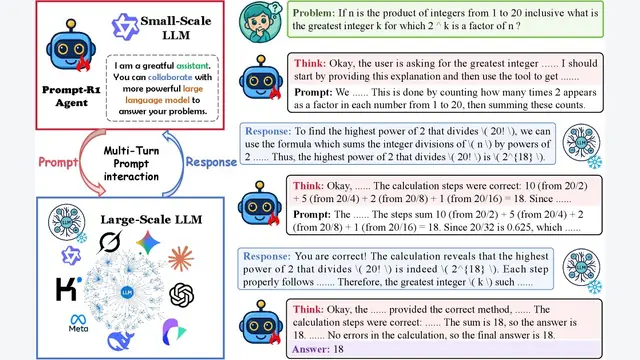
本文提出了一种名为 Prompt-R1 的端到端强化学习框架,该框架通过训练一个小型语言模型(作为智能体)以多轮交互的方式生成并优化提示,从而与一个大型语言模型(作为环境)协作,以更低的成本和更高的效率解决复杂问题。
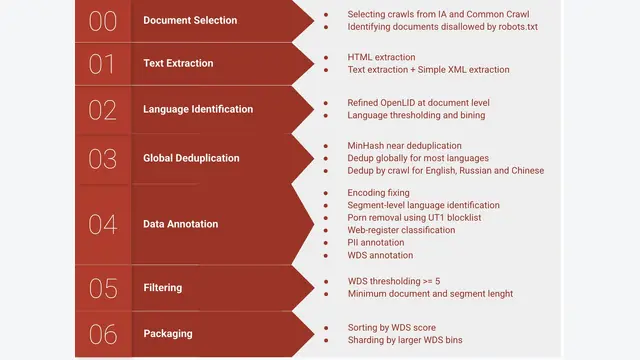
本文发布了HPLT 3.0,一个包含近200种语言、总量达30万亿token的开源、大规模、高质量多语言文本数据集,并提供了完整的开源数据处理流程、多语言评估框架及预训练模型,旨在推动LLM和MT研究的普及化。
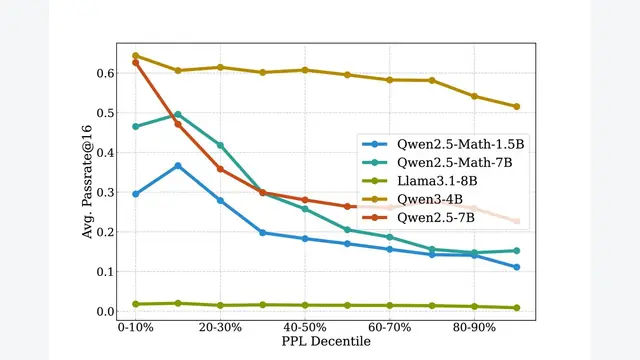
本文提出了一种名为PREPO的高效强化学习方法,通过结合基于提示困惑度(Perplexity)的课程学习调度和基于相对熵(Relative Entropy)的探索性序列加权,在不牺牲模型性能的前提下,将大语言模型在强化...
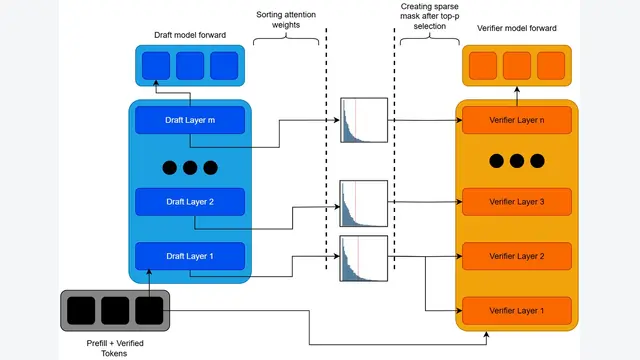
本文提出了一种名为 SpecAttn 的免训练方法,该方法将推测解码(speculative decoding)与稀疏注意力相结合,通过利用草稿模型(draft model)已计算出的注意力权重来为目标模型(targe...
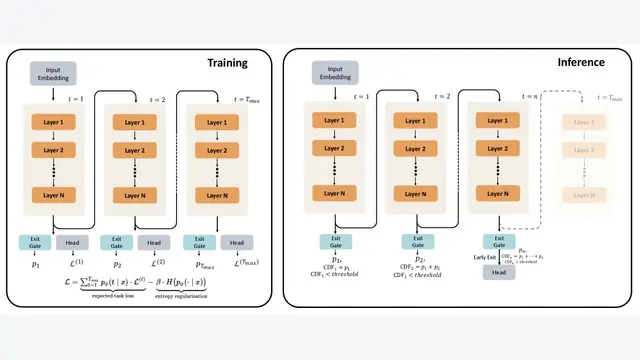
好的,我将以世界顶级AI研究科学家的身份,遵循您的指示,撰写这份论文笔记。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
本文首次为Transformer的长度泛化(length generalization)能力提供了定量的边界,通过引入一种“模拟论证”方法,证明了当训练序列足够长,能够“模拟”更长序列上的内部行为时,模型便能实现长度泛...
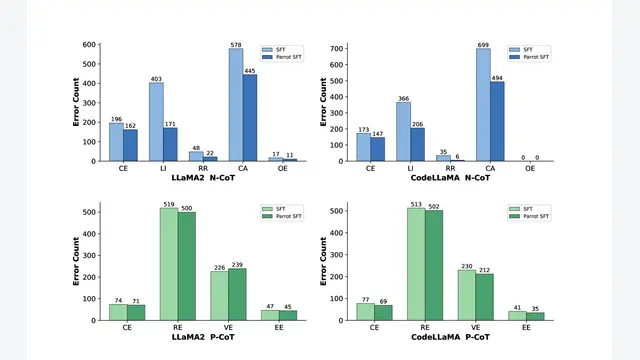
本文提出了一种名为 Parrot 的新颖训练流水线,旨在通过三个专门设计的子任务和混合训练策略,相互增强程序思维链(P-CoT)和自然语言思维链(N-CoT)的性能,从而同时提升两种范式下的数学推理能力。
本文提出了一种名为高阶线性注意力 (Higher-order Linear Attention, HLA) 的新型注意力机制,它通过紧凑的前缀充分统计量 (prefix sufficient statistics) 实...
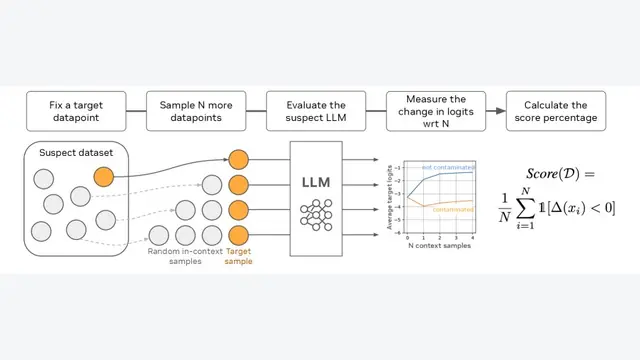
本文提出了一种名为 CoDeC 的新方法,通过衡量上下文学习(In-Context Learning)对模型置信度的影响,来有效检测和量化大语言模型中的训练数据污染问题。
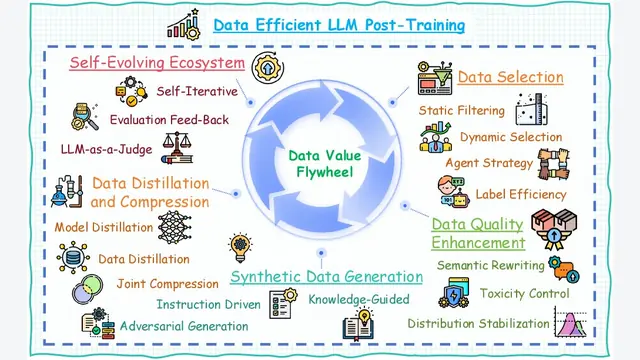
大型语言模型 (Large Language Models, LLMs) 的后训练 (post-training) 已成为释放其领域适应能力和任务泛化潜力的关键阶段。这一阶段有效增强了模型在长上下文推理、人类对齐、指令...
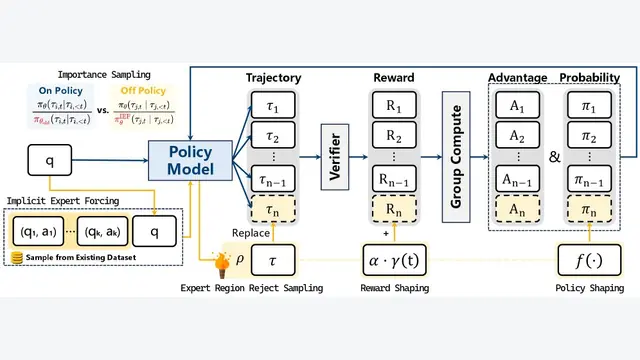
本文提出了一种名为“上下文引导策略优化” (In-Context Steered Policy Optimization, ICPO) 的新型强化学习框架,该框架利用大推理模型 (Large Reasoning Mod...
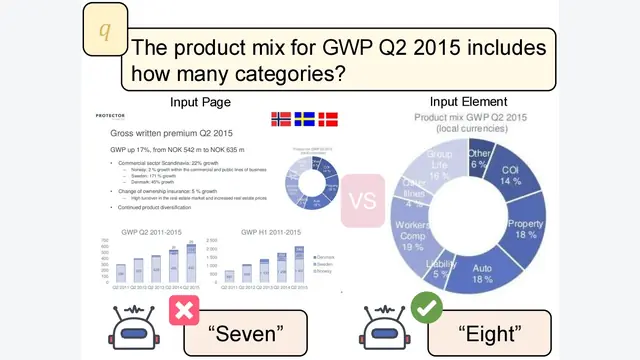
本文提出了一种名为 SlideAgent 的分层智能体框架,通过设置全局、页面、元素三个级别的专业智能体,将复杂的多页视觉文档理解任务分解,先构建独立于查询的结构化知识库,再进行针对性推理,从而显著提升了大型语言模型在...
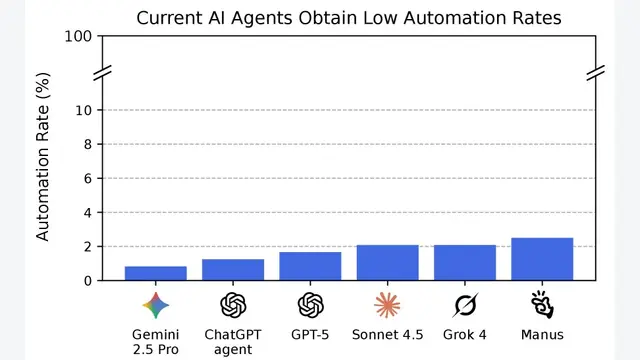
本文提出了一种名为远程劳动指数(Remote Labor Index, RLI)的新基准,通过评估AI智能体在真实自由职业平台上的端到端项目完成能力,来衡量AI在具有经济价值的实际任务上的自动化水平,从而为追踪AI的经...
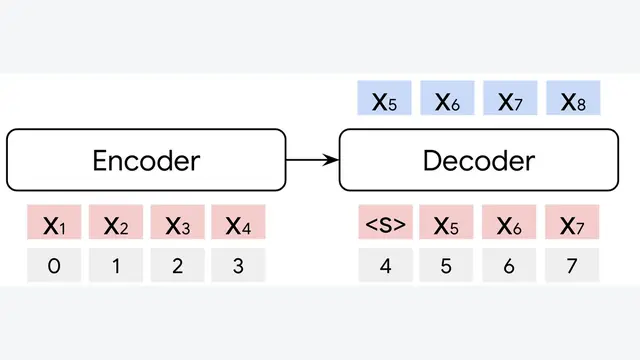
本文通过为编码器-解码器架构(RedLLM)集成现代LLM技术(如旋转位置编码),并在约1.5亿至80亿参数规模上与主流的解码器-仅架构(DecLLM)进行系统性对比,发现RedLLM在指令微调后,能以显著更高的推理效...
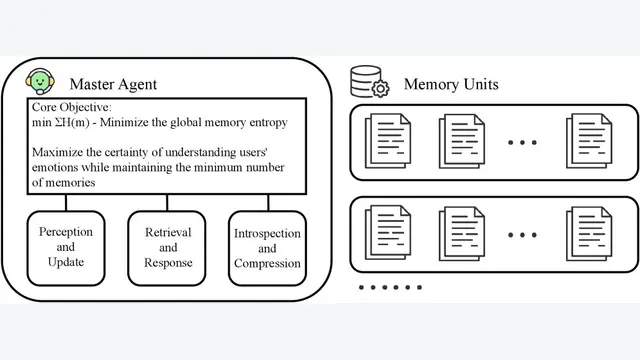
本文提出了一种名为DAM-LLM的动态情感记忆管理系统,通过引入基于贝叶斯的更新机制和记忆熵概念,使智能体能够自主维护一个动态更新的记忆数据库,以解决传统静态记忆的冗余、过时和一致性差的问题,从而提供更具个性化的情感交互。
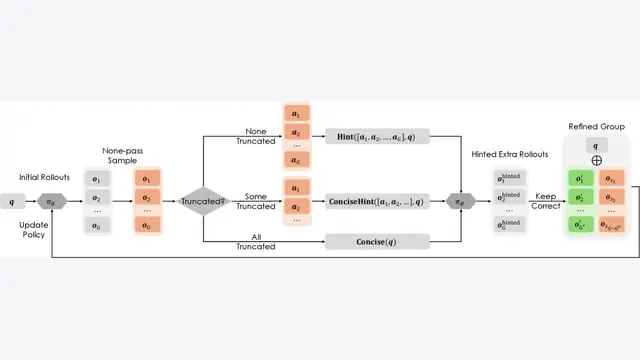
本文提出了一种名为 LTE(Learning to reason from Trial and Error) 的方法,通过利用大语言模型(LLM)自身在推理失败时产生的错误答案作为提示信息,来克服强化学习中的探索停滞问...
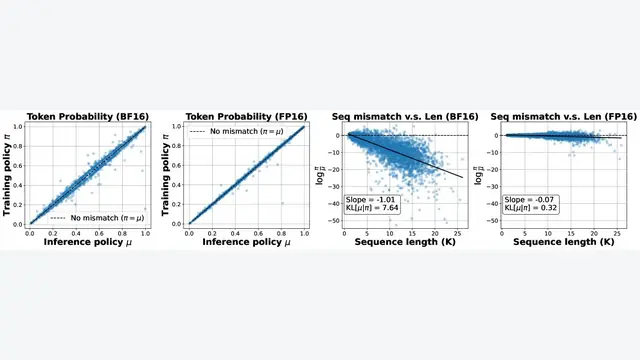
本文发现,在强化学习微调大型语言模型时,仅需将训练精度从广泛使用的 BF16 切换回 FP16,即可从根源上解决训练与推理策略之间的数值不匹配问题,从而获得更稳定的优化、更快的收敛和更强的模型性能。