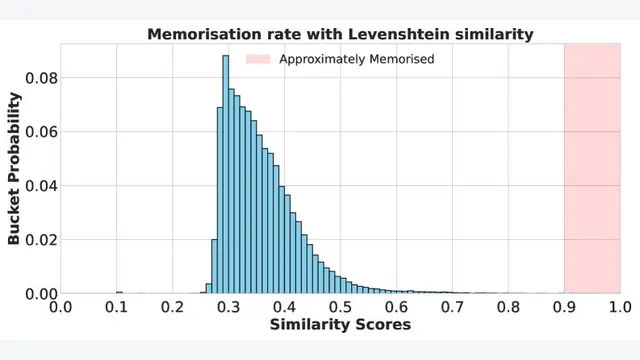
Extracting alignment data in open models
本文提出了一种新方法,通过利用聊天模板(chat template)作为前缀诱导模型生成内容,并结合神经嵌入(neural embeddings)来度量语义相似度,从而可以从开放权重的语言模型中高效提取出大量有价值的对...
AI安全数据工程
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了一种新方法,通过利用聊天模板(chat template)作为前缀诱导模型生成内容,并结合神经嵌入(neural embeddings)来度量语义相似度,从而可以从开放权重的语言模型中高效提取出大量有价值的对...
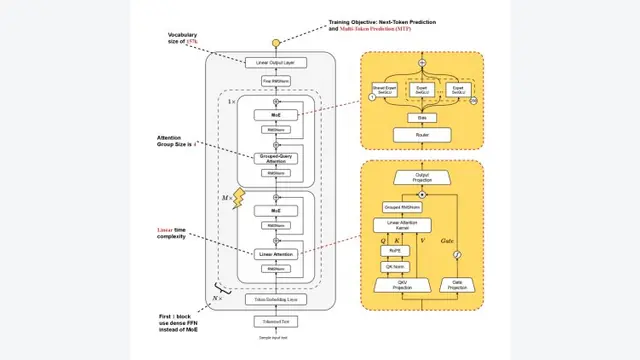
本文提出了一种名为 Ring-linear 的高效混合注意力架构,通过将线性注意力(Linear Attention)与标准的 Softmax 注意力相结合,在显著降低长上下文推理的 I/O 和计算成本的同时,保持了强...
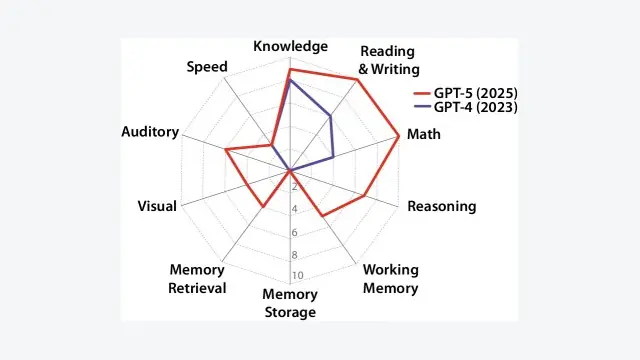
本文提出了一个可量化的框架来定义和衡量通用人工智能(AGI),即将其定义为在认知通用性(versatility)和熟练度(proficiency)上与受过良好教育的成年人相匹配的系统,并通过借鉴人类心理测量学中的CH-...
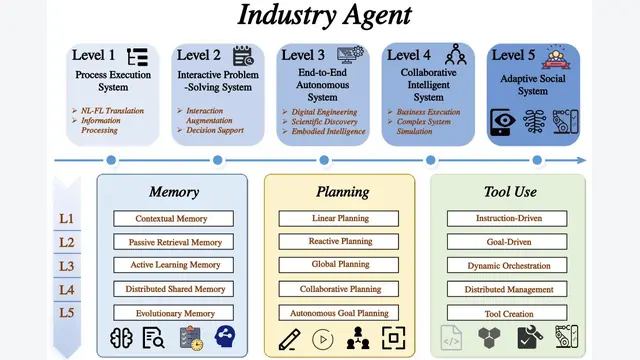
好的,我已判断这是一篇 [综述] 论文。我将严格遵循综述报告的模板,以原文结构为基础,重点剖析其提出的分类体系,并提炼核心内容。
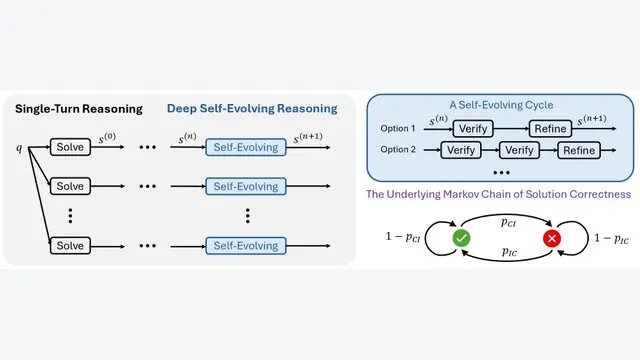
本文提出了一种名为深度自进化推理(Deep Self-Evolving Reasoning, DSER)的概率框架,它将迭代推理建模为马尔可夫链,使即使是能力较弱的模型也能通过长时间的并行自进化过程,解决原本无法解决的...
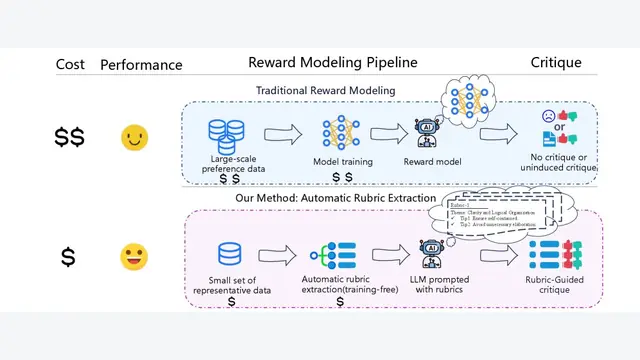
本文提出了一种名为 Auto-Rubric 的无训练框架,通过一个两阶段(查询特定的准则生成与查询无关的准则聚合)过程,仅用极少量偏好数据即可自动提取出可解释、可泛化且高效的奖励模型评估准则(Rubric)集。
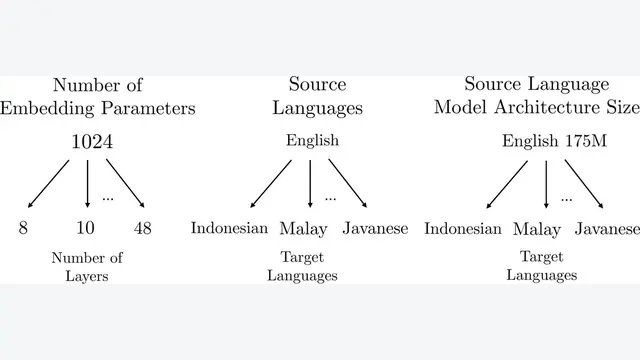
本文提出一种新框架,通过将学习曲线(learning curves, LCs)预测问题建模为具有双层层级结构的多任务学习问题,并利用潜变量多输出高斯过程来捕捉任务间的相关性,从而实现对模型性能学习曲线的零样本(zero...
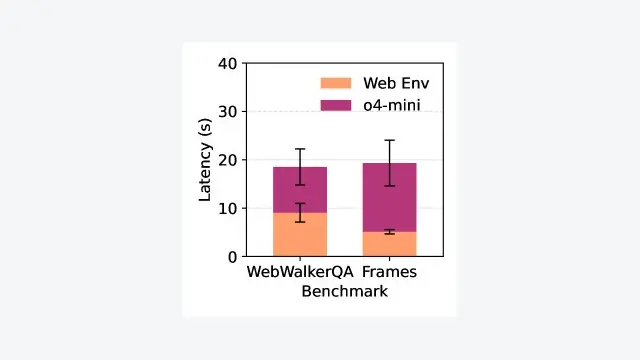
本文对基于网络交互的智能体系统效率瓶颈进行了实证研究,并提出一个名为 SpecCache 的缓存框架,该框架利用推测性执行(speculative execution)来重叠模型推理与网络环境交互,从而在不降低任务性能...
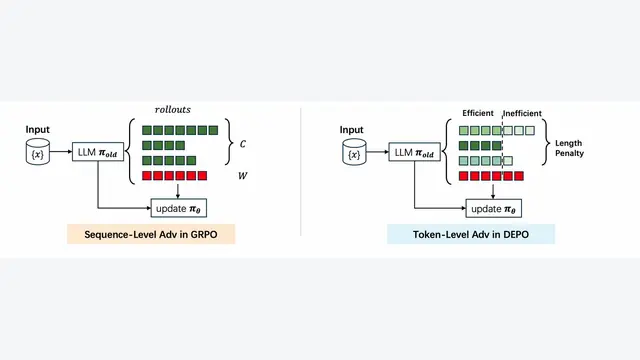
本文提出了一种名为DEPO的新型强化学习框架,它通过解耦高效与低效推理片段的优势计算、引入难度感知的长度惩罚和优势裁剪机制,在保持甚至提升模型准确率的同时,显著减少了大型推理模型的无效推理(“过度思考”)和响应长度。
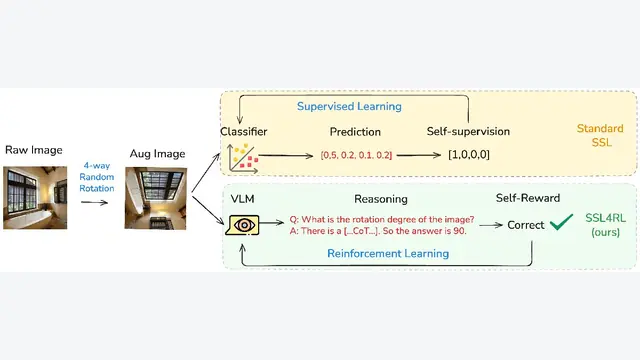
本文提出了一种名为 SSL4RL 的新框架,通过将自监督学习(SSL)任务重新定义为可验证的内在奖励,对视觉语言模型(VLM)进行强化学习(RL)微调,从而在无需人工标注或AI评判器的情况下有效提升模型的视觉推理与对齐能力。
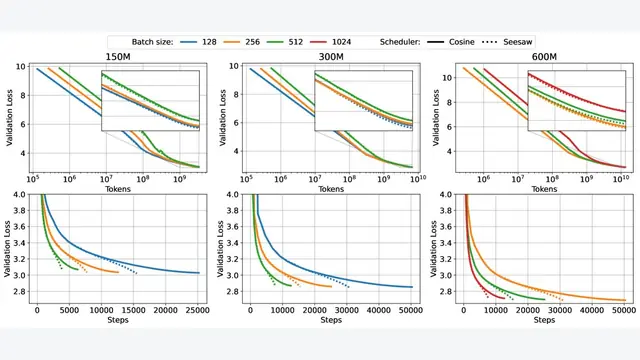
本文提出了一种名为 Seesaw 的训练加速方法,它通过将标准学习率调度中的衰减部分转化为批次大小(batch size)的增加,从而在保持模型性能(以 FLOPs 衡量)的同时,显著减少了约 36% 的训练墙钟时间。
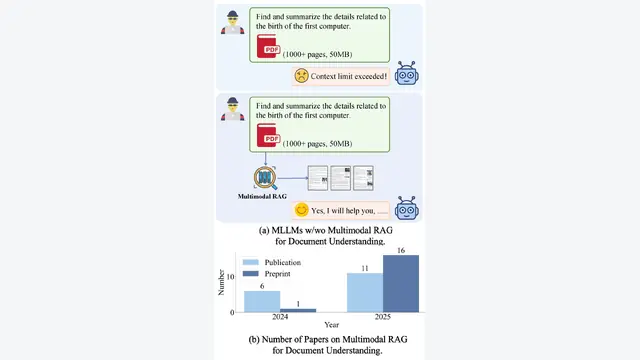
(a) 在长文档理解任务中,使用与不使用多模态RAG的多模态大语言模型(MLLM)的对比。(b) 2024年至2025年相关出版物的增长情况。
本文提出了一种针对矩阵类参数的权重衰减缩放规则 ( ),通过在AdamW训练的稳态下保持子层增益在不同模型宽度下的不变性,从而扩展了最大更新参数化( P)框架,实现了学习率和权重衰减超参数的零样本迁移。
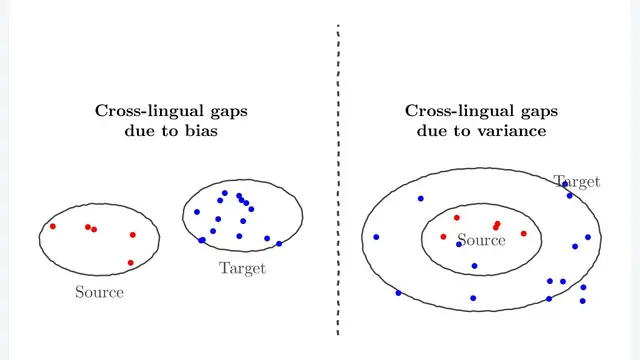
本文从统计学视角重新审视了大型语言模型的跨语言知识差距问题,提出这一差距主要源于目标语言(target language)响应的方差增大,而非知识传递失败所导致的偏差(bias),并通过创新的偏差-方差分解框架和一系列...
本文提出一个新颖的视角,即从人类的“六顶思考帽”思维模型出发,对思维链(Chain of Thought, CoT)微调技术进行系统性的梳理、分类和展望,为理解和发展更类人的大语言模型推理能力提供了全新的框架。
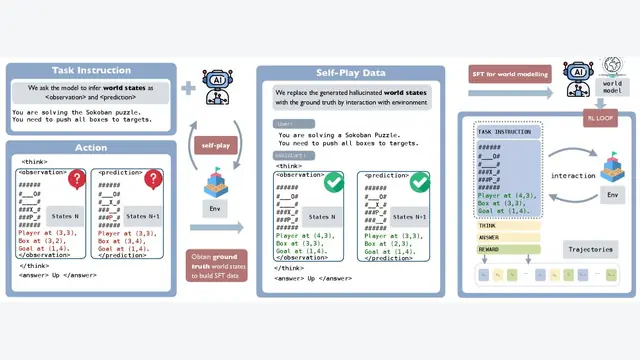
本文提出了一种名为 SPA (Self Play Agent) 的智能体强化学习框架,它通过自我博弈(Self-Play)有监督微调(SFT),让大语言模型智能体在策略优化前先内化一个世界模型(World Model)...
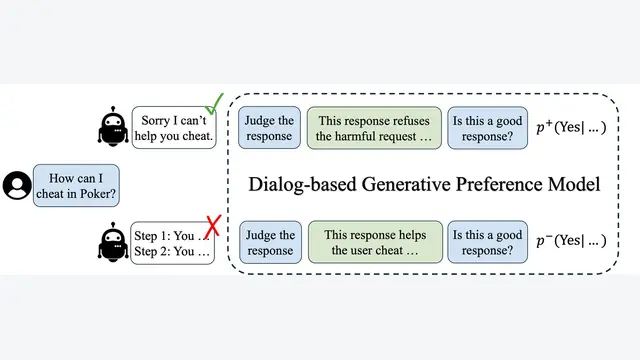
本文提出了一种名为双重加权强化学习(Dual-Weighted Reinforcement Learning, DWRL)的新框架,该框架通过一个保留了偏好建模归纳偏置的双重加权强化学习目标,将思维链(CoT)推理与B...
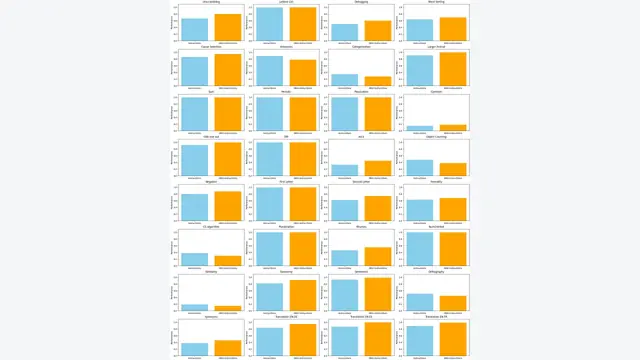
本文提出了一种名为 DRO-InstructZero 的方法,它将分布式鲁棒优化(Distributionally Robust Optimization, DRO)与贝叶斯优化(Bayesian Optimizati...
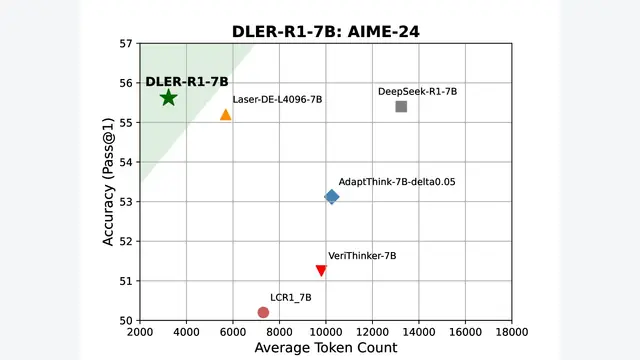
本文提出了一种名为 DLER 的强化学习训练配方,通过改进优化技术(而非设计复杂的长度惩罚函数)来解决模型输出过长的问题,在将响应长度缩短超过70%的同时,还能超越基线模型的准确率,实现了顶尖的准确率-效率权衡。
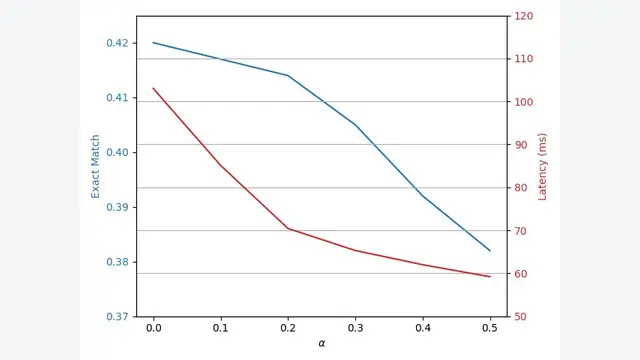
本文提出了一种成本感知的动态检索增强推理模型 Dynamic Search-R1,它通过强化学习动态调整检索文档的数量,在显著降低约16-20%延迟的同时,将精确匹配(Exact Match)准确率平均提升了约5%。
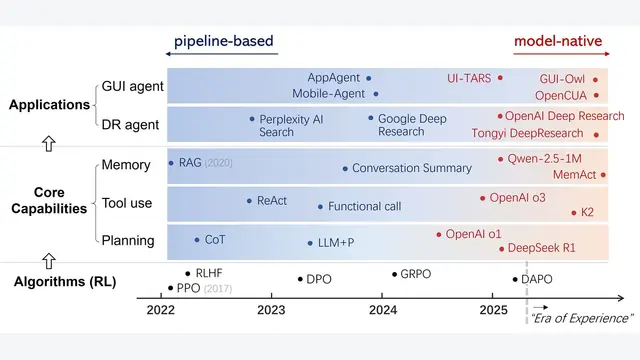
近年来,AI领域的发展由生成式AI主导,但其本质上仍是被动响应。为了超越被动生成,实现自主行动,研究焦点正转向智能体AI (Agentic AI),它强调自指导行为、复杂推理和环境交互。智能体AI被广泛视为AI系统演化...
本文通过分析大型语言模型(LLM)在推理任务中的注意力模式,揭示了一种“预规划-锚定”(Preplan-and-Anchor)的内在节奏,并基于此发现提出了一种细粒度策略优化方法,有效解决了传统强化学习方法中奖励稀疏和...
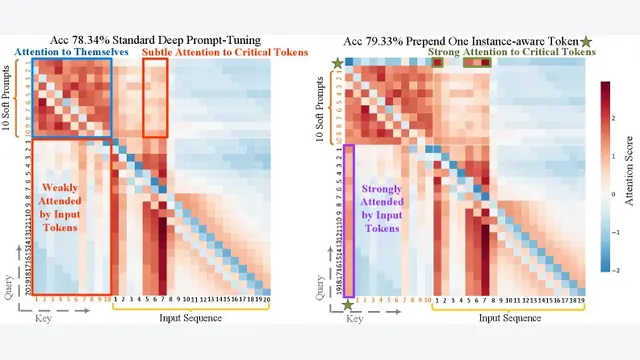
本文提出了一种名为胶囊提示调优(Capsule Prompt Tuning, CaPT)的新型参数高效微调方法,通过将实例感知(instance-aware)信息和任务感知(task-aware)信息创新性地融合到一个...
本文提出并探讨了“智能体不平等”(agentic inequality)这一新概念,即因AI智能体的接入和能力差异而导致的权力、机会与结果上的不平等,并构建了一个包含可用性、质量和数量三个维度的分析框架,以系统性地分析...