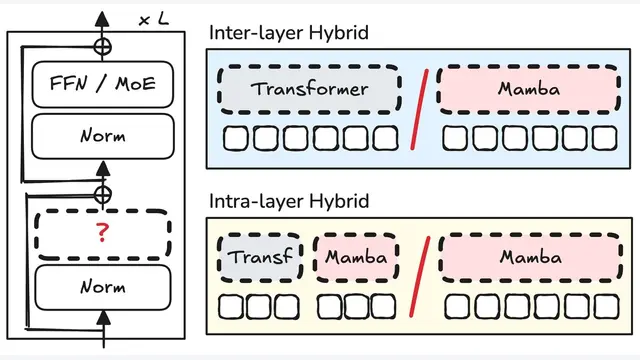
Hybrid Architectures for Language Models: Systematic Analysis and Design Insights
本文系统性地分析和评估了语言模型的混合架构(层间与层内),发现层内混合策略在模型质量与计算效率之间取得了最佳的帕累托前沿 (Pareto-frontier)。
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文系统性地分析和评估了语言模型的混合架构(层间与层内),发现层内混合策略在模型质量与计算效率之间取得了最佳的帕累托前沿 (Pareto-frontier)。
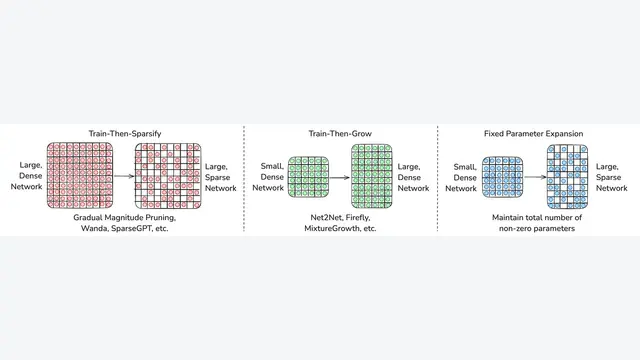
本文提出了一种名为“固定参数扩展”(Fixed Parameter Expansion, FPE)的方法,通过在不增加非零参数总数的情况下增加网络中的神经元数量,来减少由特征叠加(superposition)引起的干扰...
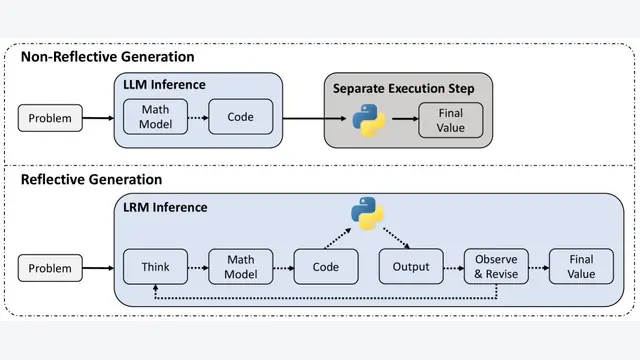
本文提出 CALM 框架,通过专家智能体注入轻量级提示来修正大型推理模型 (LRM) 的原生推理缺陷,从而生成高质量数据,并通过监督微调和强化学习两阶段训练,打造出在优化建模任务上达到业界顶尖水平且参数高效的模型 ST...
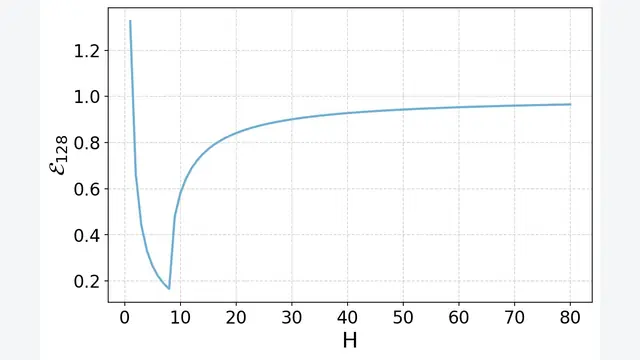
本文通过数学分析 Transformer 模型中参数分配的效率,从理论上揭示了对于信息提取任务,早期层中的注意力头数量与头维度之间存在权衡关系,并证明了 Softmax 激活函数存在饱和效应,这为后期层减少参数提供了理...
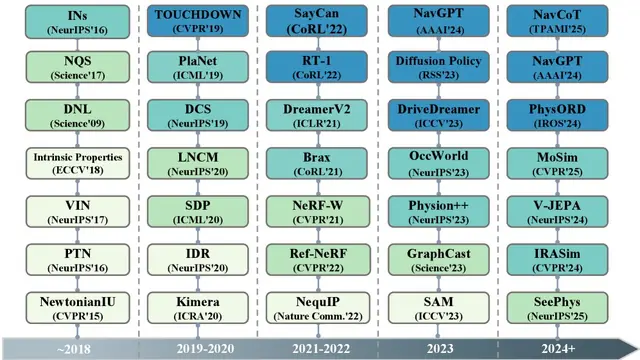
教给AI理解物理世界是现代AI研究中最根本的挑战之一。尽管人类自幼就能直观地预测物体动态并理解复杂的物理交互,但目前的AI模型在掌握幼儿轻松掌握的基础物理推理方面仍然存在困难。随着AI系统被部署到自动驾驶、机器人操控等...
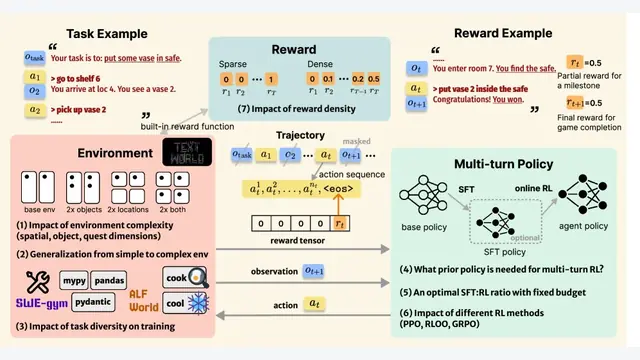
本文通过将多轮智能体强化学习(multi-turn agentic reinforcement learning)的设计空间分解为环境、奖励和策略三大支柱,系统性地进行了实证研究,并最终提炼出一套用于训练大型语言模型(...
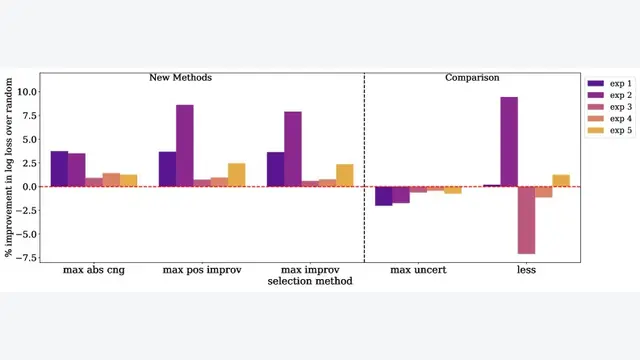
本文提出了一种名为“在验证集上训练 (Train on Validation, ToV)”的快速数据选择方法,通过反转训练集和验证集的传统角色,依据训练样本在模型于少量目标验证集上微调后的预测损失变化来为其评分,从而高...
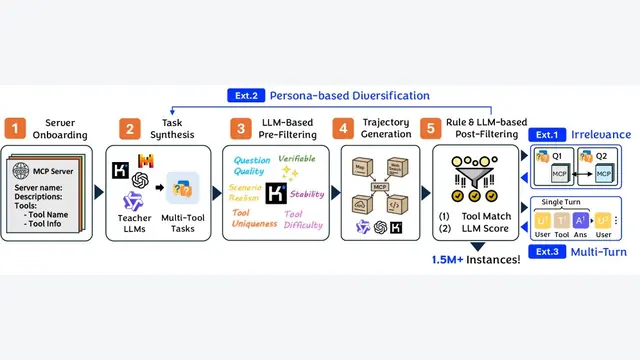
本文介绍了一个名为 TOUCAN 的大规模工具智能体数据集,包含 150 万条从近 500 个真实世界 MCP 环境中合成的轨迹,旨在通过提供多样、真实且复杂的训练数据,显著提升开源大型语言模型(LLM)的工具调用和智...
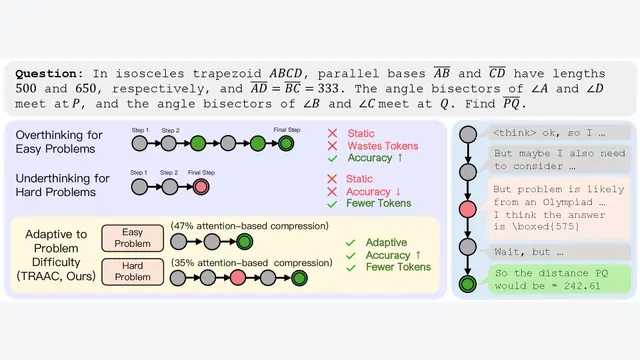
本文提出了一种名为 TRAC 的在线强化学习后训练方法,利用模型自身的自注意力机制来识别并压缩冗余的推理步骤,并根据动态评估的任务难度自适应地调整压缩程度,从而有效缓解大模型在简单任务上“过度思考”和在困难任务上“思考...
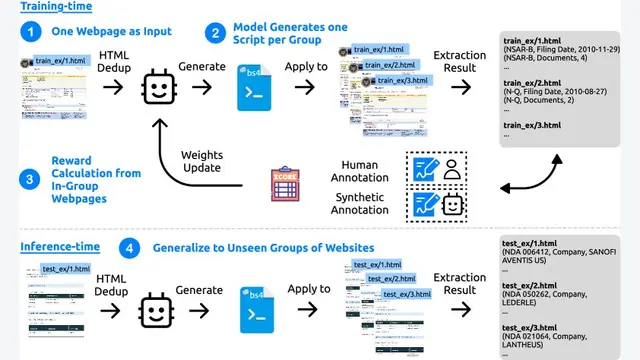
本文提出了一种名为 SCRIBES 的新型强化学习框架,它通过利用同一网站内网页间的布局相似性作为奖励信号,训练大型语言模型生成可重用的提取脚本,从而实现对网页半结构化数据(如表格和列表)的网络规模、高效率提取。
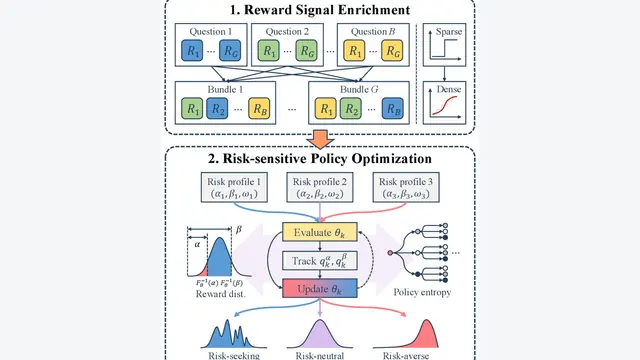
本文提出一种名为 RiskPO 的大语言模型训练后优化方法,通过引入一个基于风险度量的目标函数(MVaR),替代传统的均值优化目标,从而将模型优化的重点放在处理困难样本上,有效缓解了熵坍塌问题,并显著提升了模型的推理能力。
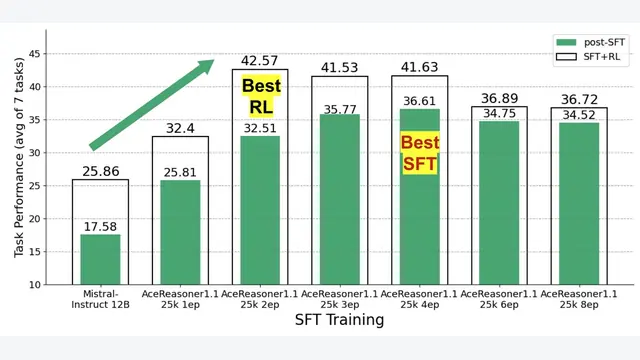
本文挑战了“高SFT分数能带来更好RL效果”的普遍假设,通过实验证明SFT分数具有误导性,并提出使用“泛化损失”和“Pass@large k”作为更可靠的RL后性能预测指标。
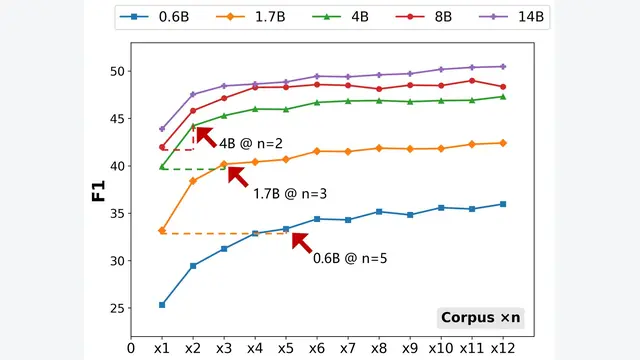
本文通过系统性实验证明,在检索增强生成(Retrieval-Augmented Generation, RAG)系统中,扩大检索语料库的规模可以作为一种有效的替代方案来弥补使用较小语言模型(LLM)所带来的性能差距,为...
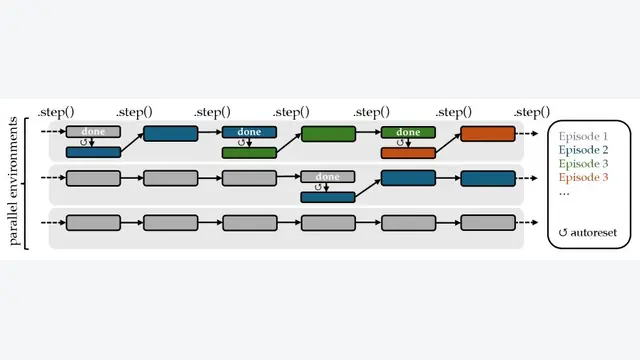
本文介绍了一个名为GEM(General Experience Maker)的开源环境模拟器,它旨在像传统强化学习领域的OpenAI-Gym一样,为智能体大语言模型(Agentic LLMs)提供一个标准化的训练与评估...
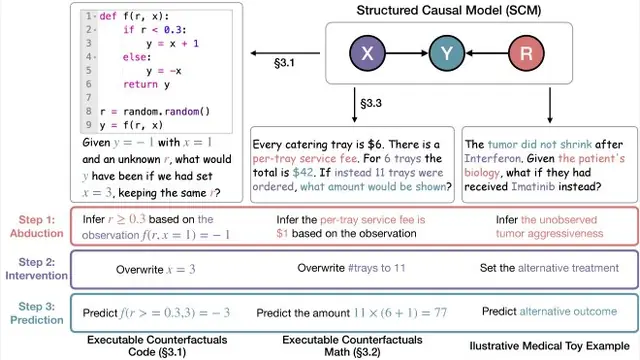
本文提出了一个名为“可执行反事实 (Executable Counterfactuals)”的框架,通过生成需要溯因、干预和预测三个步骤的编程和数学问题,系统地评估和提升大语言模型的反事实推理能力,并实验证明强化学习(...
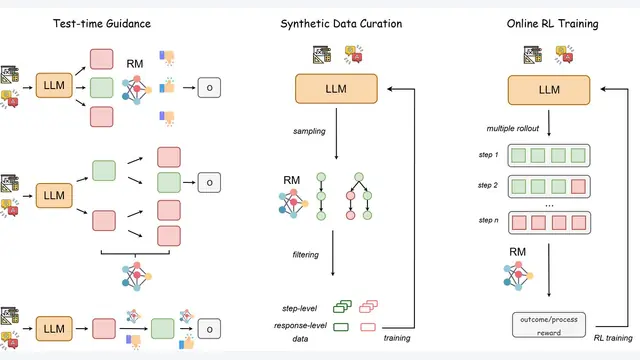
本文系统性地介绍了奖励模型(Reward Models, RMs)的基础概念、分类体系和主流应用,并深入分析了它们在提升大型语言模型(LLM)推理能力中的关键作用,最后探讨了该领域面临的核心挑战与未来方向。
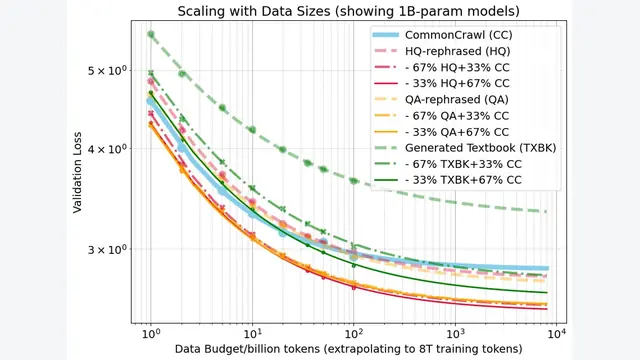
本文通过大规模实证研究系统地揭示了,在大型语言模型预训练中战略性地混合约30%的重述(rephrased)合成数据与自然网络文本,可以在大数据量下将达到相同损失所需的训练速度提升5-10倍,但合成数据的最终效果高度依赖...
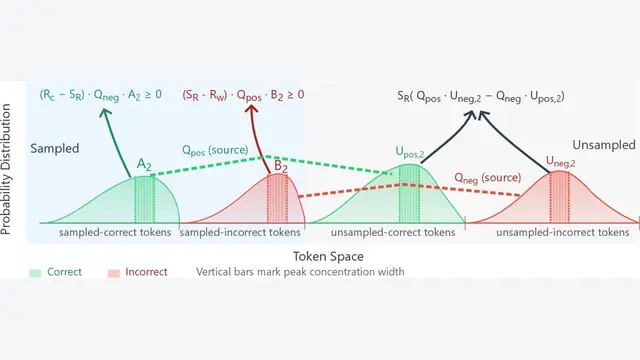
本文提出了一种名为 BroRL 的强化学习扩展范式,它通过显著增加每个样本的探索次数 (rollouts) 来拓宽探索范围,从而有效克服了传统按训练步数扩展方法遭遇的性能瓶颈,实现了持续且高效的模型性能提升。
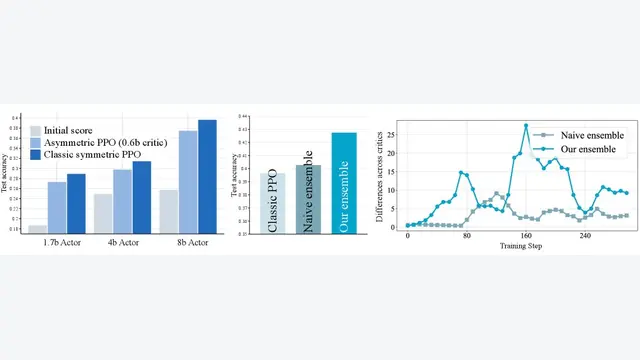
本文提出了一种非对称近端策略优化(Asymmetric Proximal Policy Optimization, AsyPPO),该框架通过使用一组在非重叠数据上训练的轻量级“迷你评论家”(mini-critics)...
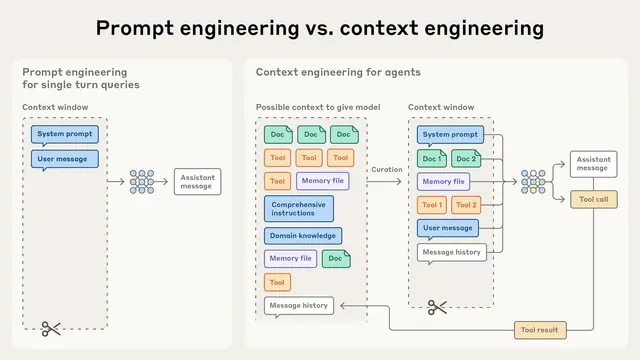
本文提出了“上下文工程” (Context Engineering) 的概念,主张将 AI 智能体开发的重点从编写静态提示词(prompt)转向动态地策划和管理输入给模型的全部信息(即上下文),从而在模型有限的注意力预...
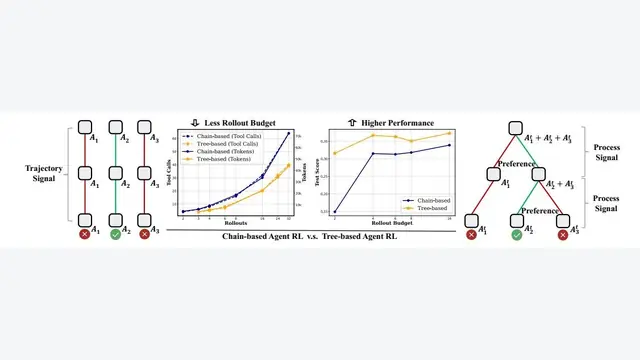
本文提出了一种名为 Tree-GRPO (Tree-based Group Relative Policy Optimization) 的方法,通过将传统强化学习中独立的链式轨迹采样替换为树搜索采样,从而在有限的 ro...
本文提出了一种新颖的方法,通过将复杂的多轮任务规划问题转化为一系列单轮任务推理问题,并利用基于专家轨迹的单轮强化学习(GRPO)进行优化,成功训练出在长时程规划任务中性能超越大型基线模型的小参数量智能体。
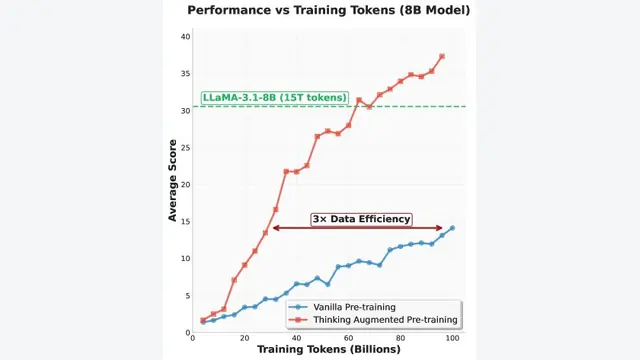
本文提出了一种名为“思维增强预训练”(Thinking Augmented Pre-training, TPT)的简单且可扩展的方法,通过使用现有LLM为预训练数据自动生成“思维轨迹”(thinking traject...
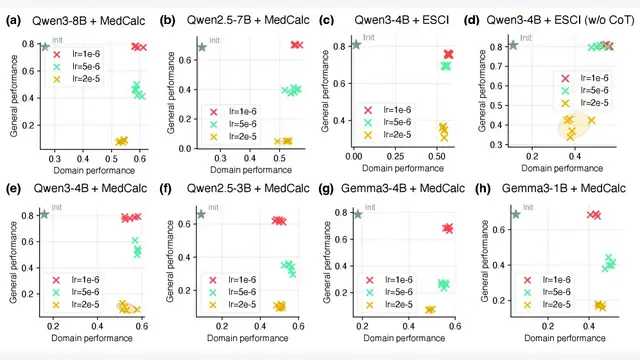
本文挑战了领域特定监督微调(SFT)必然损害大语言模型(LLM)通用能力的普遍观念,指出使用小学习率可以显著缓解性能下降,并提出了一种名为“令牌自适应损失重加权”(TALR)的新方法,以更有效地平衡领域知识注入与通用能...