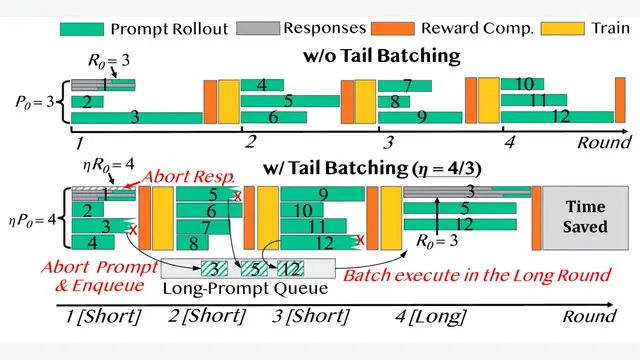
RollPacker: Mitigating Long-Tail Rollouts for Fast, Synchronous RL Post-Training
本文提出了一种名为 RollPacker 的同步强化学习(RL)训练系统,其核心是一种创新的 rollout 调度策略——尾部批处理(tail batching),该策略通过将导致长响应的 prompt 整合到少数专用...
模型训练
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了一种名为 RollPacker 的同步强化学习(RL)训练系统,其核心是一种创新的 rollout 调度策略——尾部批处理(tail batching),该策略通过将导致长响应的 prompt 整合到少数专用...
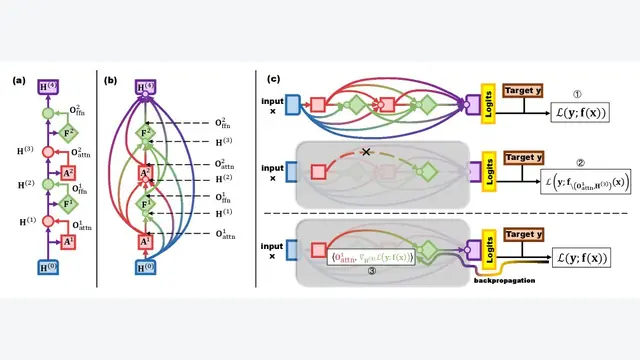
本文通过边缘归因修补(EAP)方法分析发现,在线强化学习(RL)微调能系统性地增强大语言模型(LLM)内部回路的激活强度和模式多样性,从而提升模型能力,而直接偏好优化(DPO)则不具备此效应。
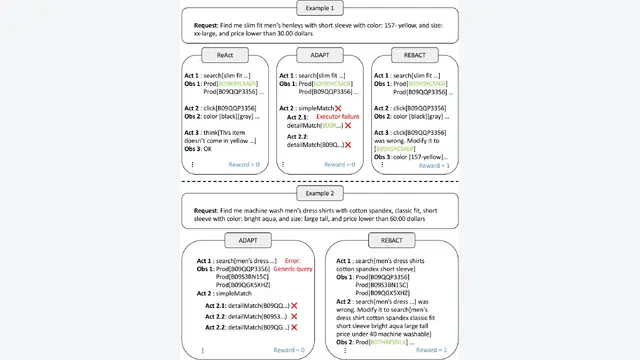
本文提出了一种名为 REBACT 的新方法,在大型语言模型 (LLM) 执行下一步行动前增加了一个“反思”步骤,通过主动纠正先前动作中的错误,从而显著提升了其在交互式决策任务中的性能和计算效率。
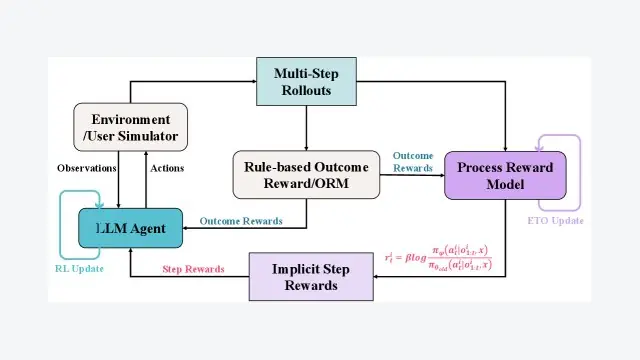
本文提出了一种名为在线过程奖励学习 (Online Process Reward Learning, OPRL) 的智能体强化学习信誉分配策略,该策略通过在线交替优化一个过程奖励模型和智能体策略,将轨迹级别的偏好无缝转...
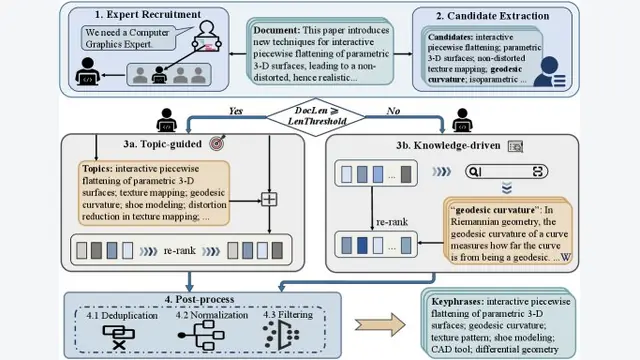
本文提出了MAPEX,一个用于关键词提取的多智能体协作框架,它通过为不同长度的文档设计动态的双路径策略(知识驱动与主题引导),显著提升了大型语言模型(LLM)在零样本场景下的关键词提取性能。
本文提出一种名为结构化反思 (structured reflection) 的新机制,将工具调用失败后的错误诊断与修复过程,转化为一种可控、可训练的智能体行为,从而显著增强大型语言模型在多轮工具交互中的可靠性和错误恢复能力。
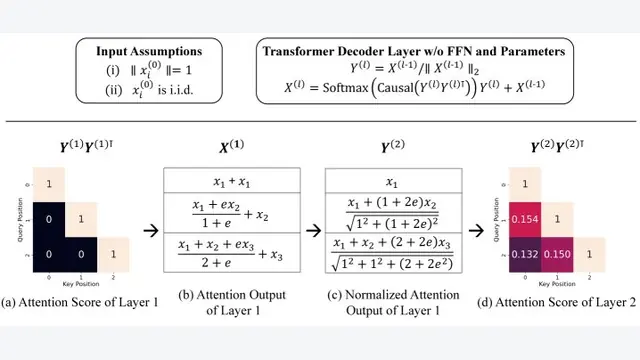
本文通过理论证明和实验分析,揭示了Transformer解码器中的因果掩码 (Causal Mask) 本身就是一种位置信息来源,它能诱导出偏好邻近token的注意力模式,并且会与RoPE等显式位置编码相互作用,将其相...
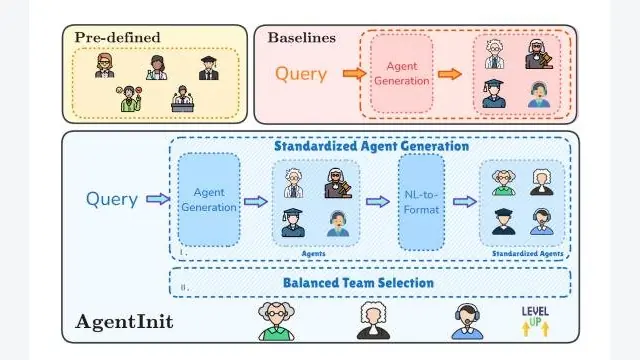
本文提出了一种名为 AgentInit 的多智能体系统(Multi-Agent System, MAS)初始化方法,该方法通过生成一组多样化的候选智能体,并利用以任务相关性和团队多样性为目标的帕累托最优原则进行团队选择...
Reinforcement Learning Meets Large Language Models: A Survey of Advancements and Applications Across the LLM ...
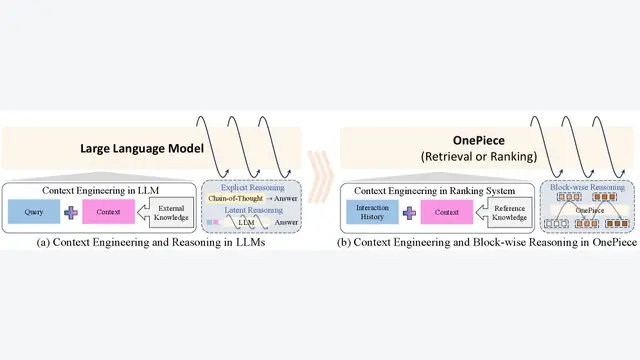
本文提出了 OnePiece,一个统一的框架,它将大型语言模型(LLM)风格的上下文工程和多步推理机制成功地集成到工业级级联排序系统的召回和排序阶段,并取得了显著的离线和在线效果提升。
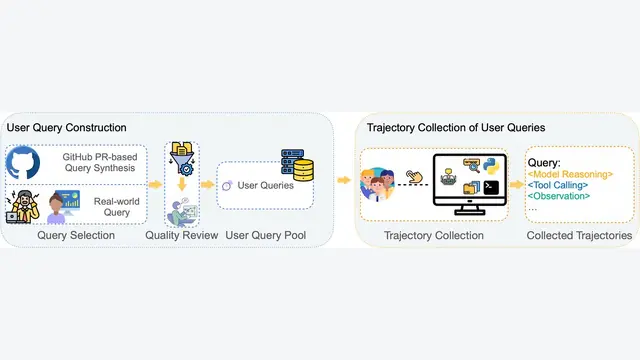
本文提出 LIMI 方法,证明通过极少量(仅78个)精心策划的高质量训练样本,即可训练出在智能体任务上超越使用海量数据训练的模型的强大AI智能体,从而确立了智能体开发的“少即是多”原则。
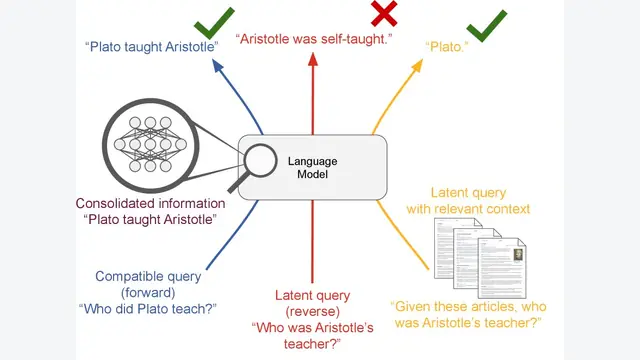
本文的核心论点建立在对认知科学概念的借鉴和对机器学习泛化能力的重新审视之上。以下是理解本文至关重要的核心概念。
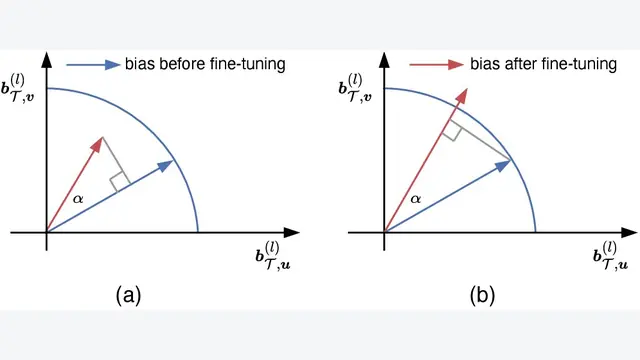
本文提出了一种偏置高效微调方法 (Bias-Efficient Fine-Tuning, BEFT),其核心是一种通过计算微调前后偏置向量的投影比率来评估重要性的新方法,从而能够更精确地选择出对下游任务最关键的偏置项(...
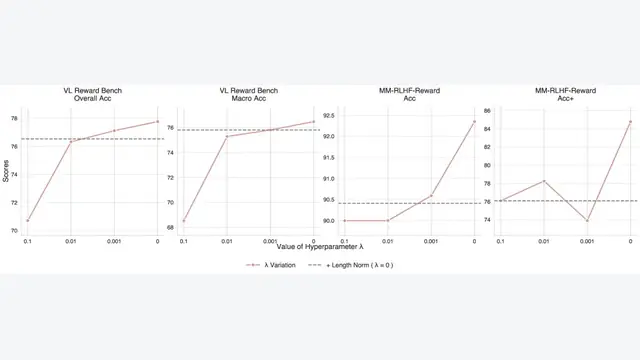
本文通过一系列详尽的实验,系统性地探究了构建高性能多模态奖励模型的关键要素,总结出一套清晰的“配方”,并基于此提出了一款名为 BaseReward 的强大基线模型,在多个主流基准测试中达到了新的SOTA水平。
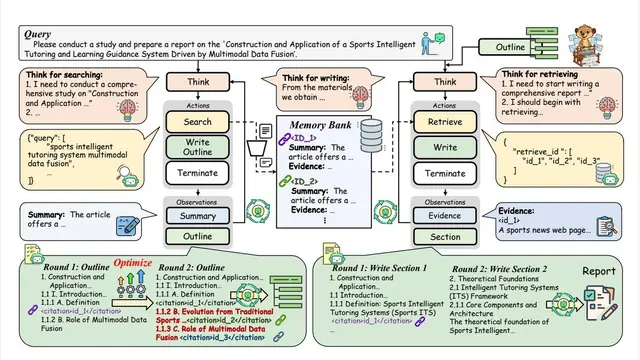
本文提出了 WebWeaver,一个模仿人类研究过程的双智能体框架,其中规划器(Planner)通过迭代优化大纲并搜集证据,构建动态且有来源依据的报告结构,而写作者(Writer)则分章节、有针对性地从记忆库中检索信息...
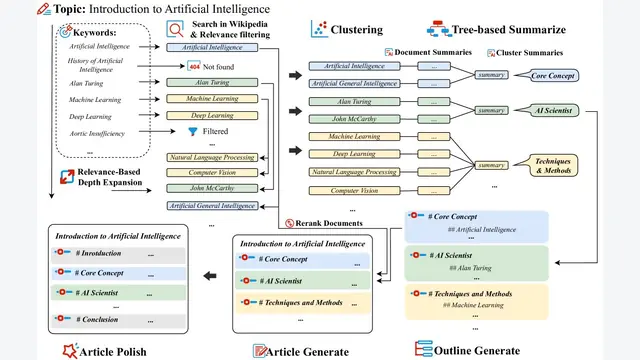
本文提出了一种名为 ConvergeWriter 的“自下而上”长文生成框架,它通过“先检索知识,后聚类定结构”的策略,确保文章的规划和生成完全由可用的知识数据驱动,从而根本上解决了传统“自上而下”方法中规划与知识脱节...
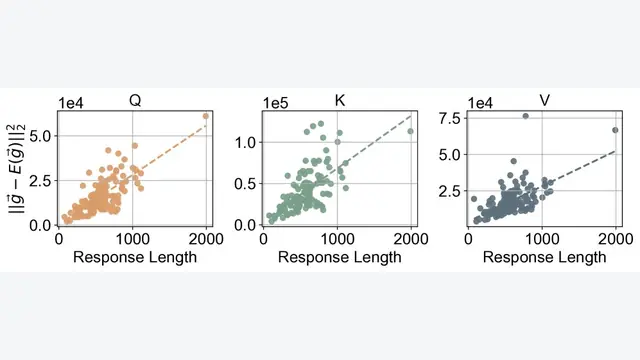
本文提出了一种名为 的新型损失聚合方法,通过构建一个无偏且方差最小的策略梯度估计器,有效解决了在带可验证奖励的强化学习(RLVR)中因响应长度变化巨大导致的高梯度方差和训练不稳定问题。
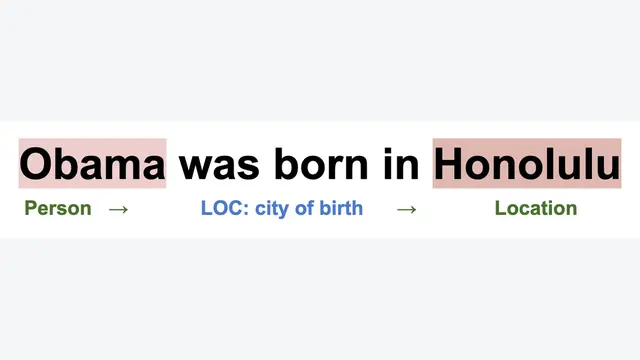
本文通过系统性的对比实验,证实了基于Transformer的模型在关系分类任务上,无论是在标准性能、长文本处理能力还是数据效率方面,均显著优于传统的非Transformer深度学习模型。
本文为生命科学领域的研究人员提炼了一份提示工程(Prompt Engineering)快速入门指南,重点介绍了六种核心技术(零样本、少样本、思维生成、集成、自我批评和分解),并提供了具体的用例、最佳实践和常见陷阱,旨在...
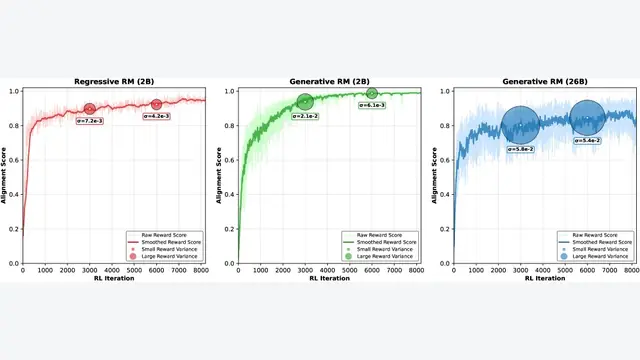
本文提出了RewardDance,一个基于生成式范式的可扩展视觉奖励模型框架,它通过将奖励预测重构为“是/否”Token预测任务,实现了对模型尺寸和上下文信息的有效扩展,从而显著提升了视觉生成模型的质量和对齐效果。
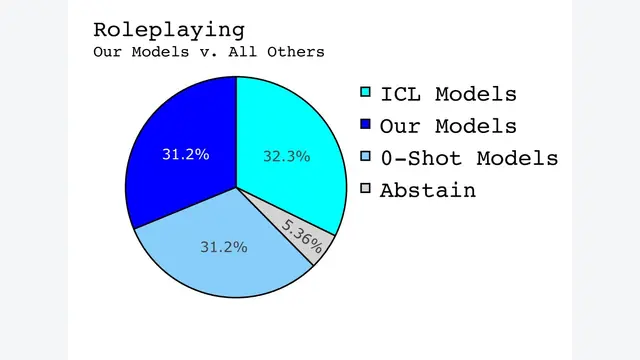
本文提出了一种名为 RAGs-to-Riches 的新颖提示框架,它将大语言模型(LLM)的角色扮演问题重构为一个类似检索增强生成(RAG)的文本检索任务,通过使用精心策划的、源于训练数据之外的参考范例,显著增强了模型...
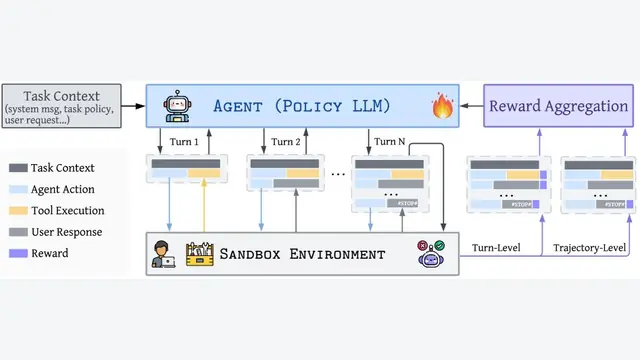
本文提出了一种名为“回合级评审强化学习” (Turn-level Adjudicated Reinforcement Learning, TARL) 的流程监督方法,该方法利用大型语言模型 (LLM) 作为裁判提供细粒...
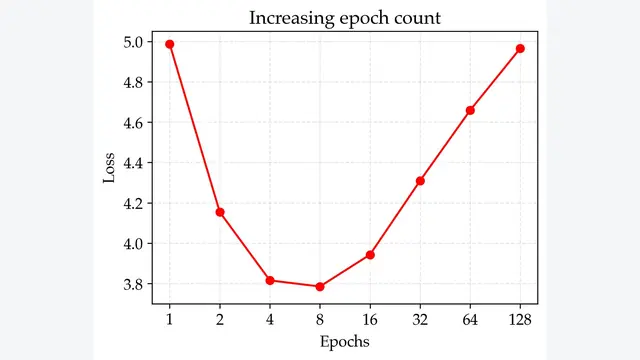
本文提出,在数据受限而计算资源无限的未来场景下,通过深度优化正则化、模型集成和知识蒸馏等经典算法,可以显著提升语言模型预训练的数据效率,其效果远超单纯增加训练轮次或模型参数的传统方法。
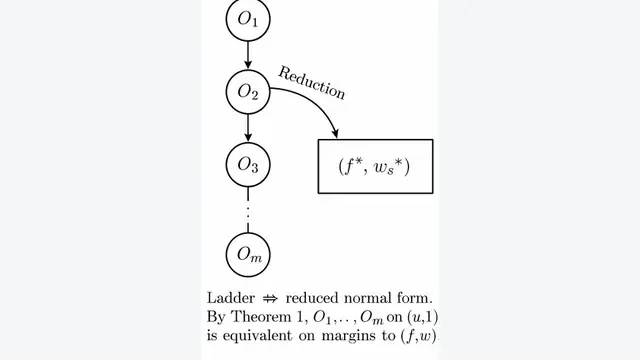
本文提出了Opal,一个用于强化学习从人类反馈(RLHF)的算子代数视图,以及GKPO,一个标准化的交换模式,通过一个当且仅当满足三个核心假设时成立的约简定律,来统一、比较和验证不同的RLHF目标函数,从而整理了该领域...