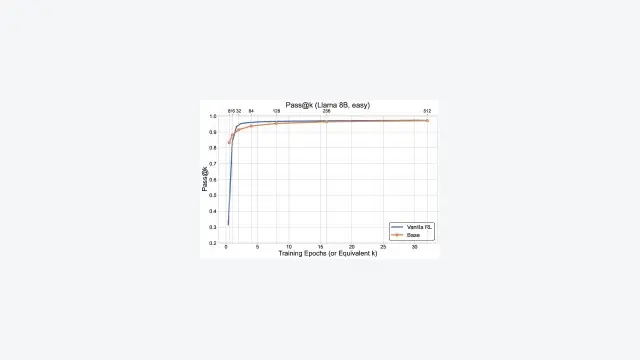
Outcome-based Exploration for LLM Reasoning
本文提出了一种“基于结果的探索”(Outcome-based Exploration)方法,通过在强化学习训练中根据最终答案(而非整个推理过程)给予探索奖励,有效提升了大型语言模型在推理任务上的准确率,同时缓解了传统R...
强化学习推理
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了一种“基于结果的探索”(Outcome-based Exploration)方法,通过在强化学习训练中根据最终答案(而非整个推理过程)给予探索奖励,有效提升了大型语言模型在推理任务上的准确率,同时缓解了传统R...
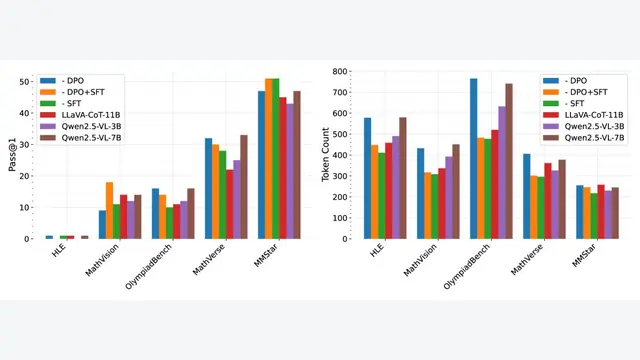
本文提出了一种困难度感知的思维链蒸馏框架,通过在与问题难度成比例的思维链(CoT)数据上进行后训练,教会大语言模型根据问题复杂性动态调整推理深度,从而在保持或提升准确率的同时,显著提升推理效率。
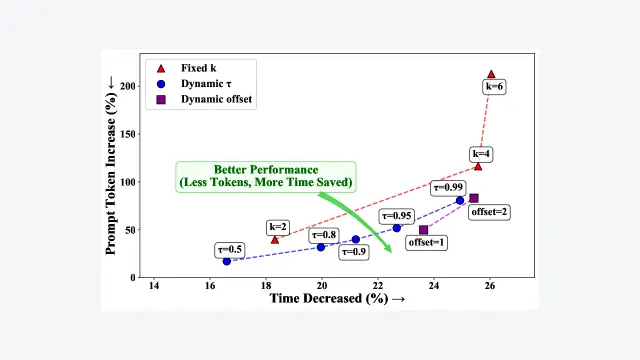
本文提出动态推测规划 (Dynamic Speculative Planning, DSP),一个通过在线强化学习自适应调整推测步骤(speculation step)的智能体规划框架,旨在实现无损加速的同时显著降低成...
本文通过博弈论中的迭代囚徒困境 (Iterated Prisoner’s Dilemma) 框架,系统地研究了语言模型智能体在长期交互中的合作与对抗行为,发现其表现不亚于甚至超越了顶尖的经典策略,并能快速适应对手策略的...
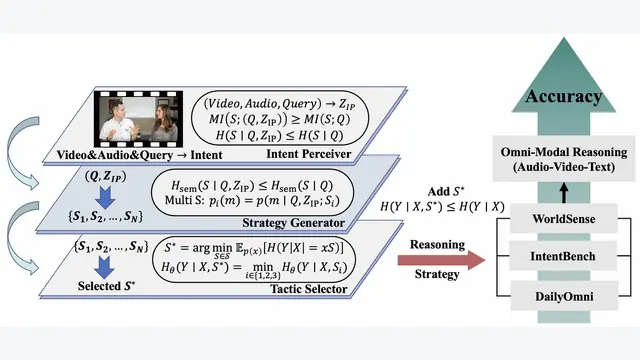
本文提出了一种名为 CogGuide 的零样本全模态推理组件,它通过模拟人类“理解-规划-选择”的认知过程,生成并筛选“意图简图”(intent sketch)策略来指导多模态大模型,从而在无需微调的情况下提升复杂推理...
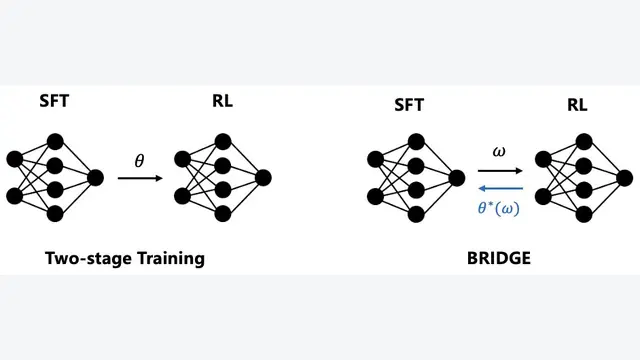
本文的核心是提出了一种新的训练框架,其关键概念根植于双层优化理论。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
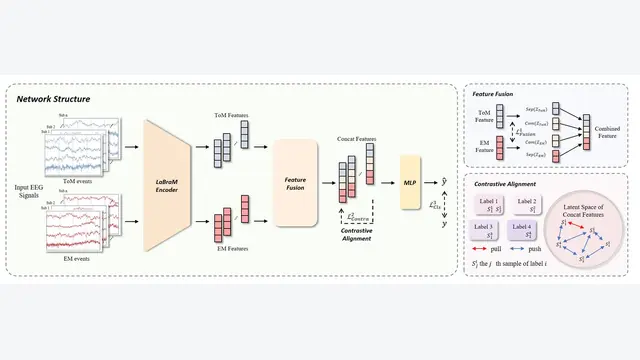
本文提出了一种名为 BEAM 的深度学习框架,它通过分析幼儿观看视频时的多视角脑电图(EEG)信号,结合特征融合与对比学习技术,实现了对儿童共情水平(表现为助人意愿)的客观、准确预测。
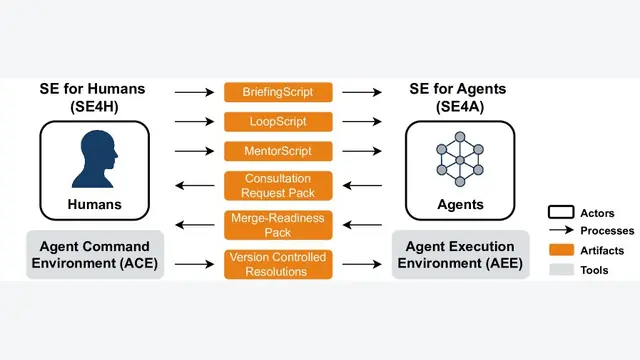
结构化智能体软件工程(SASE):基本支柱与研究路线图。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
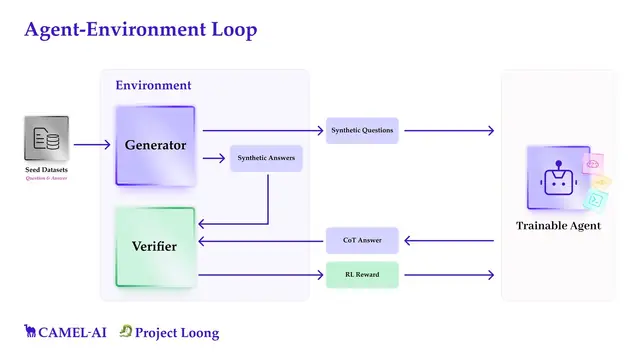
本文提出了Loong项目,一个旨在通过人工审查的种子数据集(LoongBench)和模块化的合成环境(LoongEnv),大规模生成跨多个推理领域、可自动验证的长链思维(Chain-of-Thoughts)数据,以解决...
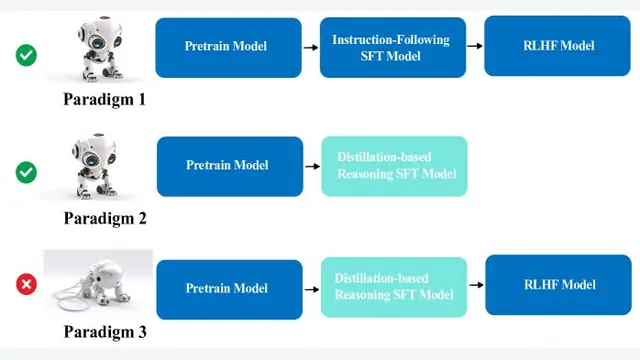
本文提出了一种名为“平衡智能体初始化 (Balanced Actor Initialization, BAI)”的两阶段加权模型合并方法,旨在解决当对经过蒸馏训练的推理模型应用强化学习(RLHF)时出现的训练不稳定问题...
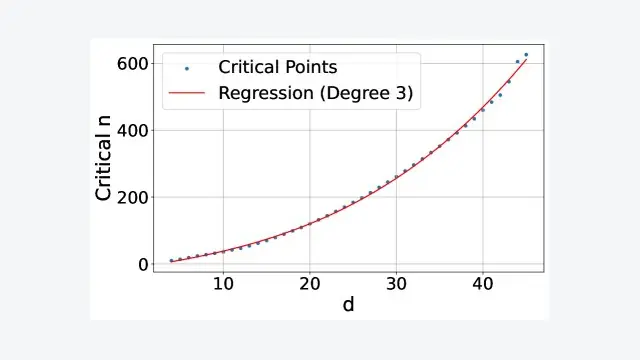
本文通过连接学习理论与嵌入式检索,从理论和实证上证明了单向量嵌入模型因其维度限制,无法表示所有可能的相关文档组合,并构建了一个名为LIMIT的简单数据集,揭示了即使是当前最先进的模型也存在这一根本局限性。
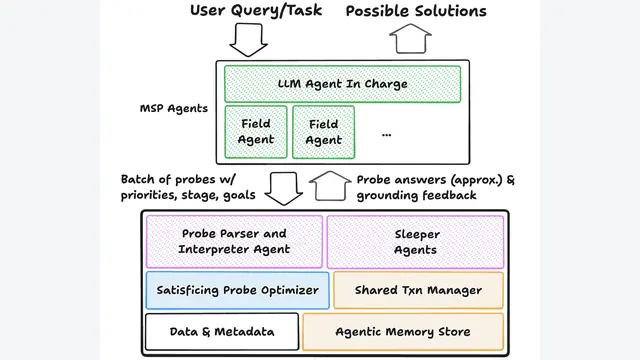
本文指出,未来的数据系统将主要服务于由大型语言模型(LLM)驱动的智能体,并提出了一种“智能体优先”(agent-first)的数据系统新架构,以高效处理智能体工作负载中普遍存在的高吞吐量、异构、冗余和可引导的“智能体...
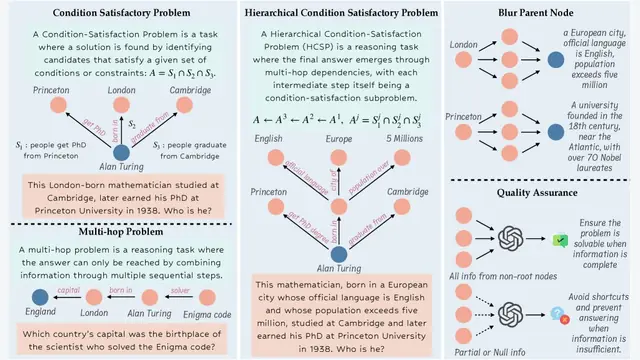
本文提出了一个名为 InfoSeek 的可扩展数据合成框架,它将复杂的“深度研究”任务形式化为分层约束满足问题(HCSP),并自动生成高质量的训练数据,使一个3B参数量的小模型在复杂的深度研究任务上,性能超越了32B的...
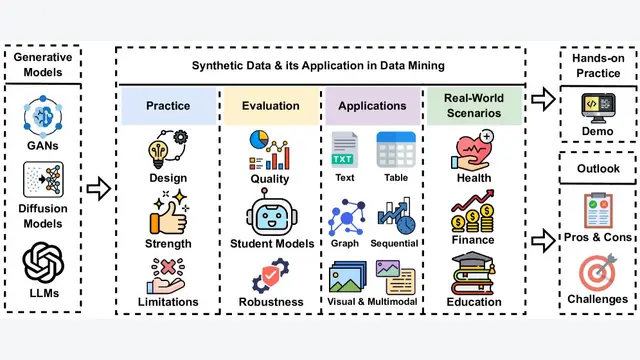
生成式模型用于合成数据:在GenAI时代变革数据挖掘。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
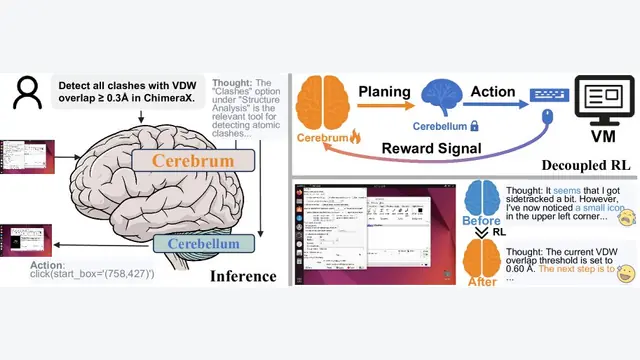
本文提出了一种名为 CODA 的可训练组合式智能体框架,它模仿人脑的大脑与小脑功能分离机制,通过解耦的强化学习和两阶段训练流程,协同一个通用规划器(大脑)和一个专用执行器(小脑),以有效解决科学计算等专业领域中长时序规...
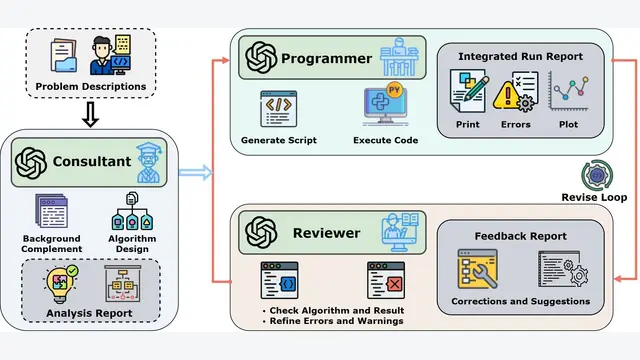
本文提出了一个名为 Re⁴ 的科学计算智能体 (Agent) 框架,它通过“重写-解决-审查-修订” (Rewriting-Resolution-Review-Revision) 的逻辑链,利用多个大型语言模型 (LL...
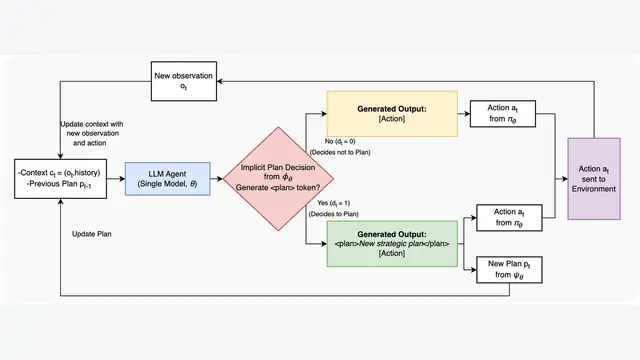
本文提出了一种两阶段训练方法(监督微调+强化学习),使大型语言模型(LLM)智能体能够学习在序贯决策任务中动态地决定何时进行规划,从而以更高效的计算成本实现更优的性能和更强的可控性。
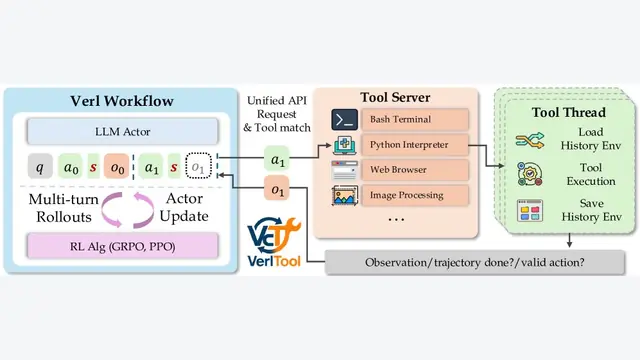
本文提出了 VerlTool,一个统一、模块化且高效的框架,旨在解决智能体强化学习与工具使用 (Agentic Reinforcement Learning with Tool use, ARLT) 领域的系统碎片化、...
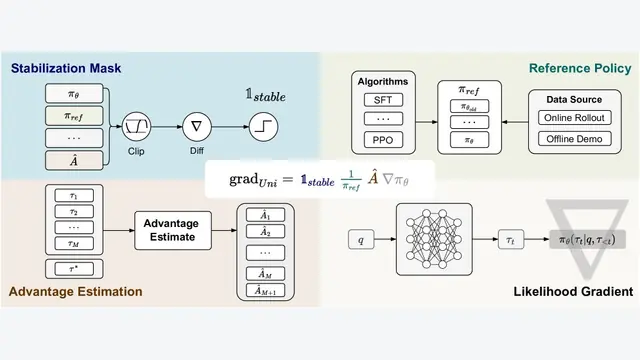
本文提出了一个统一的策略梯度估计器(UPGE),将监督微调(SFT)和强化学习(RL)两种后训练范式归纳到单一的优化目标下,并基于此设计了一种名为混合后训练(HPT)的新算法,该算法能根据模型的实时表现动态地在SFT和...
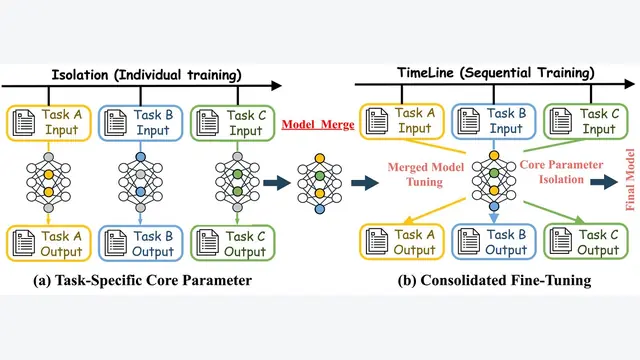
本文提出了一种名为“核心参数隔离微调”(CPI-FT)的新框架,通过识别并隔离每个任务的核心参数区域、根据区域重叠度对任务进行分组,并结合参数融合与动态冻结策略进行多阶段微调,从而有效缓解多任务监督微调中的任务冲突和灾...
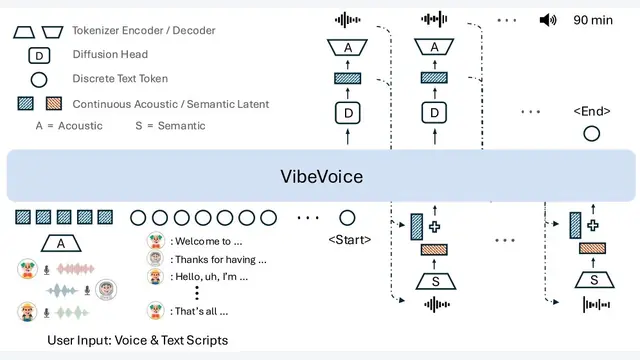
本文提出了一种名为 VibeVoice 的新模型,它通过一个创新的、具有超高压缩率的连续语音tokenizer和一个基于大型语言模型的下一token扩散框架,实现了长达90分钟、多达4人的高质量长篇对话语音合成。
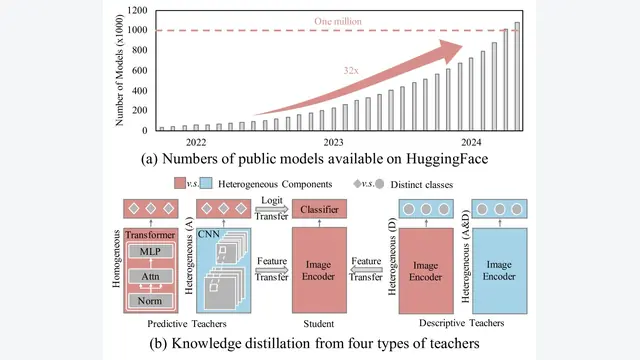
本文提出了一个名为 UNIFORM 的统一知识迁移框架,旨在从大量异构(不同架构、不同训练数据)的预训练模型中,通过新颖的特征投票和Logit投票机制,解决知识冲突问题,从而高效地将共识知识迁移到一个学生模型中,且无需...
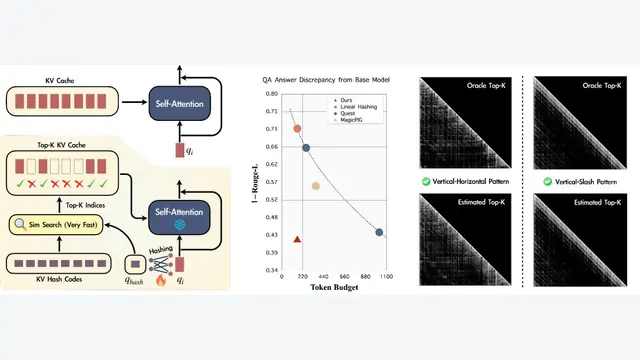
本文提出Spotlight Attention,一种通过可学习的非线性哈希函数来高效检索KV缓存(Key-Value Cache)的方法,从而在几乎不损失性能的前提下,显著提升大语言模型(LLM)的推理速度。
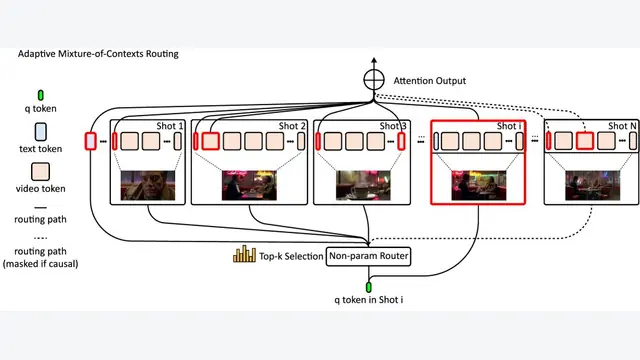
本文提出了一种名为上下文混合(MoC)的可学习稀疏注意力路由模块,将长视频生成问题重构为一个内部信息检索任务,从而在大幅降低计算成本的同时,实现了分钟级视频的长期记忆和一致性。