Memory-R1: Enhancing Large Language Model Agents to Manage and Utilize Memories via Reinforcement Learning
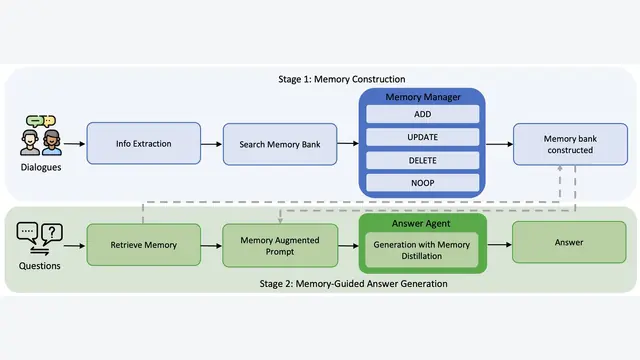
本文提出了Memory-R1框架,通过强化学习(RL)训练两个专门的智能体——一个用于结构化记忆操作的内存管理器和一个用于筛选并推理记忆的回答智能体,从而使大型语言模型(LLM)能够主动、自适应地管理和利用外部记忆,显...
知识系统AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了Memory-R1框架,通过强化学习(RL)训练两个专门的智能体——一个用于结构化记忆操作的内存管理器和一个用于筛选并推理记忆的回答智能体,从而使大型语言模型(LLM)能够主动、自适应地管理和利用外部记忆,显...
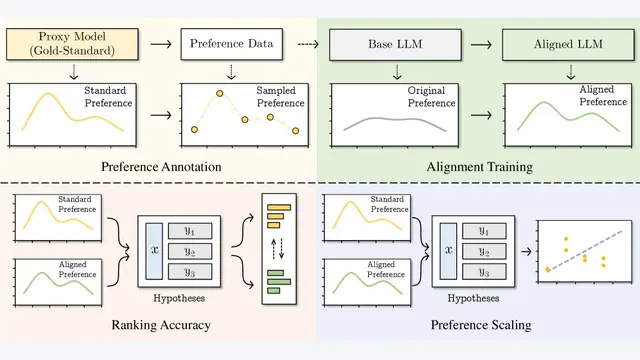
本文提出了一个名为HEAL的新型评估框架,它将大语言模型的偏好对齐问题重新定义为在“假设空间”内的重排序过程,并通过排序准确性和偏好强度相关性两个新指标,更全面地分析现有偏好学习方法。
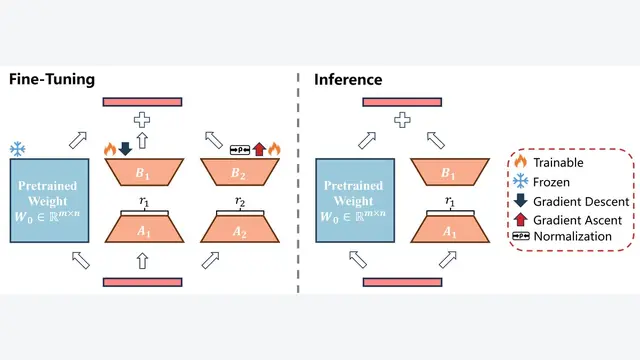
本文提出了一种名为 Bi-LoRA 的高效微调框架,它通过引入一个独立的辅助 LoRA 模块来模拟锐度感知最小化(SAM)的对抗性扰动,从而在不增加额外计算成本(仅需一次反向传播)的情况下,有效提升大模型微调的泛化能力。
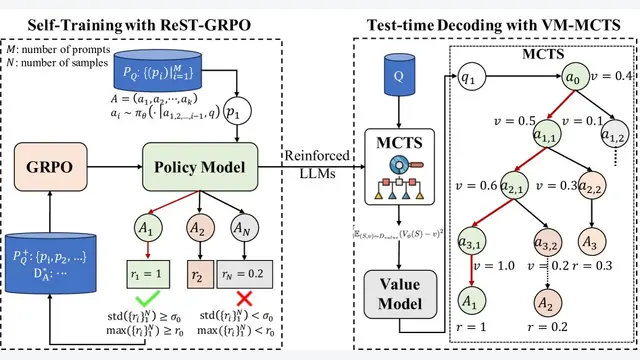
本文提出了一种名为 ReST-RL 的统一强化学习范式,通过将优化的自训练算法 (ReST-GRPO) 与基于价值模型 (Value Model) 的蒙特卡洛树搜索解码方法 (VM-MCTS) 相结合,显著提升了大型语...
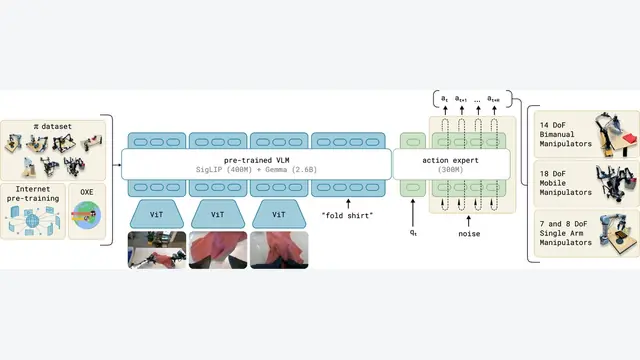
A Vision-Language-Action Flow Model for General Robot Control。
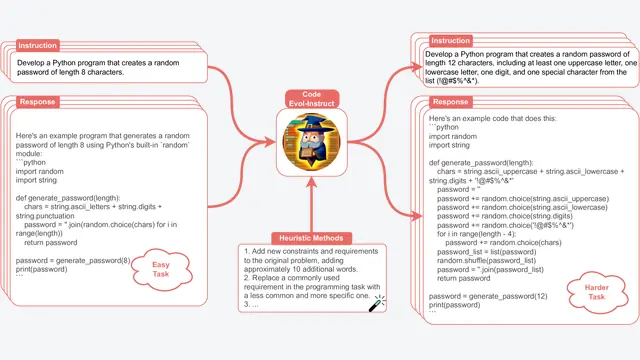
本文提出了一种名为 的方法,通过自动进化和增强编程指令的复杂性,来精调(fine-tune)代码大语言模型,从而创造出在多个基准测试中性能卓越的 模型系列。
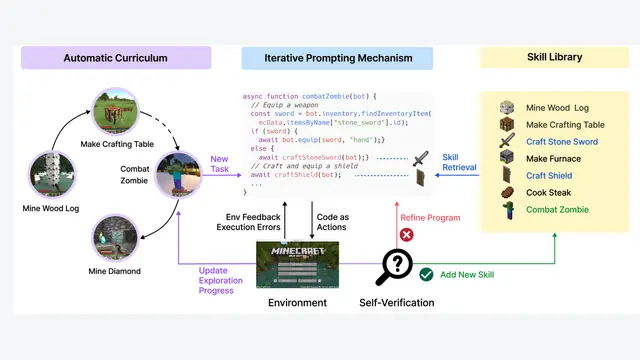
本文提出了一种名为 Voyager 的具身智能体,它首次利用大型语言模型(LLM)实现了在《我的世界》(Minecraft) 开放世界中的无干预终身学习,通过自动课程、可不断增长的技能库和迭代提示机制,持续探索、获取技...
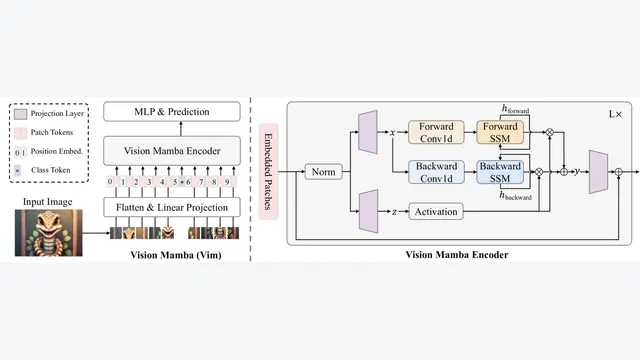
本文提出了一种名为 Vision Mamba (Vim) 的通用视觉骨干网络,它通过将双向状态空间模型 (SSM) 和位置嵌入相结合,在不使用自注意力机制的情况下,实现了与 Vision Transformer 相媲美...
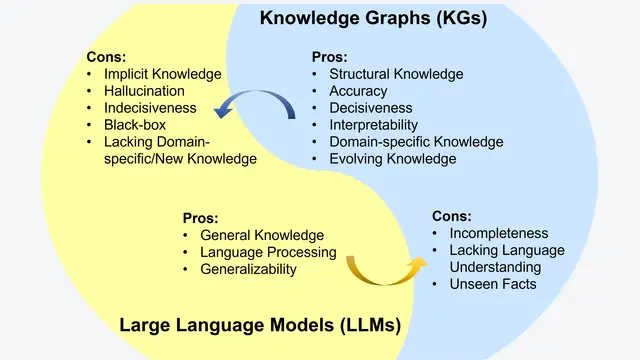
大语言模型(Large Language Models, LLMs),例如ChatGPT和GPT-4,因其涌现能力和泛化性,在自然语言处理和人工智能领域引发了新的浪潮。然而,LLMs是黑箱模型,常常难以捕获和访问事实性...
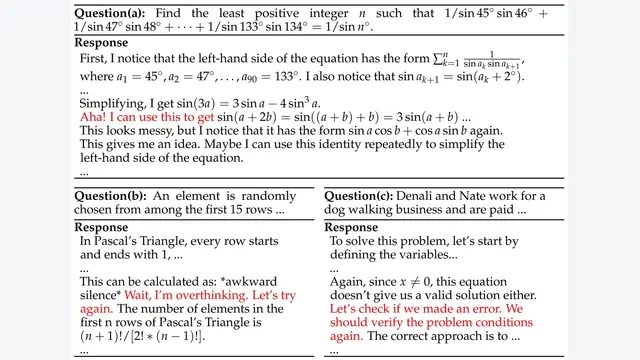
本文通过剖析 R1-Zero 类训练,揭示了其基座模型与强化学习算法(GRPO)中存在的偏见,并提出了一种无偏的优化方法 Dr. GRPO,从而以更高效的方式提升了模型的数学推理能力。
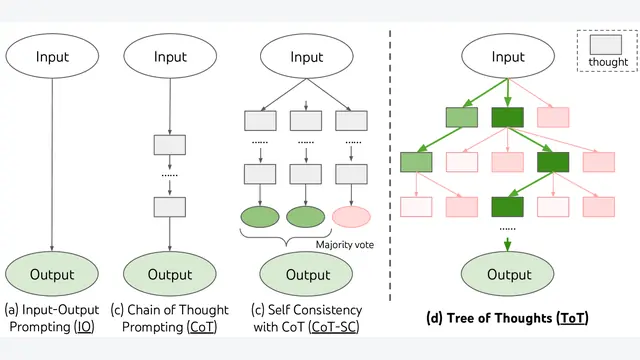
本文提出了一种名为“思想树”(Tree of Thoughts, ToT)的新型语言模型推理框架,它通过将问题解决过程建模为对“思想”(连貫的文本单元)树的探索,使大型语言模型能够进行深思熟虑的决策、前瞻和回溯,从而显...
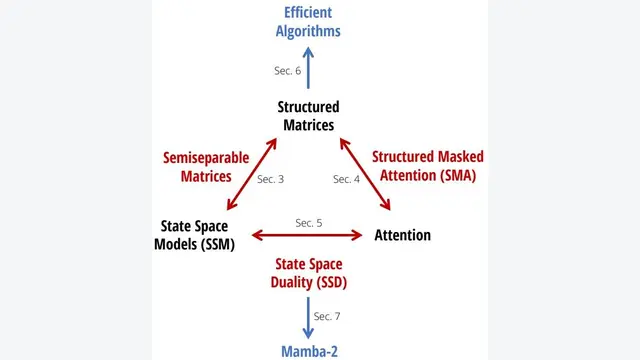
本文通过揭示结构化状态空间模型 (SSM) 与注意力机制在结构化半可分矩阵 (semiseparable matrices) 理论下的对偶关系,提出了一个名为“状态空间对偶 (State Space Duality, ...
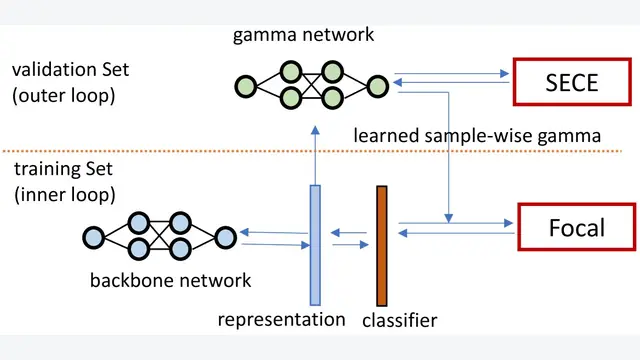
本文提出了一种名为元正则化 (Meta-Regularization) 的新方法,通过一个元学习框架来学习无偏的、校准良好的深度学习模型。该方法包含两个核心组件:一个能为Focal Loss学习样本级连续 值的 -Ne...
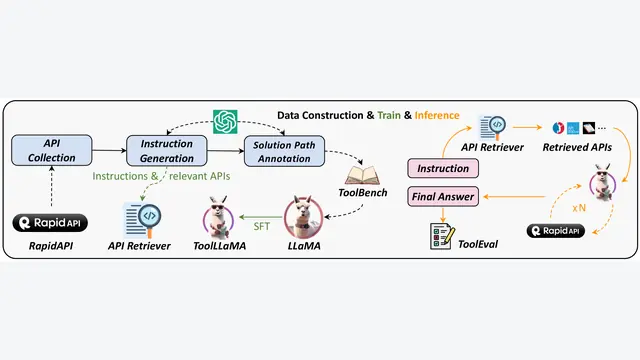
本文提出了一个名为ToolLLM的通用工具使用框架,通过构建一个包含超过16000个真实世界API的大规模指令微调数据集ToolBench,并采用一种新颖的深度优先搜索决策树(DFSDT)方法,成功地将开源大语言模型(...
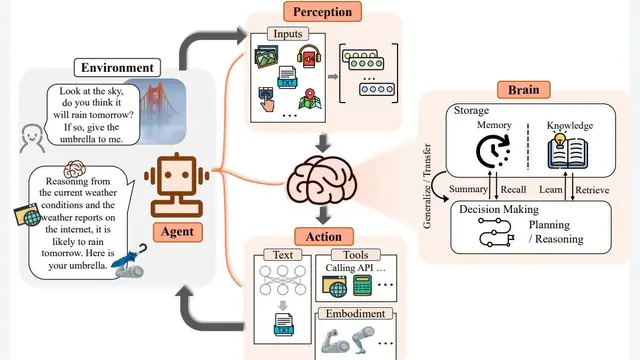
The Rise and Potential of Large Language Model Based Agents: A Survey。
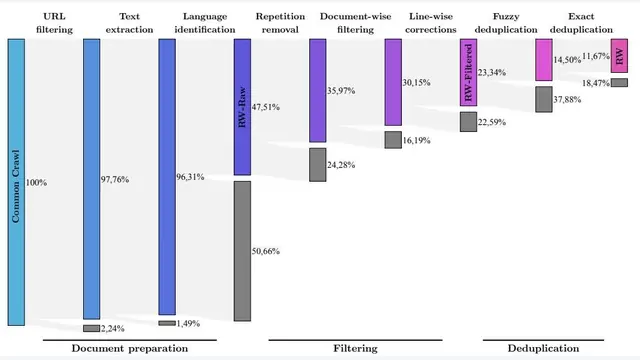
本文提出了一种仅使用网页数据,通过大规模精细过滤和严格去重,就能训练出顶尖大语言模型(LLM)的方法,并发布了由此产生的5万亿token数据集RefinedWeb,挑战了LLM预训练必须混合“高质量”精选语料库的传统认知。
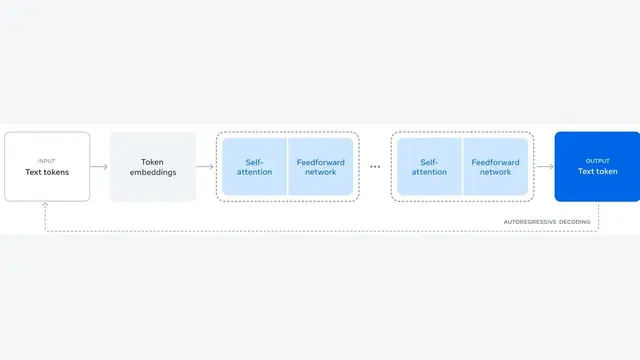
本文介绍了 Llama 3 模型家族,其中旗舰模型是一个拥有 405B 参数的密集型 Transformer,通过在 15T 多语言 token 上进行大规模预训练,并采用稳定可扩展的架构和训练方法,使其在多项基准测试...
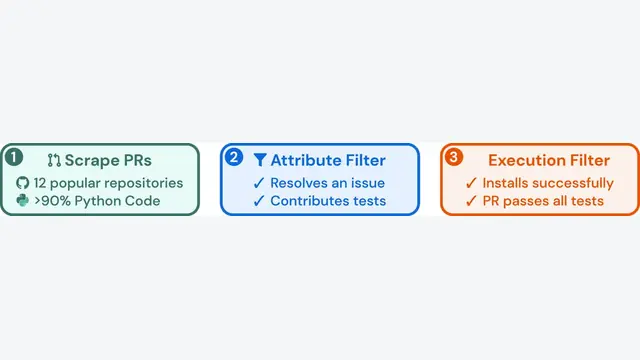
本文提出了一个名为 SWE-bench 的大规模、真实世界的软件工程基准,通过要求语言模型(Language Models, LMs)解决来自12个流行Python仓库的真实GitHub问题,发现即使是最先进的模型也难...
本文通过对香港399名大学生的问卷调查,揭示了学生对生成式AI(如ChatGPT)普遍持积极态度,认可其在个性化学习、写作和研究方面的潜力,但同时也对技术的准确性、隐私伦理、对个人能力发展和未来职业的冲击表示了显著担忧。
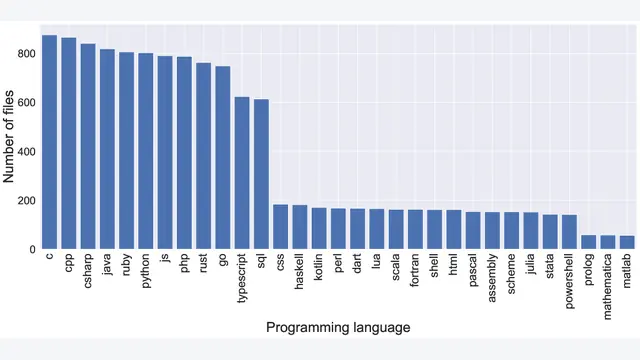
本文发布了StarCoder,一个拥有155亿参数、支持8K上下文长度和代码填充能力的开源代码大语言模型;该模型在经过精心筛选和隐私信息处理的 permissively licensed 代码数据集上进行训练,其性能超...
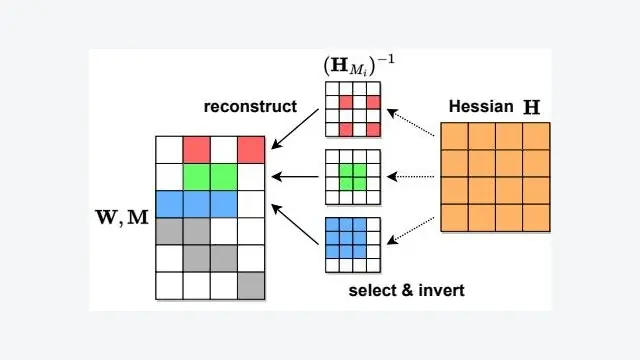
本文提出了一种名为 SparseGPT 的新颖剪枝方法,能够对超大规模语言模型(如 OPT-175B)进行一次性(One-Shot)剪枝,在不进行任何重新训练的情况下,达到50%-60%的稀疏度,同时保持极低的准确率损失。
本文提出并开源了第一个完全基于西班牙语料库预训练的BERT模型(BETO),并构建了一个名为GLUES的西班牙语NLP任务评估基准,实验证明该单语模型在多数西班牙语下游任务上的表现优于同等规模的多语言BERT模型。
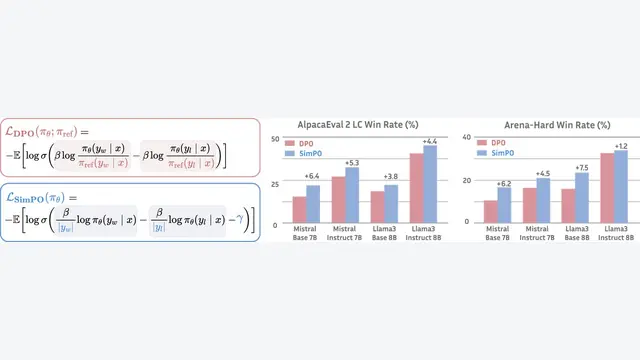
本文提出了一种名为 SimPO 的简单偏好优化算法,它通过使用一个无需参考模型、与生成过程对齐的长度归一化奖励,在提升模型性能的同时,显著提高了训练的计算和内存效率。
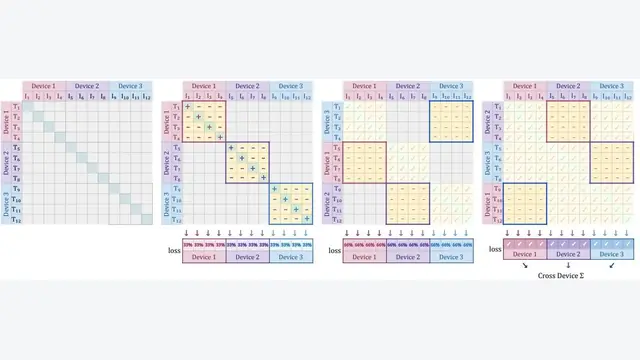
本文提出了一种用于语言-图像预训练的简单成对 Sigmoid 损失函数 (Sigmoid loss),它将对比学习任务转化为对图文对的独立二元分类,从而解耦了损失计算与批次大小 (batch size) 的依赖,实现了...