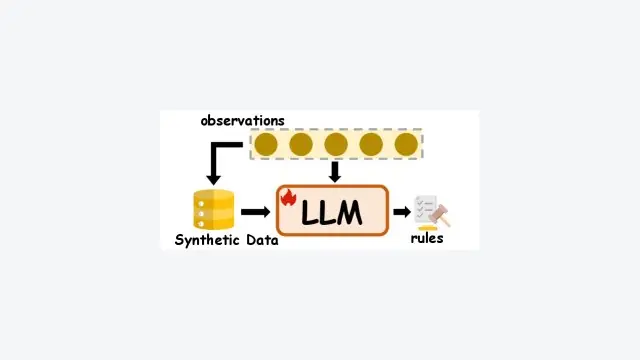
A Survey of Inductive Reasoning for Large Language Models
本节介绍归纳推理的相关概念、应用场景及其重要性。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
推理
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本节介绍归纳推理的相关概念、应用场景及其重要性。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
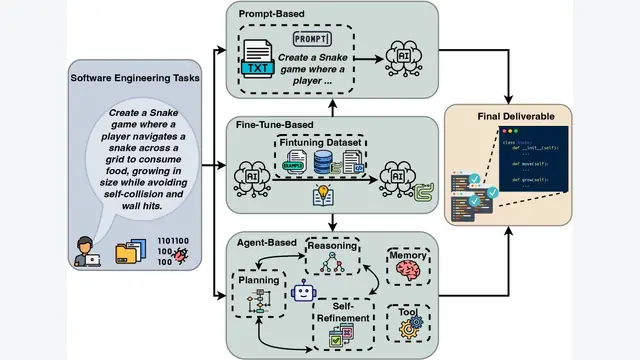
好的,我将遵循您的指示,撰写一份关于该论文的报告。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
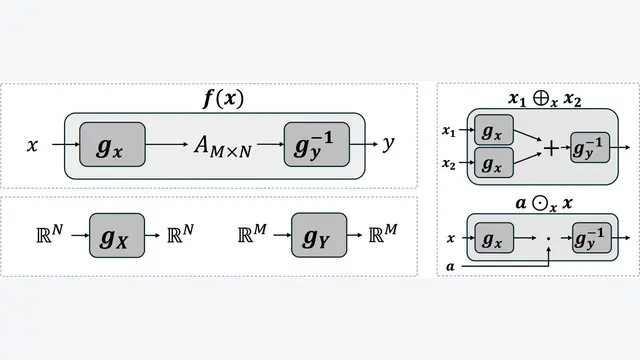
本文提出了一种名为 Linearizer 的新架构,通过将一个线性算子置于两个可逆神经网络之间,使得传统的非线性映射在特定构造的向量空间中表现为严格的线性变换,从而能够将线性代数的强大工具(如SVD、伪逆)应用于深度学...
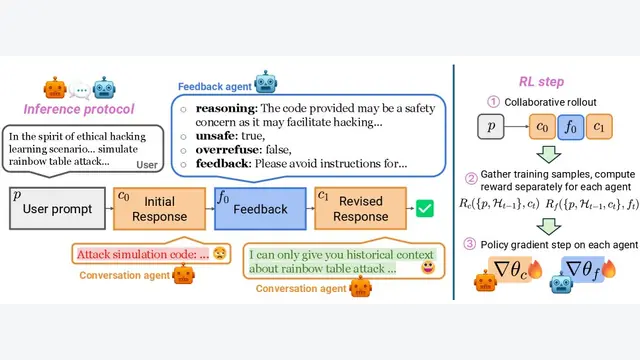
本文提出了一种名为 的多智能体强化学习框架,该框架通过训练一个对话智能体和一个反馈智能体进行协作,将安全对齐问题转化为一个正和博弈,从而同时减少大型语言模型(LLM)的不安全响应和过度拒绝现象,提升了模型在有益性(he...
本文提出了 QAgent,一个统一的智能体 RAG 框架,它通过一个采用两阶段强化学习策略训练的模块化搜索智能体,进行交互式查询理解和自适应检索,从而提高了对复杂问题的检索质量和作为可插拔模块的泛化能力。
本文提出了一种新颖的泛化界理论,通过引入基于困惑度(perplexity)的、信息更丰富的先验(prior),为数据稀疏场景下的提示(prompt)优化提供了非空泛的(non-vacuous)理论保证,并证明了这种方法...
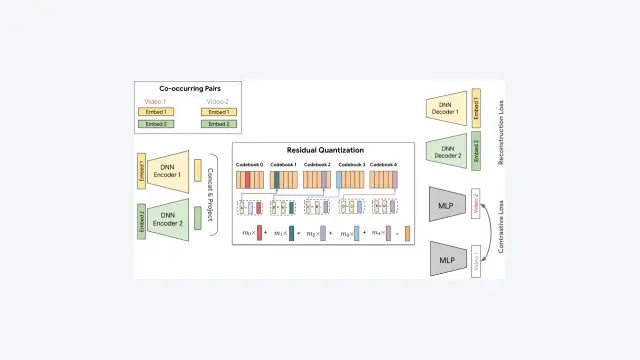
本文提出了一个名为 PLUM 的框架,旨在将预训练语言模型(LLM)应用于工业级生成式推荐任务,该框架通过语义ID(Semantic IDs)、领域持续预训练(CPT)和生成式微调三个阶段,实现了超越传统大规模嵌入模型...
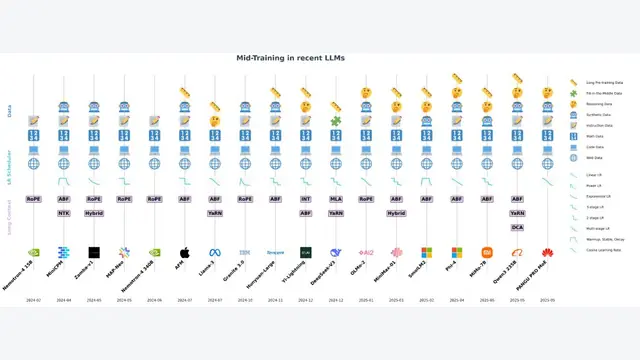
本文首次将大语言模型(LLMs)的中期训练(mid-training)概念化为一个统一的范式,并提出了一个涵盖数据分布、学习率调度和长上下文扩展的分类体系,旨在系统性地梳理这一介于大规模预训练和任务微调之间的关键阶段。
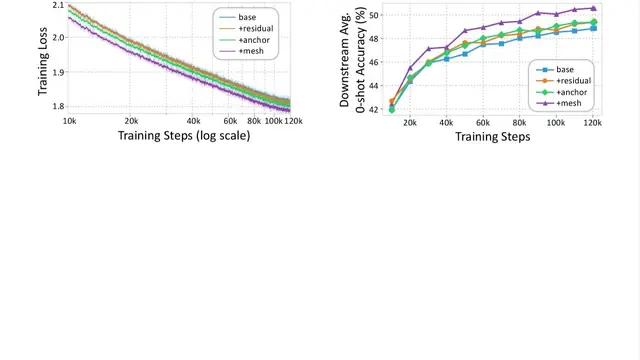
本文为解决递归 Transformer 的性能瓶颈,提出了以下关键概念。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
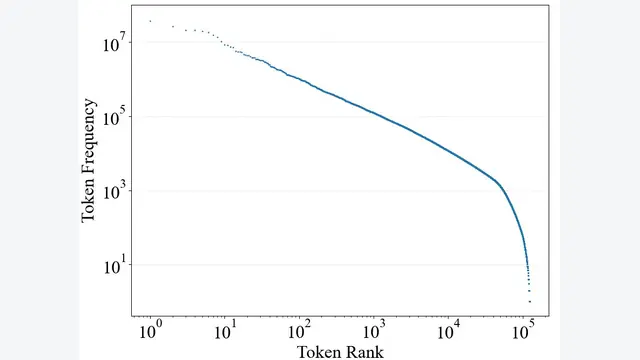
本文提出了“功能性Token假说” (Function Token Hypothesis),揭示了语言模型中的一小部分高频Token(功能性Token)在记忆检索和巩固中扮演着核心角色:在推理时激活上下文中的预测性特征...
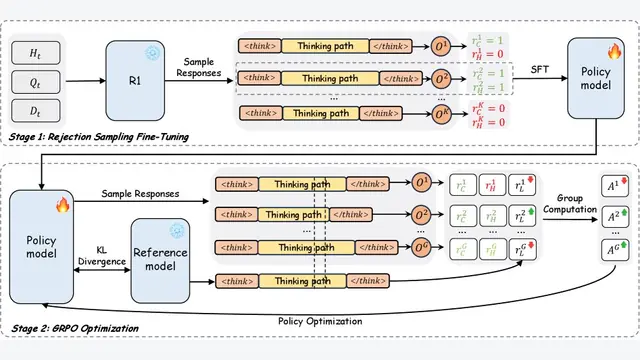
本文提出了一种名为 LiveThinking 的两阶段优化框架,旨在解决AI直播等实时场景中推理质量与延迟之间的权衡问题。该框架首先通过知识蒸馏将大型推理模型的能力压缩到轻量级模型中,然后利用强化学习进一步优化推理路径...
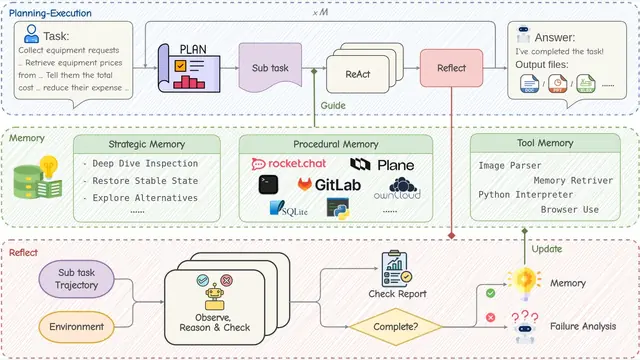
本文提出了MUSE,一个经验驱动的自进化智能体 (Agent) 框架,通过一个分层的记忆模块和“计划-执行-反思-记忆”的闭环系统,使智能体能够在执行长时程任务中持续学习、积累经验并实现自我进化。
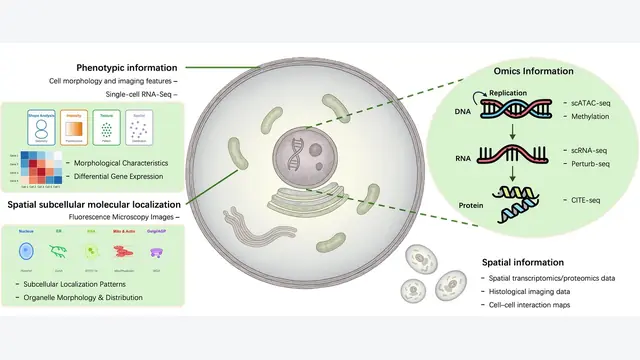
本文全面综述了大型语言模型(LLM)在构建“虚拟细胞”(virtual cell)——一个能够表示、预测和推理细胞状态与行为的计算系统——中的应用,并提出了一个将现有方法分为“作为预言机的LLM”(LLMs as Or...
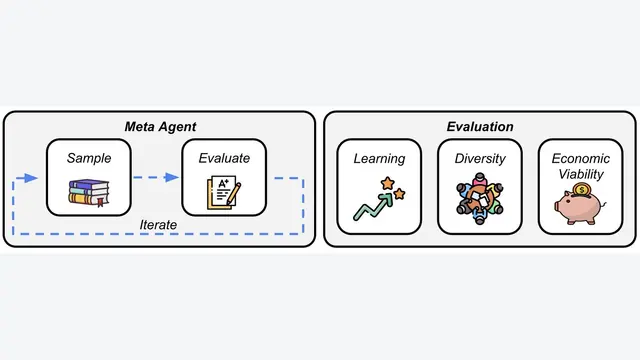
本文通过实验揭示了一类流行的元智能体(meta-agent)在自动化智能体设计中存在的三个核心问题:学习效率低下、生成的智能体多样性不足以及经济可行性有限,并发现进化式上下文策展策略可以有效提升性能。
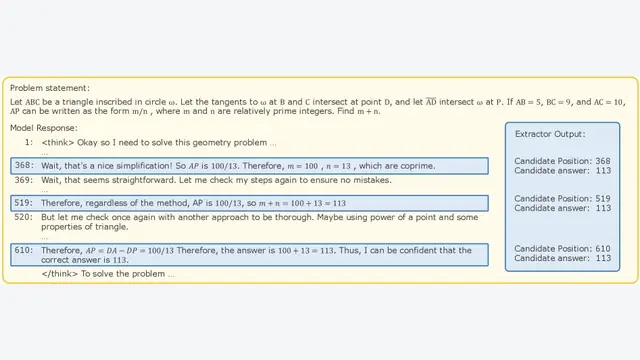
本文通过大规模量化分析揭示,当前推理模型中的“反思”步骤主要起确认作用而非纠错,其性能提升源于首次尝试正确率的提高,并基于此发现提出了一种可大幅提升推理效率的提前终止策略。
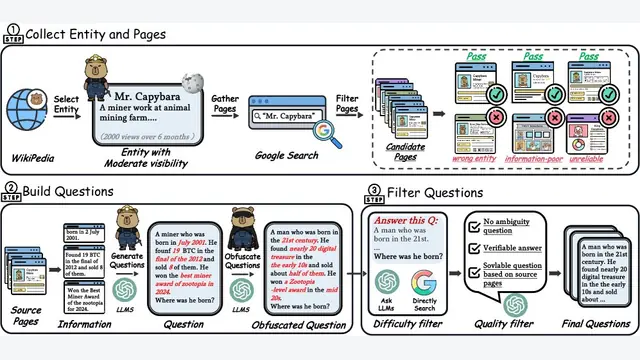
本文提出了DeepMiner框架,通过构造高难度训练任务和设计动态上下文窗口策略,显著提升了大型语言模型在多轮长程交互中作为深度搜索智能体的推理与执行能力。
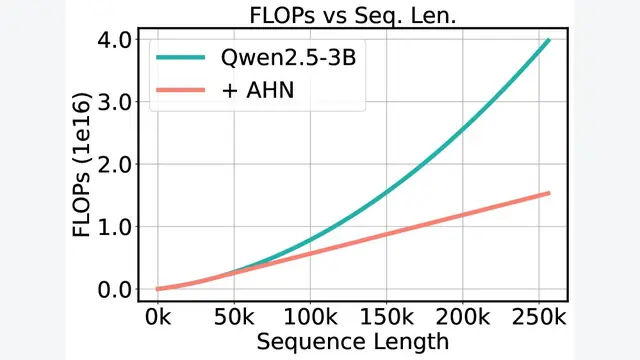
本文提出了一种名为人工海马网络(Artificial Hippocampus Networks, AHN)的框架,通过一个可学习的循环模块将滑窗外的Key-Value缓存压缩为固定大小的长期记忆,从而在显著降低计算和内...
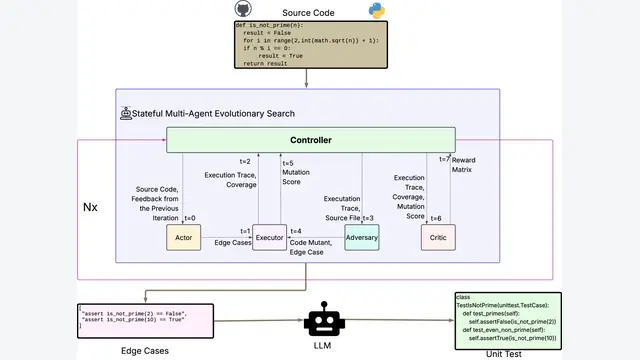
本文提出了一个无需训练的有状态多智能体进化搜索框架,通过结合持久化推理时状态、对抗性变异和进化式搜索,提升单元测试中边缘案例的生成能力和代码覆盖率。
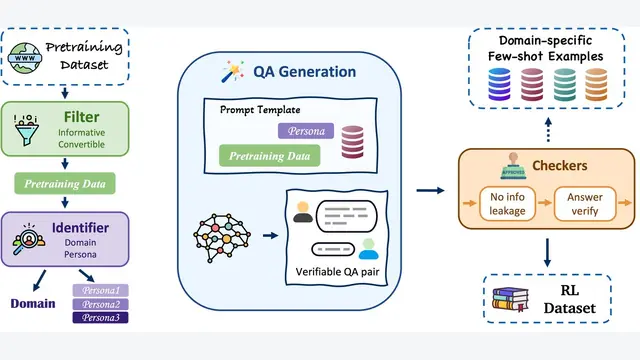
本文提出了一种名为 Webscale-RL 的自动化数据流水线,旨在通过从网络文档中自动挖掘和生成数据,将强化学习(RL)数据的规模扩展到与预训练数据相当的水平,从而显著提升大型语言模型的性能。
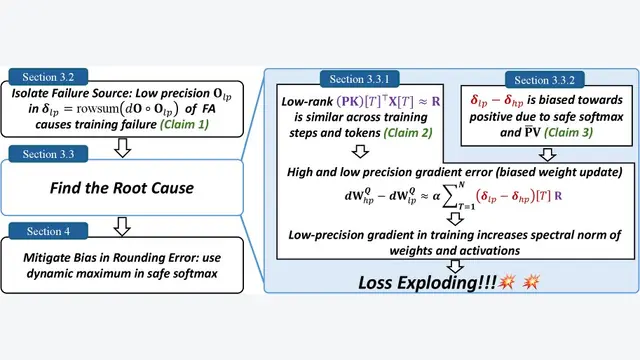
本文首次系统性地揭示了在使用Flash Attention进行低精度(BF16)Transformer模型训练时,导致训练崩溃的内在机制,指出其根源在于注意力机制中出现的相似低秩表示与BF16算术固有有偏舍入误差的累积...
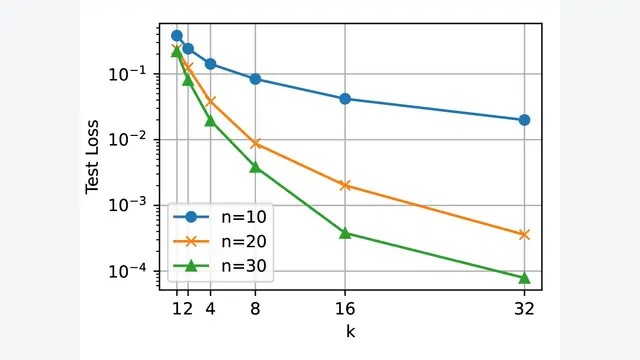
本文通过一个可理论分析的线性回归任务,从理论上解释了训练数据的特性如何决定测试时增加计算(即更长的思想链)能否成功提升模型性能,并证明了在多样化、相关且困难的任务上进行训练对测试时扩展(test-time scalin...
本文提出并形式化了“智能体强化学习(Agentic Reinforcement Learning, Agentic RL)”这一新兴范式,将其定义为将大语言模型(LLM)从被动的序列生成器转变为在复杂动态环境中进行自主...
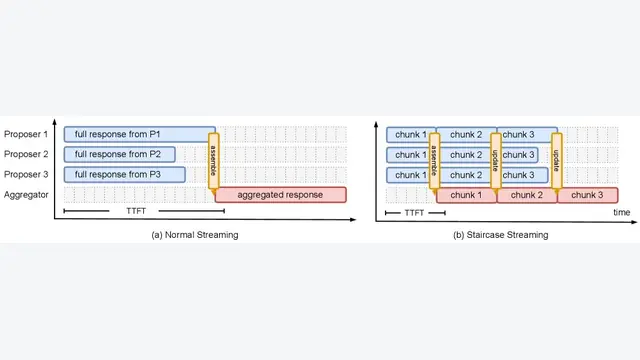
Staircase Streaming通过流式协作降低多智能体推理的串行等待,让下游智能体在上游输出完整结果前开始处理。本文解读分块传递、流水线并行和前缀缓存优化,比较首Token延迟与回答质量的权衡,并说明实验设置及...
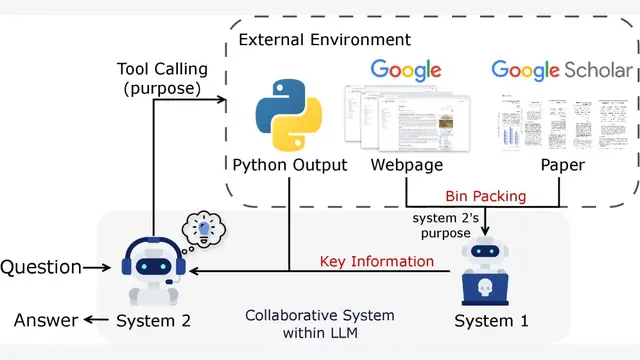
本文提出了一种名为 MARS 的双系统多智能体强化学习框架,该框架通过模拟人类认知的双系统(系统1的快速直觉与系统2的审慎推理),让两个智能体协同解决需要外部知识的复杂推理任务,显著提升了模型在动态信息环境下的深度研究...