A Comprehensive Survey on World Models for Embodied AI
面向具身智能的世界模型综合综述。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
具身智能
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
面向具身智能的世界模型综合综述。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
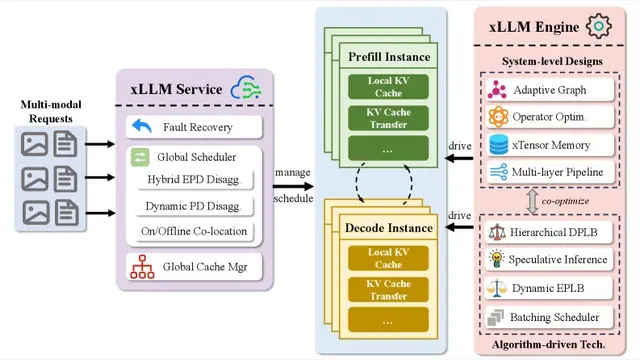
本文提出了一种名为 xLLM 的智能高效的大语言模型推理框架,其采用创新的服务-引擎解耦架构,通过智能调度与系统级协同优化,专为高性能、大规模的企业级服务而设计,解决了混合负载、资源利用率低和硬件适配性差等核心挑战。
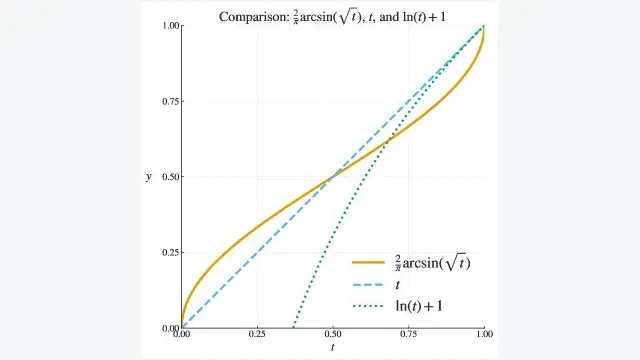
本文通过一个统一的数学框架证明,多种用于大型语言模型的流行强化学习算法(如REINFORCE、拒绝采样和GRPO),在处理二元奖励时,都可以被看作是在给定提示下获得正确答案概率的某个单调变换函数上的随机梯度上升,从而揭...
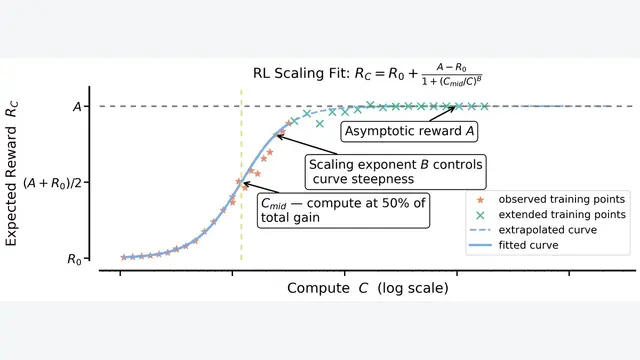
本文通过大规模系统性研究,首次为大语言模型(LLMs)的强化学习(RL)训练提出了一个可预测的规模化框架,并基于此提出了一套名为 的最佳实践方法,旨在将RL训练的规模化从“艺术”转变为可预测的“科学”。
本文证明,通过将大规模测试时搜索算法(test-time search)应用于开源代码大语言模型(如 Code Llama-70B),可以在国际信息学奥林匹克(IOI)竞赛级别的算法问题上达到金牌水平,这一成就先前被认...
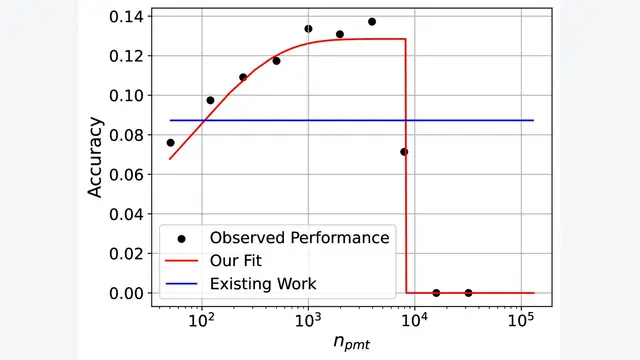
本文提出了一个简洁、可解释的上下文感知缩放定律 (context-aware scaling law) 框架,该框架通过一个函数联合建模了训练计算量和上下文长度,从而能够准确预测和推断大型语言模型在下游任务中的性能。
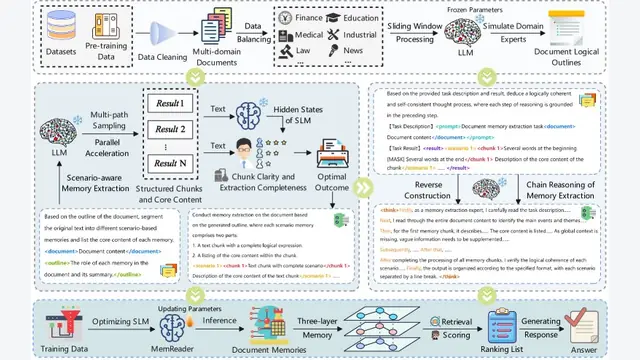
MoM通过模拟专家阅读,把RAG中的被动文本分块改为主动提取结构化文档记忆。本文解读文档大纲、核心内容和原子分块的提取,以及三层文档记忆检索流程,说明这种设计如何组织不同粒度的信息,并讨论实验结果和适用边界。
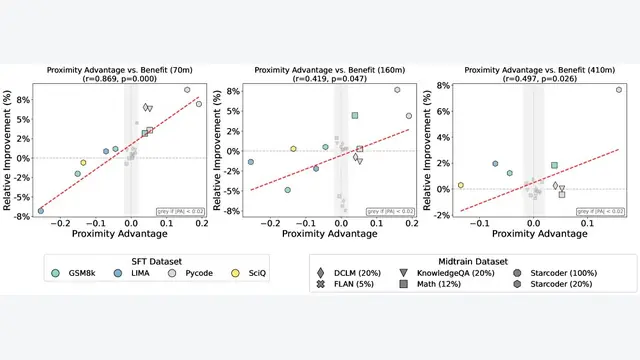
本文系统地研究了“中训练 (Midtraining)”这一新兴实践,发现其通过在通用预训练和特定任务微调之间构建一个分布桥梁,能有效提升模型在数学和代码等领域的下游任务性能,并显著减少灾难性遗忘。
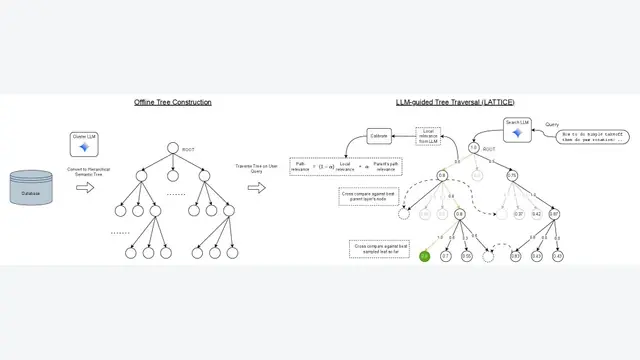
本文提出了一种名为 LATTICE 的LLM引导分层检索框架,通过将海量文档组织成语义树,并让大型语言模型(LLM)基于创新的校准路径相关性得分进行推理和导航,从而以对数级的搜索复杂度高效解决复杂的推理密集型查询。
本文提出了一种名为 LLM-ERM 的新型程序学习算法,该算法通过大型语言模型(LLM)引导的搜索来高效地最小化经验风险,从而仅需极少量(例如1-2个)的输入输出样例就能成功合成正确的程序。
本文提出了一种名为 GatePro 的新型、无参数的专家选择优化方法,它将 MoE 模型中的专家选择问题构建为一个最优传输问题,无需可学习的门控参数或人工调整的负载均衡损失函数,即可实现高效且稳定的专家分配。
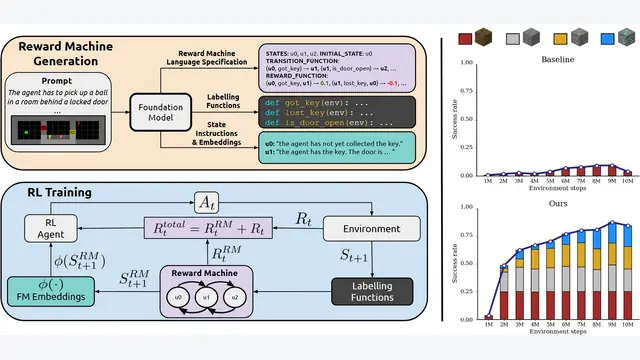
本文提出了ARM-FM框架,利用基础模型(Foundation Models, FMs)从自然语言指令中自动生成奖励机(Reward Machines, RMs),为组合式强化学习(Compositional Rein...
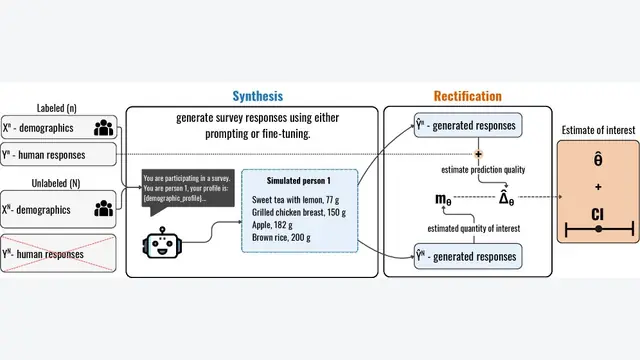
本文提出了一种将大型语言模型(LLM)用于调查问卷模拟的有效框架,其核心思想是:不应将所有宝贵的人类数据用于微调模型,而应将大部分数据用于对LLM生成的大量合成数据进行统计校正(Rectification),从而在有限...
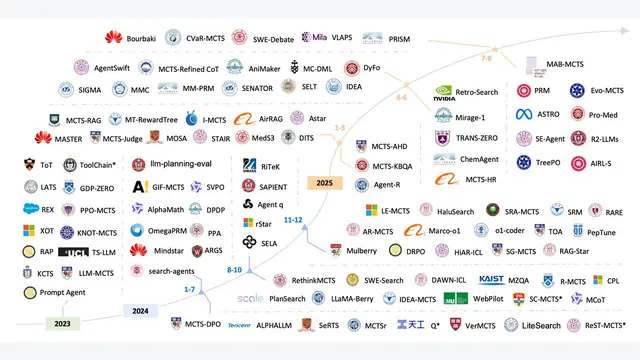
随着大型语言模型 (LLM) 的扩展定律进入回报递减的阶段,研究前沿正从数据和参数的暴力增长转向算法效率和新的推理形式。在此背景下,两个相互关联的范式成为核心:深思熟虑的推理时搜索 (deliberative Test...
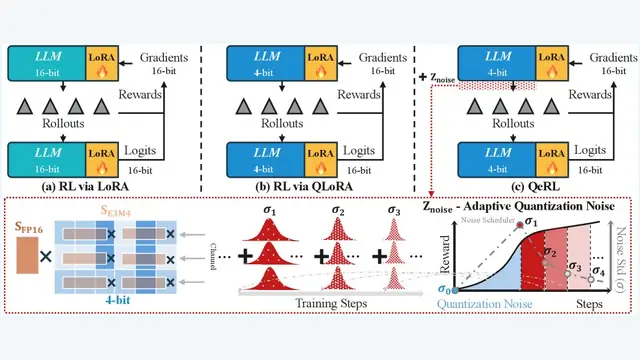
本文提出了QeRL,一个量化增强的强化学习框架,它通过利用量化噪声来提升策略探索,在显著加速大模型强化学习(RL)训练、降低显存占用的同时,实现了超越16位基线方法的性能。
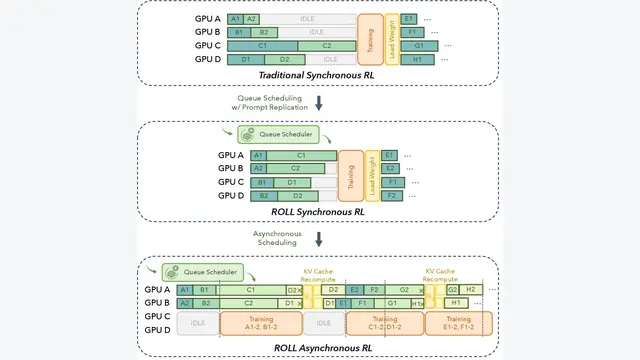
本文提出了 ROLL Flash,一个通过引入异步机制来解耦 rollout 和训练阶段的系统,从而显著提升了强化学习后训练(RL Post-Training)的吞吐量和资源可扩展性,同时通过精细化的陈旧度控制确保了模...
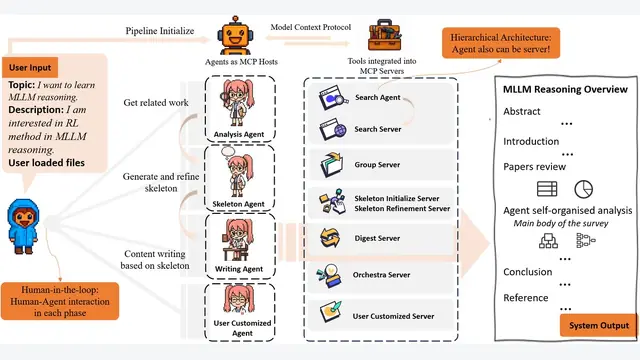
本文提出了一种名为 LLM×MapReduce-V3 的分层模块化智能体系统,该系统通过模型-上下文-协议 (MCP) 驱动的动态规划,实现了交互式、可定制的深度综述论文生成。
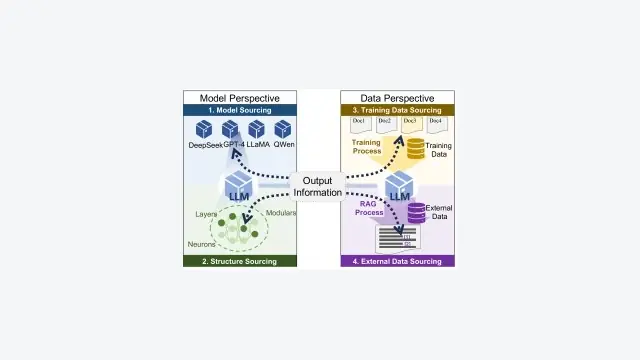
大语言模型溯源:一篇综述。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
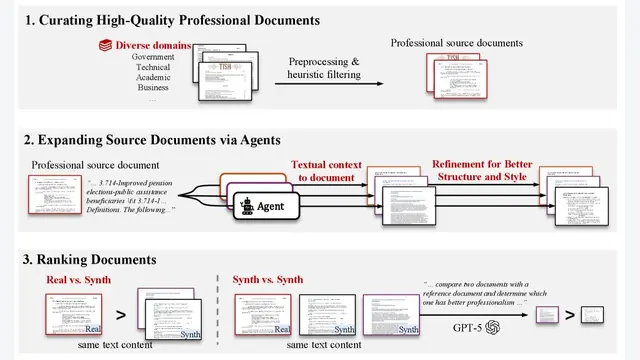
本文提出了一种名为 DocReward 的文档奖励模型,它通过在一个包含117K对文档的大规模数据集上学习,专门用于评估文档的结构和风格专业性,并在该任务上显著优于 GPT-5 等强大的基线模型。
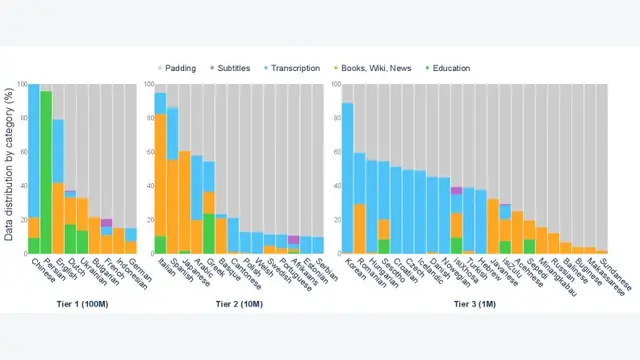
本文提出了 BabyBabelLM,一个包含45种语言、模拟人类语言习得环境的多语言基准,旨在推动语言模型在数据效率和认知合理性方面的跨语言研究。
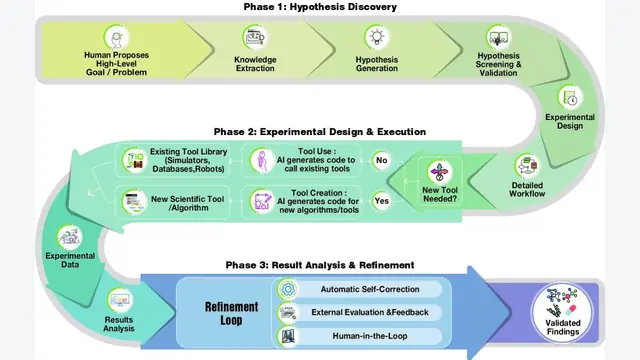
本文提出一个信息论框架来分析和构建用于科学发现的自主智能体(Autonomous Agents),通过对信息熵、可验证性和耗散的分析,建立了一套信息流转的分类体系,并在此基础上提出了一个衡量智能体自主能力的五级模型。
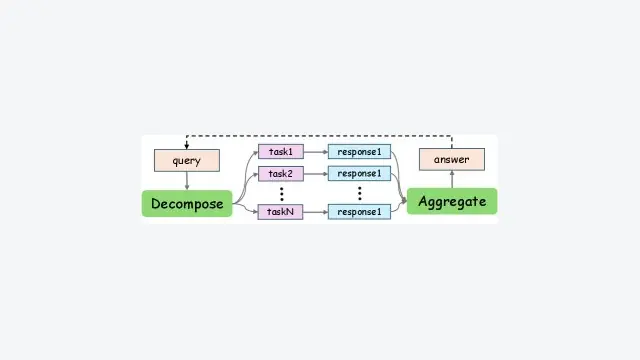
Parallel Reasoning综述系统梳理大模型的并行推理方法,区分独立生成、多路协作等测试时扩展路线。本文说明并行推理与串行思维链的差异,解读分类框架、代表方法、计算成本以及开放问题。
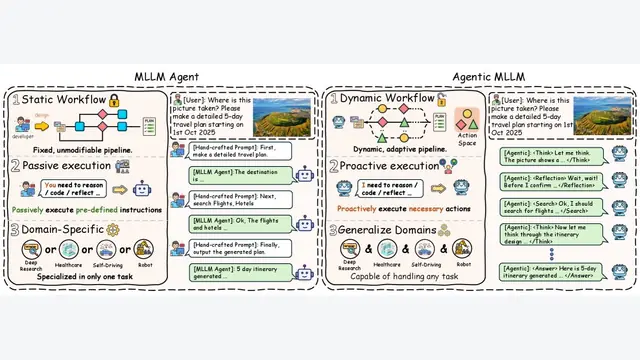
关于Agentic多模态大语言模型的综述。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
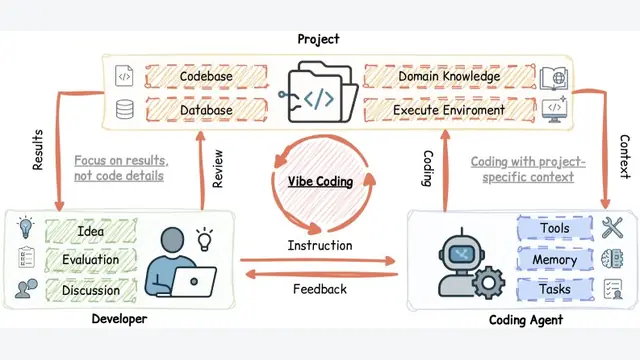
关于使用大型语言模型进行 Vibe Coding 的综述。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。