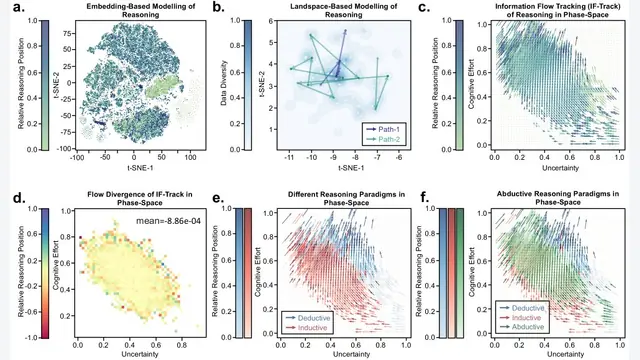
The Universal Landscape of Human Reasoning
本文提出了一种名为“信息流追踪”(Information Flow Tracking, IFT)的框架,该框架利用大语言模型(LLM)作为概率编码器,通过量化推理每一步的信息熵和信息增益,首次在统一的度量空间中对人类通...
推理
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文提出了一种名为“信息流追踪”(Information Flow Tracking, IFT)的框架,该框架利用大语言模型(LLM)作为概率编码器,通过量化推理每一步的信息熵和信息增益,首次在统一的度量空间中对人类通...
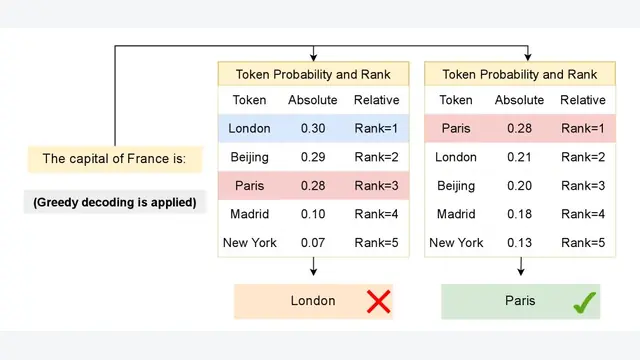
本文提出了一种基于相对排序的新指标——相对概率(RBP),并据此建立了相对标度律(Relative-Based Scaling Law),该定律揭示了模型将正确答案排在靠前位置的能力如何随模型规模的增大而遵循幂律提升,...
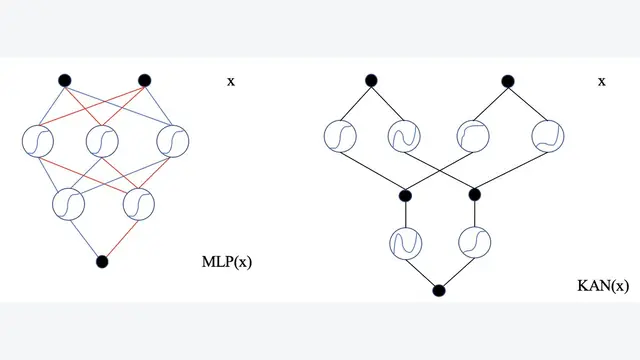
本文提出了一种名为 KCM (KAN-Based Collaboration Models) 的大-小模型协同框架,它利用一个基于 Kolmogorov-Arnold Network (KAN) 的小型判断模型,智能地...
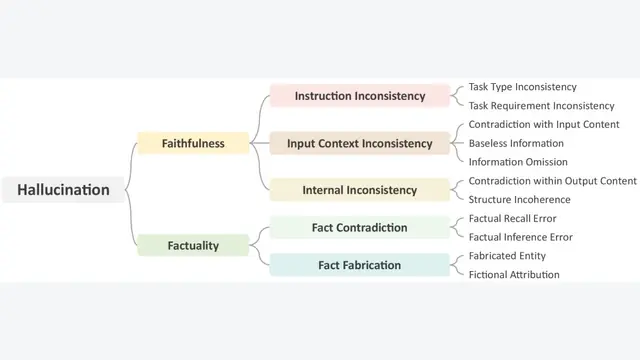
本文提出了一个全面的幻觉分类体系,并基于此构建了一个大规模合成数据集,用以训练 模型,使其能够在一个统一的推理过程中完成幻觉分类、范围识别和内容纠正。
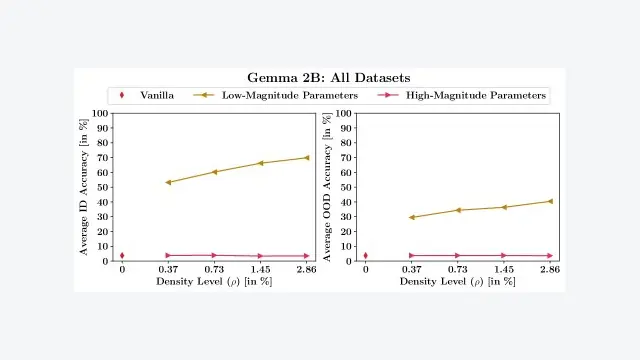
本文提出了一种名为 GaLLoP 的稀疏微调新方法,它通过优先选择在下游任务上梯度最大、且在预训练模型中权重绝对值最小的参数进行微调,从而在提升任务性能的同时有效保留预训练知识,实现了卓越的分布内(ID)和分布外(OO...
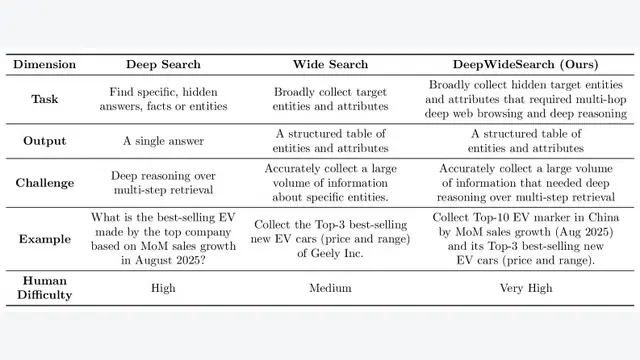
现有用于评估智能体的基准测试主要沿着两个维度发展:搜索宽度与搜索深度。本文系统梳理其研究背景、核心方法、关键实验结果、现有局限以及后续工程实践启示。
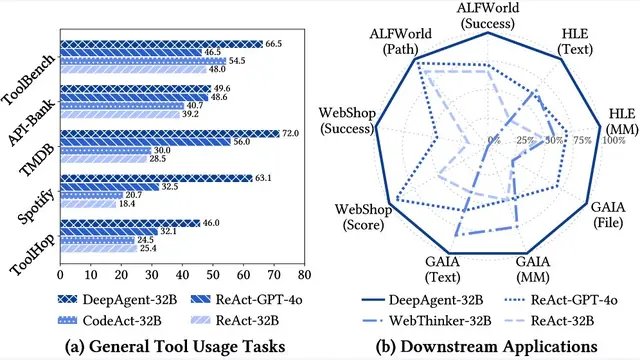
本文提出DeepAgent,一个通用的端到端深度推理智能体(Agent),它将思考、动态工具发现和动作执行统一在单个连贯的推理流中,并通过自主记忆折叠机制和专门的强化学习方法ToolPO,使其能够高效利用规模可变的工具...
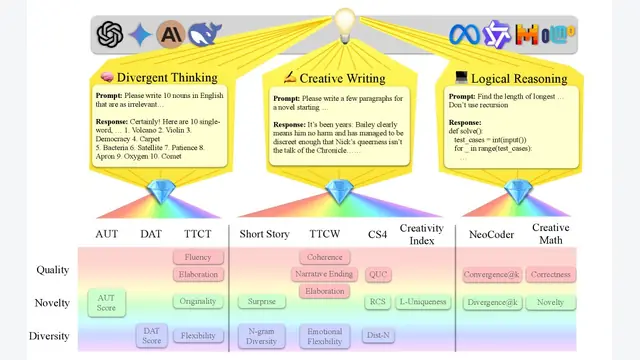
本文提出了一个名为 的整体性评估框架,通过跨越三个领域(发散性思维、创意写作、逻辑推理)的九个任务和二十个指标,从质量、新颖性和多样性三个维度系统地评估大型语言模型的创造力。
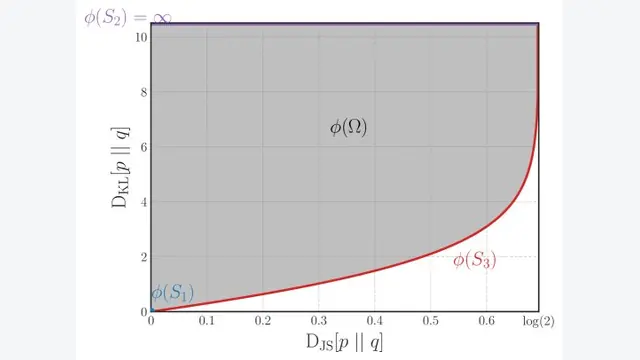
本文推导出了一个连接Kullback-Leibler散度(KLD)和Jensen-Shannon散度(JSD)的新的、紧致的下界,从而在理论上证明了最大化基于JSD的判别器目标函数等同于最大化互信息(MI)的一个可靠下...
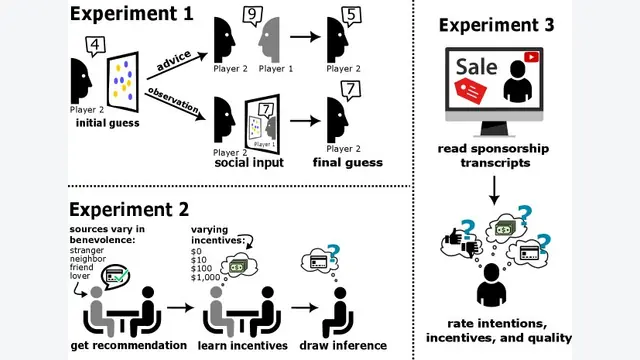
本文通过借鉴认知科学的理性模型,系统性地研究了大型语言模型(LLMs)是否能像人类一样识别和评估沟通背后的动机(即“动机警惕性”),发现它们在受控实验中表现出类似人类的能力,但在复杂的现实世界场景中表现不佳,不过简单的...
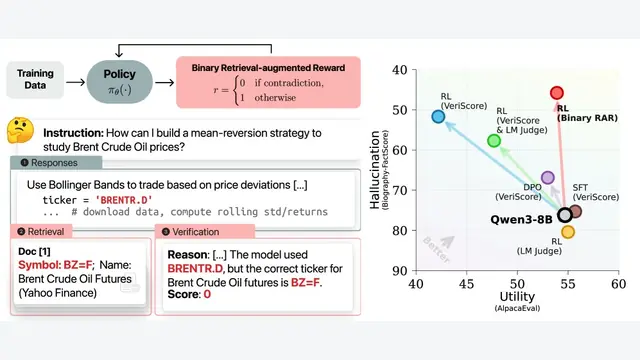
本文提出了一种名为“二元检索增强奖励 (Binary Retrieval-Augmented Reward, Binary RAR)”的在线强化学习方法,通过一个简单的二元(事实完全正确为1,否则为0)奖励信号,在不损...
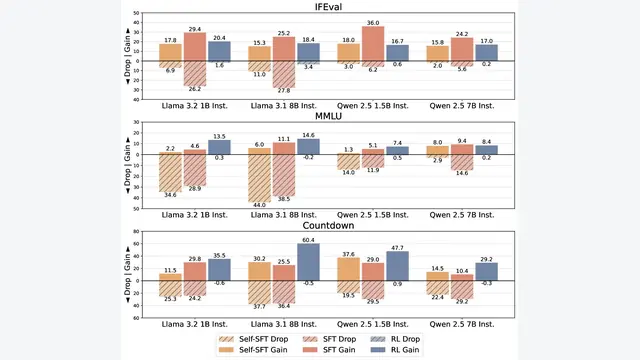
本文通过系统性比较发现,强化学习(RL)在后训练中比监督微调(SFT)更能有效缓解灾难性遗忘,其根本原因在于RL利用在线策略(on-policy)数据所产生的“模式寻求”(mode-seeking)特性,能够在学习新任...
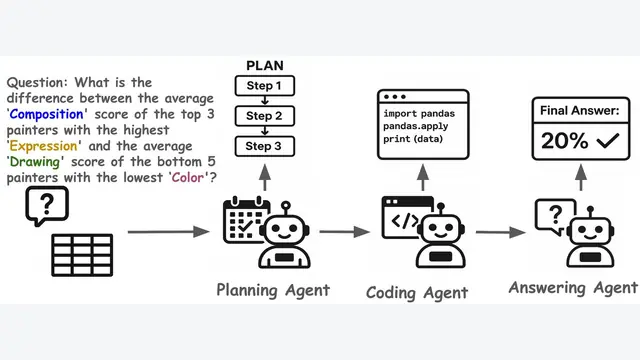
本文提出了一种名为 Mixture-of-Minds (MoM) 的多智能体框架,它将表格理解任务分解为规划、编码和回答三个专门的角色,并引入一个基于蒙特卡洛树搜索(MCTS)和强化学习(RL)的自提升训练框架,从而显...
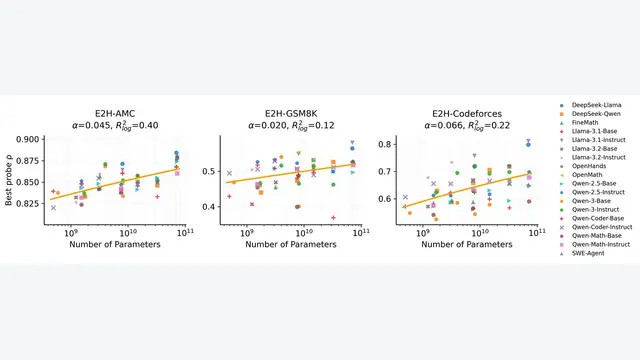
本文通过一系列实验发现,大型语言模型(LLMs)的内部激活向量中,确实以线性的方式编码了问题的难度,但这种编码与人类判断的对齐程度远高于与其它LLM性能评估的对齐程度;并且,在强化学习训练过程中,与人类判断一致的难度表...
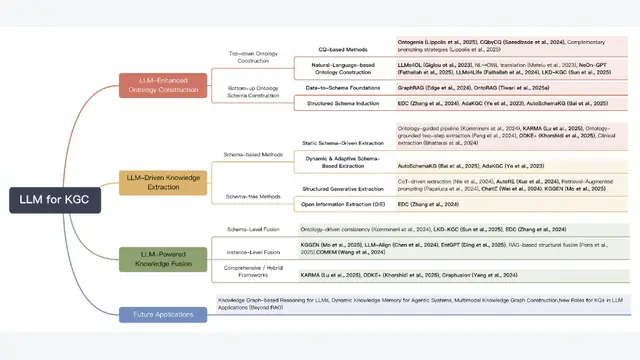
本文系统性地综述了大型语言模型(LLM)如何重塑知识图谱(KG)构建的全流程,通过分析本体工程、知识抽取和知识融合三个核心阶段的新兴范式,揭示了从传统方法向语言驱动、生成式框架的转变。
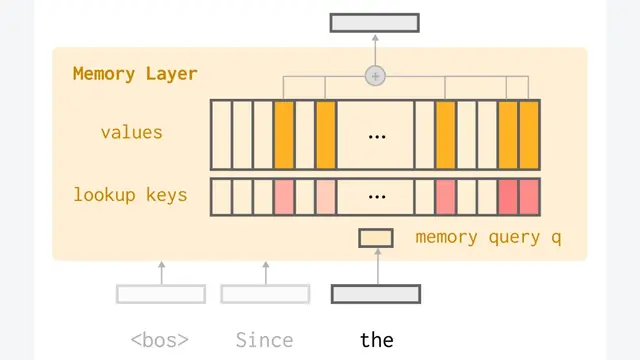
本文提出了一种名为稀疏内存微调(sparse memory finetuning)的方法,通过仅更新与新知识高度相关的、利用TF-IDF筛选出的极少数内存槽位,使大型语言模型在学习新知识的同时,显著减少了灾难性遗忘。
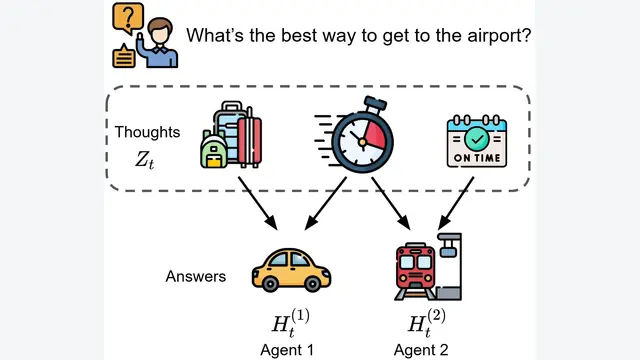
本文提出了一种名为 THOUGHTCOMM 的多智能体协作新范式,它使智能体能通过理论上可识别的、直接的潜在“思想”进行交流,而非传统的自然语言,从而突破语言瓶颈,提升集体智能的协作效率和上限。
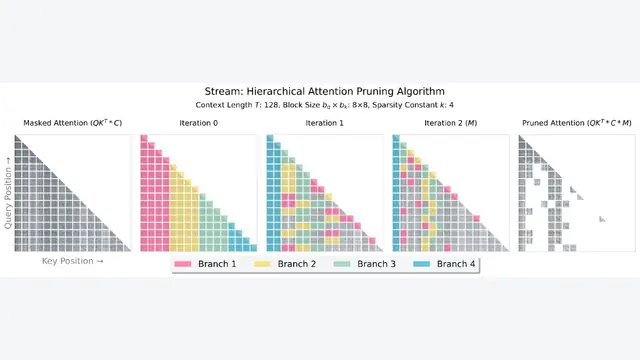
本文提出了一种名为 Stream 的可解释性框架,通过其具体实现算法 Stream-Attn,利用动态稀疏注意力机制,以近线性的时间( )和线性空间( )复杂度,高效分析大型语言模型在百万级Token长上下文中的注意力...
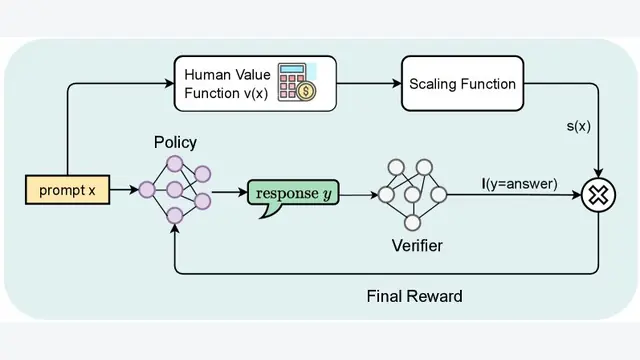
本文提出 RLEV 方法,通过将可验证的正确性奖励与人类定义的显式价值(如题目分数)相结合,直接优化语言模型,使其不仅追求正确性,更优先处理高价值任务,并学会根据任务重要性调整回答的详略程度。
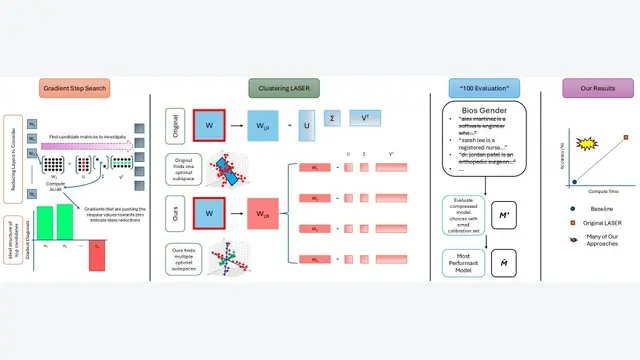
本文提出了一种名为"Compress to Impress"的高效LLM自适应方法,仅需在100个样本上进行单次梯度计算,并结合多子空间矩阵分解,即可在无需任何微调的情况下,快速提升模型在下游任务上的性能。
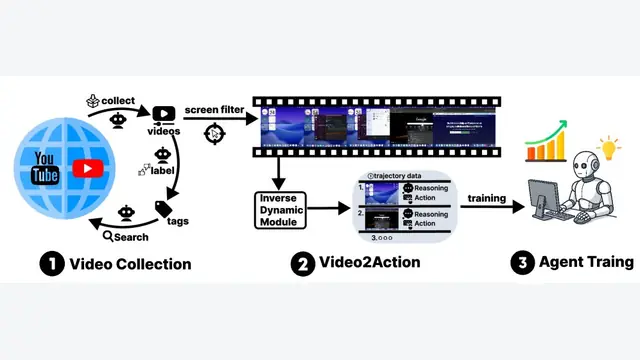
本文提出了一种名为 VideoAgentTrek 的可扩展方法,通过一个逆动力学模块(VADM)从未经标注的公开屏幕录制视频中自动挖掘出结构化的训练数据,从而解决了训练计算机使用智能体(Agent)时对大规模手动标注数...
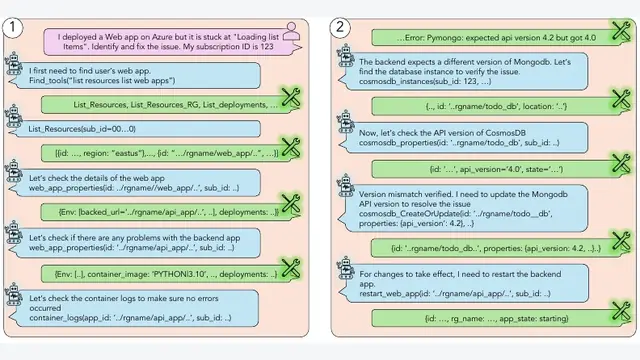
本文提出了一个名为 TheMCPCompany 的大规模工具调用基准(包含超18000个工具),并通过实验证明,利用专门的工具集比通用浏览器能带来更好的性能和更低的成本,但从海量工具中检索并组合正确工具以解决复杂问题仍...
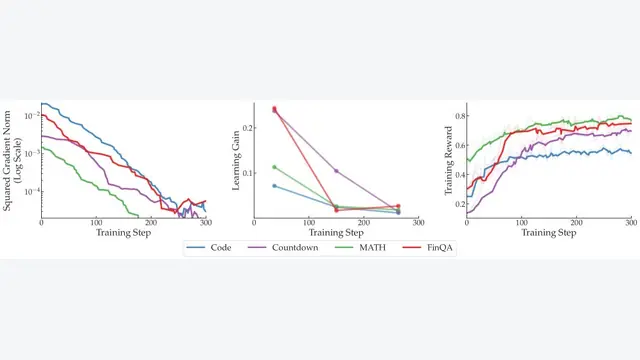
本文通过实验证明,在大型语言模型 (LLM) 的多任务强化学习 (RL) 后训练中,不同任务会产生幅度差异悬殊的梯度,并且大梯度并不意味着大的学习增益,这种梯度不平衡现象会导致优化过程偏向特定任务,从而损害整体性能。
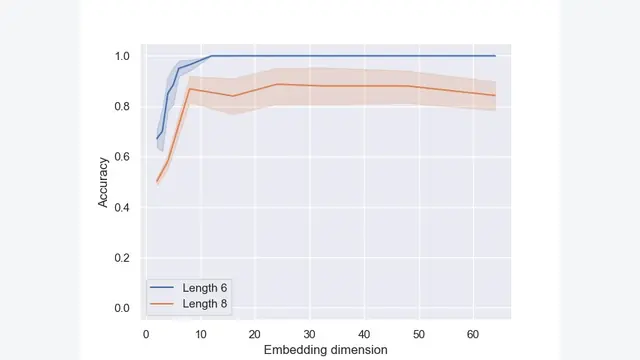
本文通过强化学习训练Transformer执行排序任务,发现更高的嵌入维度能促使智能体形成更可靠、更具可解释性的内部世界模型,即便任务准确率早已饱和。