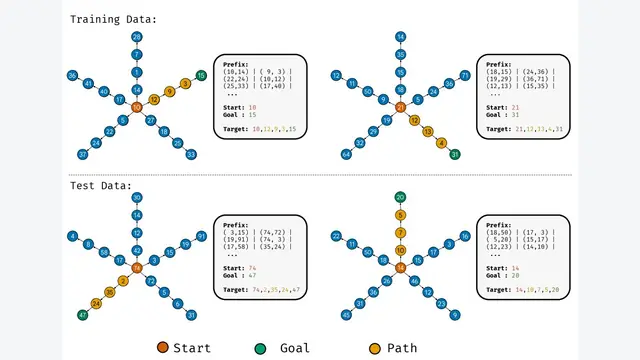
Deep sequence models tend to memorize geometrically; it is unclear why
本文通过一个精心设计的实验揭示,深度序列模型在记忆事实时并非简单地存储局部关联,而是会自发形成一种“几何式记忆”结构,这种结构编码了实体间(包括训练中未共现的实体)的全局关系,从而将复杂的多步推理任务简化为易于学习的单...
基础模型
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
本文通过一个精心设计的实验揭示,深度序列模型在记忆事实时并非简单地存储局部关联,而是会自发形成一种“几何式记忆”结构,这种结构编码了实体间(包括训练中未共现的实体)的全局关系,从而将复杂的多步推理任务简化为易于学习的单...
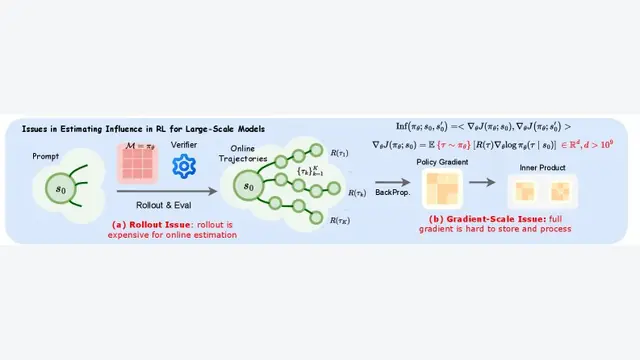
本文提出了一种名为CROPI的数据高效强化学习框架,通过一种新颖的离策略影响函数估计方法,以极低的计算成本识别并挑选对模型训练最有价值的数据,从而在大型语言模型的推理能力训练中实现显著的加速。
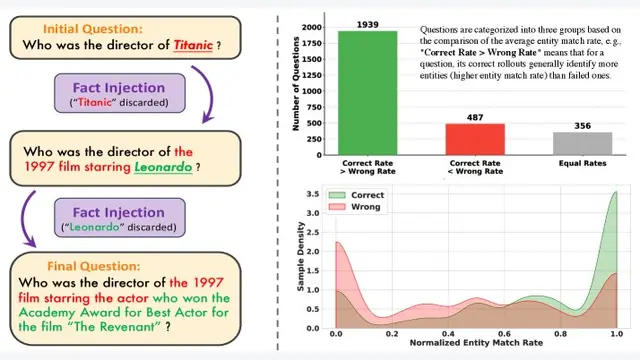
本文提出了一种名为 E-GRPO 的新方法,通过重利用合成数据生成过程中被忽略的实体信息,构建了一个细粒度的实体感知奖励函数,以解决传统强化学习方法中的奖励稀疏和“功亏一篑”(near-miss)问题,从而更有效地训练...
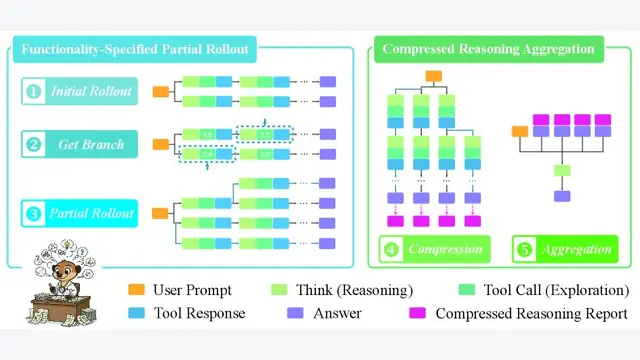
本文提出了一种名为 ParallelMuse 的两阶段智能体并行思维框架,通过“功能指定的局部展开”策略和“压缩推理聚合”方法,在提升深度信息寻求 (deep information-seeking) 任务效果的同时,...
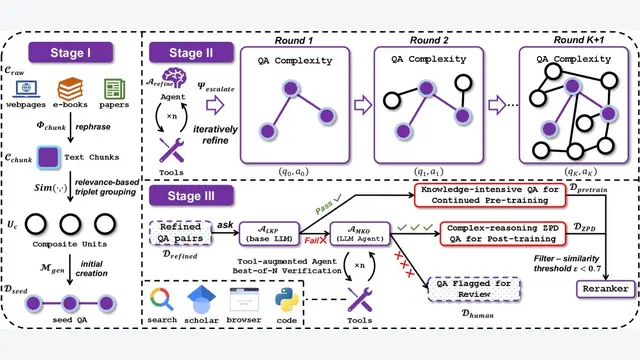
本文提出了 AgentFrontier,一个基于教育心理学“最近发展区”(ZPD)理论的数据合成框架,通过自动生成位于大语言模型(LLM)能力边界上的复杂推理数据,从而系统性地提升智能体(Agent)的跨领域、综合推理能力。
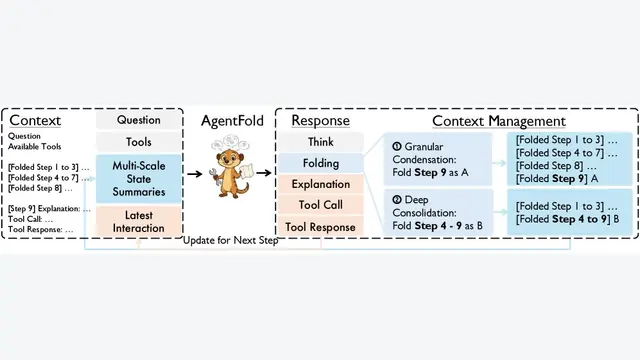
本文提出了一种名为 AgentFold 的新型网页智能体,它通过模仿人类主动管理心智暂存区的方式,在执行长时程任务时对上下文进行主动“折叠”和整合,从而在保持上下文简洁性的同时避免关键信息丢失,并以较小的模型规模实现了...
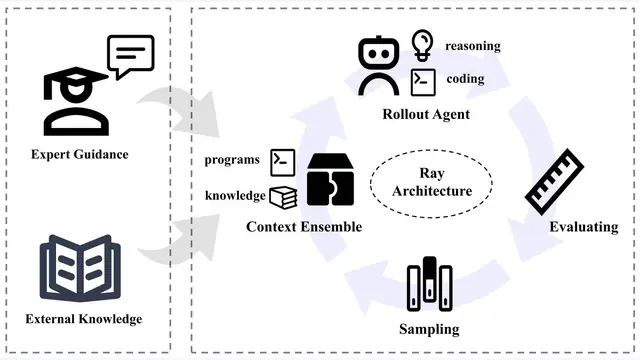
本文提出一个名为FM Agent的通用多智能体框架,该框架创新性地结合了大型语言模型(LLM)的推理能力和大规模进化搜索,以自动化方式在运筹优化、机器学习、GPU内核优化和数学问题等多个领域解决复杂的现实世界挑战,并取...
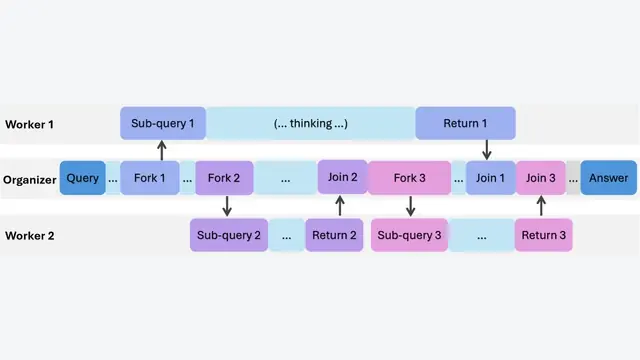
本文提出了一种名为 AsyncThink 的新推理范式,它允许大型语言模型通过一种“组织者-工作者”协议,将复杂的思考过程分解为可并发执行的子任务,并通过强化学习自主学会如何优化这种异步协同结构,从而在降低推理延迟的同...
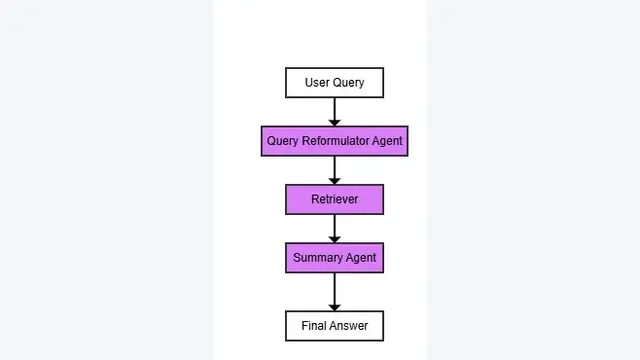
本文提出了一种专为金融科技(Fintech)领域设计的智能体化检索增强生成(Agentic Retrieval-Augmented Generation, A-RAG)架构,通过一个由专业智能体组成的模块化、迭代式流水...
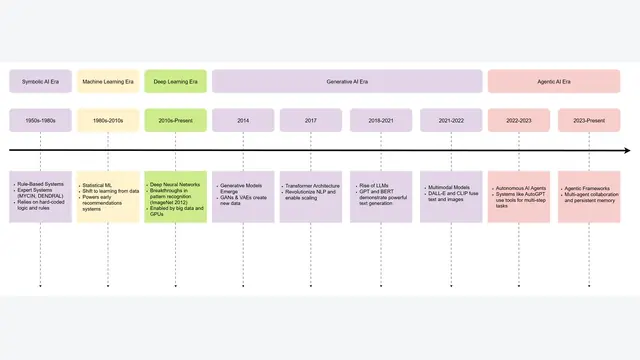
Agentic AI综述从符号/经典与神经/生成两条技术谱系梳理智能体架构,解释规划、决策及工具交互的不同实现方式。本文解读其分类框架、典型应用和未来方向,帮助区分不同类型智能体的能力来源与适用边界。
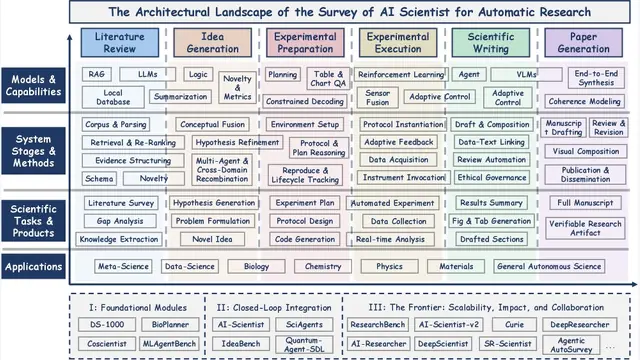
本文首次对新兴的 AI 科学家 (AI Scientist) 领域进行了系统性综述,提出了一个统一的六阶段科学工作流框架,并基于此框架梳理了从 2022 年到 2025 年的关键研究,揭示了该领域从基础模块化、闭环集成...
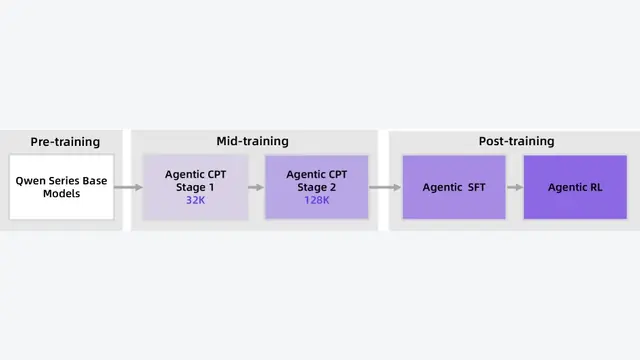
本文介绍了通义深搜(Tongyi DeepResearch),一个开源的AI研究智能体,它通过创新的“智能体中训练”与“智能体后训练”两阶段训练框架,结合可扩展的合成数据引擎,实现了领先的深度研究能力。
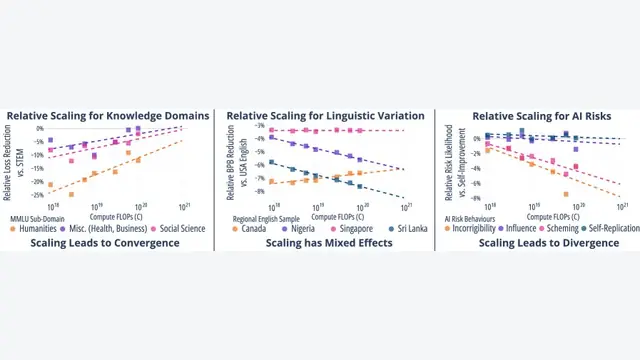
本文提出了一种名为“相对缩放定律 (Relative Scaling Laws)”的新框架,用于量化随着计算规模的增加,不同数据分布上的性能差距如何演变,揭示了规模增长并非普适的均衡器,其影响因领域而异。
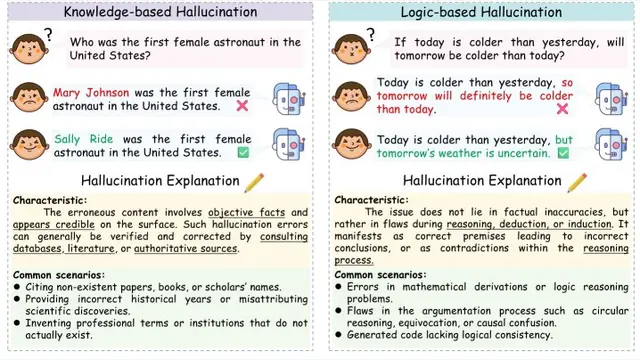
本文是一篇以应用为导向的综述,系统性地分析了检索增强生成(RAG)、推理增强以及智能体(Agentic Systems)系统如何通过提升模型能力来缓解大型语言模型(LLM)中的知识型和逻辑型幻觉。
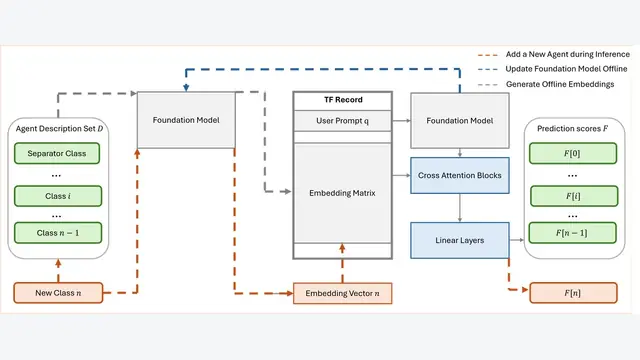
本文提出了一种名为“智能体元编排器” (Agentic Meta-Orchestrator, AMO) 的新架构,用于构建可扩展的多任务Copilot服务,该架构通过学习排序模型进行智能体路由,利用LoRA臂实现高效多...
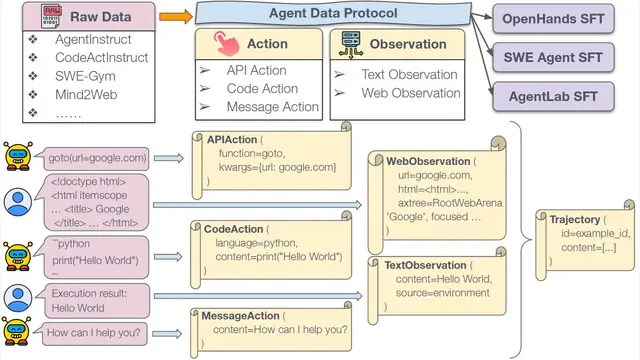
本文提出了一种名为智能体数据协议 (Agent Data Protocol, ADP) 的轻量级表示语言,它通过将来自不同来源、格式各异的智能体训练数据统一为标准模式,解决了数据碎片化问题,从而实现了对大型语言模型智能...
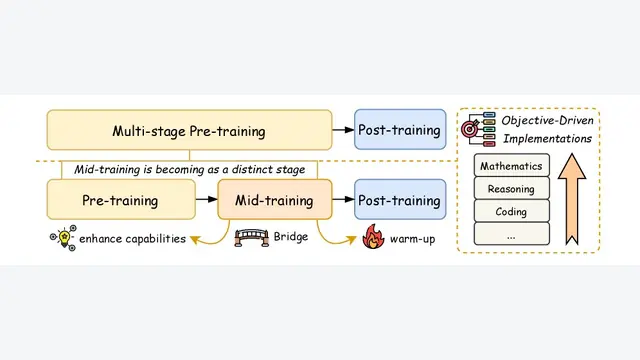
当代大型语言模型 (LLM) 的开发已从单一的预训练模式演变为复杂的多阶段优化框架。预训练通过接触大规模多样化语料库为模型奠定基础能力,而后续的优化阶段则系统性地增强特定能力。中间训练 (mid-training) 作...
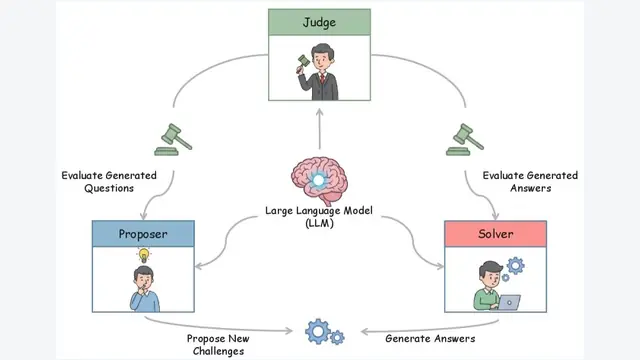
本文提出了一种名为“多智能体进化 (Multi-Agent Evolve, MAE)”的框架,通过让单个大语言模型扮演提问者 (Proposer)、解答者 (Solver) 和裁判 (Judge) 三个协同进化的角色,...
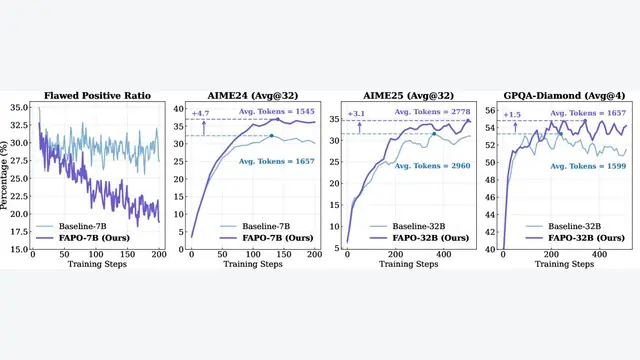
本文提出了一种名为缺陷感知策略优化 (FAPO) 的方法,通过训练一个生成式奖励模型(GenRM)来识别并惩罚那些最终答案正确但推理过程有误的“缺陷正样本”,从而在不增加Token预算的情况下,提升大型语言模型在强化学...
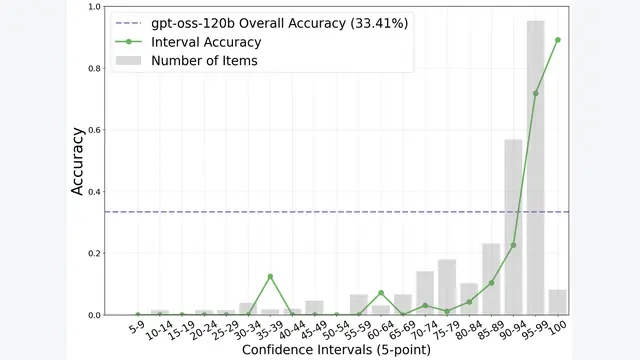
本文提出了一种名为 BrowseConf 的测试时扩展 (Test-Time Scaling, TTS) 方法,它通过利用大语言模型智能体对其回答的“口头表述置信度” (Verbalized Confidence),来...
本文通过将智能体(Agent)的内存架构与乔姆斯基层级(Chomsky hierarchy)中的抽象机进行类比,建立了一套形式化等价框架,指出智能体的计算能力和可验证性由其内存类型(无内存、堆栈、无限读写内存)决定,从...
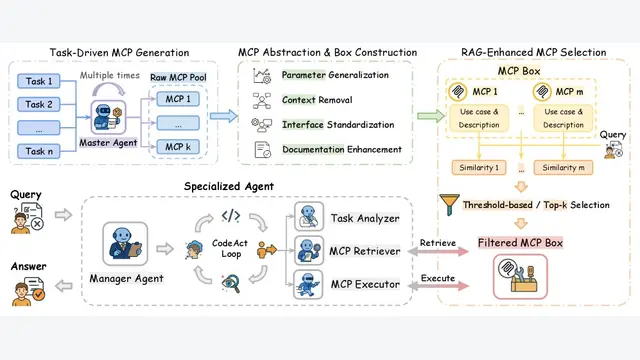
本文提出了Alita-G,一个自进化生成智能体框架,它通过系统性地生成、抽象和管理一系列称为模型上下文协议(Model Context Protocol, MCP)的工具,将一个通用智能体转化为特定领域的专家,从而在提...
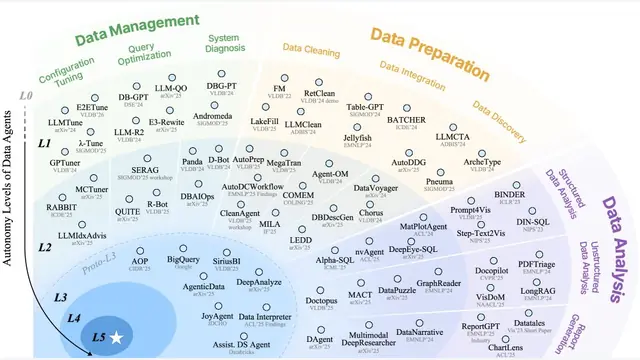
随着大型语言模型 (Large Language Models, LLMs) 的兴起,一种新的范式——数据智能体 (Data Agents)——应运而生。数据智能体被定义为一个综合性的、由LLM驱动的架构,它能自主协调...
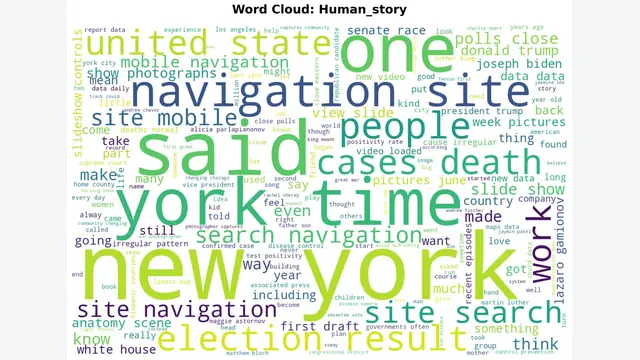
本文发布了一个包含超过58000条文本的大型数据集,其中包含真实的《纽约时报》文章以及由六种先进大语言模型(LLMs)生成的对应版本,并为区分人类与AI文本以及AI文本模型溯源这两个任务提供了基准性能。