AhaBench:给大模型灌经验真有用?普林斯顿等拆解长程持续学习三大硬伤
AhaBench: Do Agents Learn from Prior Experience? A Benchmark for Long-Horizon Continual Learning
当我们在谈论 AI Agent 的时候,默认假设它具备一种类似人类的“悟性”:在多轮排错中遇到报错,下一次应该避开;看懂了一道复杂数学题的解法,换个数字应该能举一反三;经营业务遭遇几次供应商断货,后续决策就该懂得预留库存。
ArXiv URL:https://arxiv.org/abs/2609.05435
然而,现存的绝大多数 Agent 评测都在掩盖真相。静态基准测试如 MMLU 测的是模型预训练存了多少知识;哪怕是看似动态的单轨迹(Single-trajectory)Agent 评测,通常也只是在 Prompt 结束后重置上下文,或者单看这一轮最终的状态有没有达成目标。这就留下了一个巨大的盲区:一个参数固定不动的模型,在交互过程中积累了经验之后,它的底层决策策略究竟有没有发生持续的、可迁移的进化?
为了回答这个问题,来自香港大学、普林斯顿大学、上海交通大学、腾讯和清华大学的研究团队联合推出了基准框架 AhaBench。这项研究的核心目标不是测模型开局有多强,而是定量考察模型在获得经验后,当显式的支持被撤掉、被改变或反馈被延迟时,它的后续表现到底有没有真正提升——也就是所谓的“Aha moment”(恍然大悟的顿悟时刻)。
从“开卷抄答案”到“撤掉拐杖”:AhaBench 的三维记分卡
AhaBench 的设定极为严格:模型参数完全固定,禁止任何微调或梯度更新。模型要想变强,完全依赖于上下文(Context)、内部推理、环境交互状态或工具反馈。
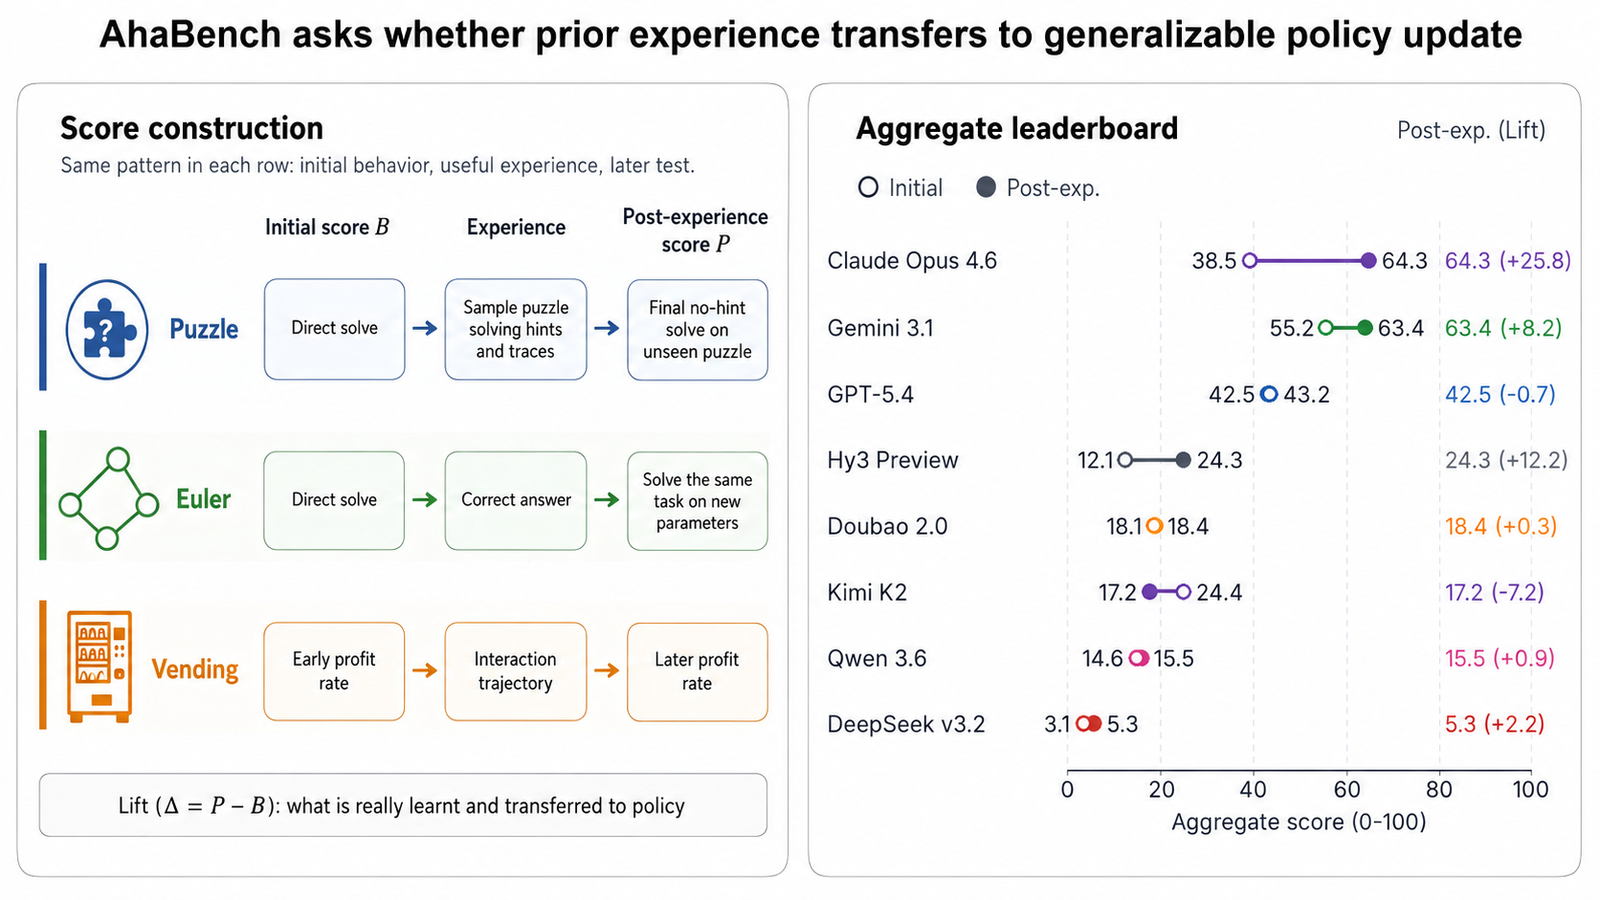
研究团队设计了一个三联记分卡机制:
-
初始得分(Initial Score, $B$):模型在没有经验时的“冷启动”能力。
-
经验后得分(Post-Experience Score, $P$):经历过相关教学、过往解题轨迹或经营历史后,在去除了显式提示或改变了测试条件的新环境中的表现。
-
学习增益(Learning Lift, $\Delta = P - B$):二者的差值,用来衡量经验究竟让模型进步了多少。
这套体系由三个互为补充、各有侧重的子任务构成:
-
Aha-Puzzle(海龟汤情境解谜):测试不完全信息下的隐状态探索。智能体需要通过最多 20 轮“是/否”问答探寻故事真相。模型在经历了一系列带逐步缩短提示前缀的人类示范轨迹并完成自我反思后,必须面对没有任何线索前缀(No-hint)的最终挑战。
-
Aha-Euler(数学逻辑泛化):灵感来自 Project Euler,通过代码生成具有严格依赖图的计算任务。先在 $Q_{\text{teach}}$(教学任务)给模型经验,再在 $Q_{\text{test}}$(测试任务)上检验。这里分两种:全量教学(Full Teaching,提供答案+思路+代码)与部分教学(Partial Teaching,仅提供题目和最终答案数字,逼迫模型自行逆向重构计算过程)。
-
Aha-Vending(自动售货机长期运营):基于 Vending-Bench 构建的高仿真经营模拟器。智能体需要连续经营数百个模拟日,不仅要订货、定价、算账,还要应对供应商拖延、网络钓鱼、机器故障、恶劣天气等突发事件。反馈极其迟滞,一次错误的定价可能在数周后才导致资金链断裂。
实验在涵盖主流前沿模型的 8 模型面板上展开。总榜显示,Claude Opus 4.6 以 64.3 的经验后得分($P$)和 $+25.8$ 的总增益拔得头筹,Gemini 3.1 Pro 以 63.4 紧随其后。但深入到各子项,一幅充满分歧的画卷被彻底展开:“看得懂提示”的模型、“底子本身就强”的模型、以及“能从经验中汲取养分”的模型,根本就不是同一批。
Aha-Puzzle:把前缀线索拿掉,模型就打回原形
在 Aha-Puzzle 中,模型面临的是典型的横向思维谜题(如经典的海龟汤谜题)。如果单看“带有示范轨迹(Trace-supported)”的过程分,几乎所有前沿大模型都显得极为聪明,分数普遍拉得非常高。
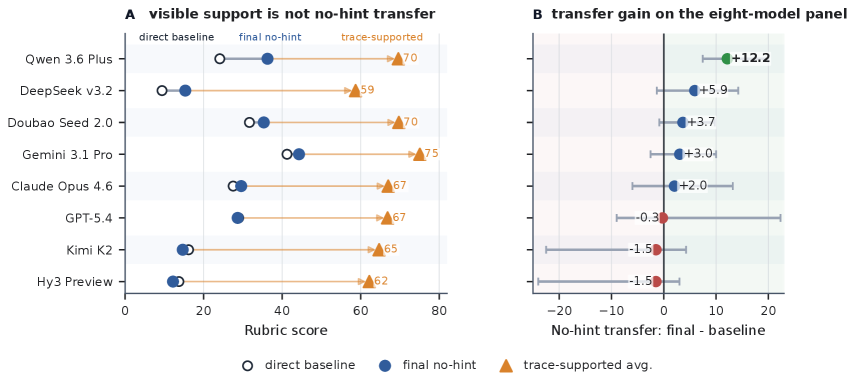
然而残酷的现实在最终的无提示(No-hint)迁移关卡暴露无遗。只要把人类高手的引导轨迹撤掉,模型的得分立刻发生雪崩。GPT-5.4、Claude、Gemini 等头部模型虽然在有辅助时展现出极高的理解力,但这种“辅助下的高分”并没有自然转化为自身主动探索策略的跃迁。在这个维度上,Qwen 展现出了最清晰的正向迁移增益(Lift),而其他许多模型在失去线索后,问答策略又退化成了漫无目的的随机尝试。
这说明当前大模型普遍存在一种“假性领悟”:它们极其擅长在上下文中利用现成的推理线索顺藤摸瓜,却很难把线索中蕴含的高阶提问策略(例如排查身份倒置、定位时间差、圈定歧义实体)沉淀为自己的方法论。
Aha-Euler:全量代码掩盖了真正的认知硬伤
如果说推理谜题偏向主观探索,Aha-Euler 则展示了算法逻辑上的认知断层。
在单步任务中,当研究人员给模型提供完整的 $Q_{\text{teach}}$ 代码、推导和答案时(Full Teaching),模型的正确率几乎呈现统治级表现,绝大多数模型都能轻松达到 78.6% 至 100.0%。从表面上看,模型似乎彻底掌握了这道题的算法内核。
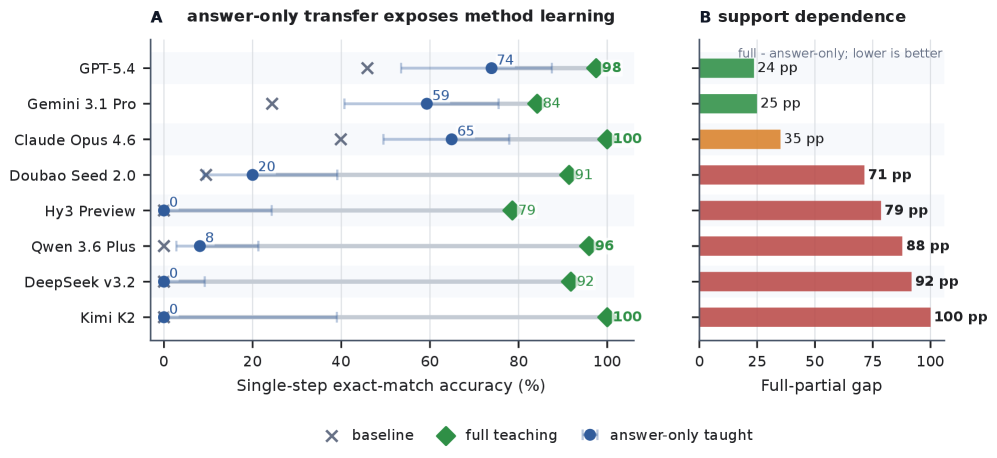
然而消融实验打碎了这一假象。当切换到部分教学模式(Partial Teaching)——即只给题目和最终输出的标量答案,不给任何推导过程和代码,要求模型“观察输入与输出并自行逆向重构算法”,再迁移到 $Q_{\text{test}}$ 时,模型梯队瞬间分化:
GPT-5.4、Claude Opus 4.6 和 Gemini 依然能够保持较为出色的逆向推导与迁移能力,在只有答案的情况下成功重构出递推公式或筛选逻辑;但与此同时,其他模型的准确率直接断崖式跌落至甚至接近 0.0%。
这种“全量教学与部分教学的巨大鸿沟(Full-Partial Gap)”精准击中了当前 Agent 代码生成的痛点:在长上下文里照猫画虎地提取并修改一段现成代码,与在没有脚手架的情况下独立重构计算逻辑,完全是两种不同维度的认知能力。过往大量的代码基准测试,因为混杂了过多上下文模板,实际上掩盖了模型无法自主抽象核心算法这一硬伤。
Aha-Vending:经营模拟中的破产危机与迟滞惩罚
真实世界不仅有确定性的数学逻辑,更有伴随时间累积的延迟负反馈。在 Aha-Vending 的 365 天突发事件压力测试中,模型的商业敏锐度被置于严酷的生存考验之下。
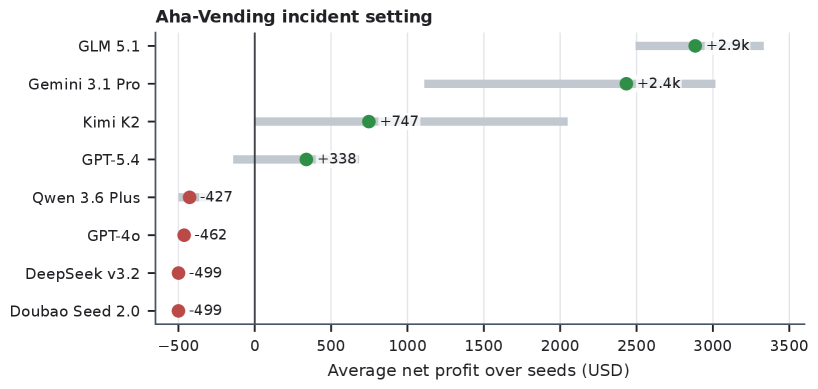
在这个长周期环境里,短期理性的行为往往会引发长期灾难。例如,面对突发事件导致的利润下滑,一些模型(如 Kimi)在后期表现出极度消极的保守策略,利润变化率(Profit/Day Slope)直接跌成负数;而 Doubao 和 DeepSeek 等模型则在面对供应商延迟交付、机器故障和恶意钓鱼邮件的连锁冲击下,未能根据历史亏损及时动态调整定价与库存,最终直接触及破产红线。
在全生命周期的考验下,仅有 Claude Opus 4.6 和 Gemini 3.1 Pro 展现出极高韧性,在所有随机种子的测试中均保持全流程正向盈利,展现出理解“过往决策如何反噬未来现金流”的长程规划直觉。
经验不等于进化,长程 Agent 需要重新被度量
AhaBench 的交叉分析(Cross-Benchmark Analysis)给出了一个值得整个技术社区深思的统计学事实:不同任务维度的能力相关性极低,甚至出现负相关。在 Euler 数学迁移上拔得头筹的模型,未必在海龟汤的隐状态探索中懂得怎么提问;在售货机经营中赚钱的模型,也不一定具备单凭答案逆向破解算法的推演力。
这项研究为长程 Agent 的研发敲响了警钟:
我们不能再把“给模型喂更长的 Context、更多的 Few-Shot”简单等同于“模型变聪明了”。在实际部署中,模型面对的现实场景永远是动态变化的,曾经的提示终将撤去,未来的风险往往带着延迟的惩罚。
AhaBench 证明了一条更清醒的评估路线:唯有将“开卷有益时的表现”与“撤掉拐杖后的蜕变”拆开来量化,我们才能真正看清眼前这个 Agent,究竟是在机械地照抄上下文,还是真的经历了一场由内而外的顿悟。