Agentic Real2Sim:开箱即用的物理数字孪生与低成本模型验证
Agentic Real2Sim: Physics-based World Modeling with Vision-Language Agents
在具身智能(Embodied AI)的发展路径中,从真实世界走向物理仿真(Real-to-Sim)一直是极其关键却又高度受限的瓶颈环节。海量的真实机器人操作视频固然珍贵,但要把一段随手拍摄或遥操作采集的视频转化为物理引擎中“真正可运行、可复现、可交互”的数字孪生场景,过去往往依赖繁琐的人工介入:手动修剪三维网格(Mesh)、对齐坐标系、在各个孤立的视觉感知工具与仿真器接口之间写满脆弱的粘合脚本。
ArXiv URL:https://arxiv.org/abs/2607.19190v1
来自哥伦比亚大学、约翰斯·霍普金斯大学、加利福尼亚大学洛杉矶分校(UCLA)等多所高校与机构的研究团队,针对这一长期困扰业界的工程痛点,提出了 Agentic Real2Sim 框架。这项工作跳出了“仅做静态视觉三维重建”的传统思维,首次将整段真实物理交互过程视为统一的转换单元,利用视觉语言智能体(VLM Agent)驱动全流程的物理参数推断与仿真闭环优化。更令人瞩目的是,借助对智能体职责的精准边界约束,一个开源的 31B 规模 VLM 即可达成匹敌顶尖闭源前沿模型的转换成功率,并将模型调用成本直接削减到后者的约 3%(降低达 31.4 倍)。
从静态重建到动态数字孪生:Real2Sim 的范式转变
以往的 Real2Sim 工作通常聚焦于孤立环节。例如,一些方案侧重于使用专门的扫描台来重建高质量物体的网格与惯性参数,另一些方案则专注于构建逼真的光照和渲染效果(NeRF 或 3DGS 路线)。然而,机器人策略学习对仿真的核心需求从来不只是“看起来像”,而是必须满足物理动力学交互的可执行性——机械臂在仿真中下探时,夹爪能否以真实摩擦力抓起物体?物体受力后的位移、形变与碰撞响应是否合乎物理规律?
为了满足下游强化学习与策略评测的要求,论文将转换目标形式化定义为“Episode Twin”(情节数字孪生):
\[\mathcal{T} = (\mathcal{O}, \mathcal{A}, \mathcal{G}, \mathcal{S}_{1:T}, \Theta, \mathcal{B}, \mathcal{M})\]其中,$\mathcal{O}$ 代表真实世界的多视角观测,$\mathcal{A}$ 为智能体执行器或末端夹爪状态,$\mathcal{G}$ 是几何与外观资产,$\mathcal{S}_{1:T}$ 记录连续的时序仿真状态,$\Theta$ 包含刚体材质、摩擦系数、质量等物理动力学参数,$\mathcal{B}$ 为底层仿真后端(如 MuJoCo),而 $\mathcal{M}$ 则作为闭环校验和成功率判定指标。
只有当这些要素全部在统一契约下得到恢复,一段录像才算真正转化为了下游算法可探索、可复现交互的物理世界模型资产。
四阶段协同:解耦决策与专用感知工具
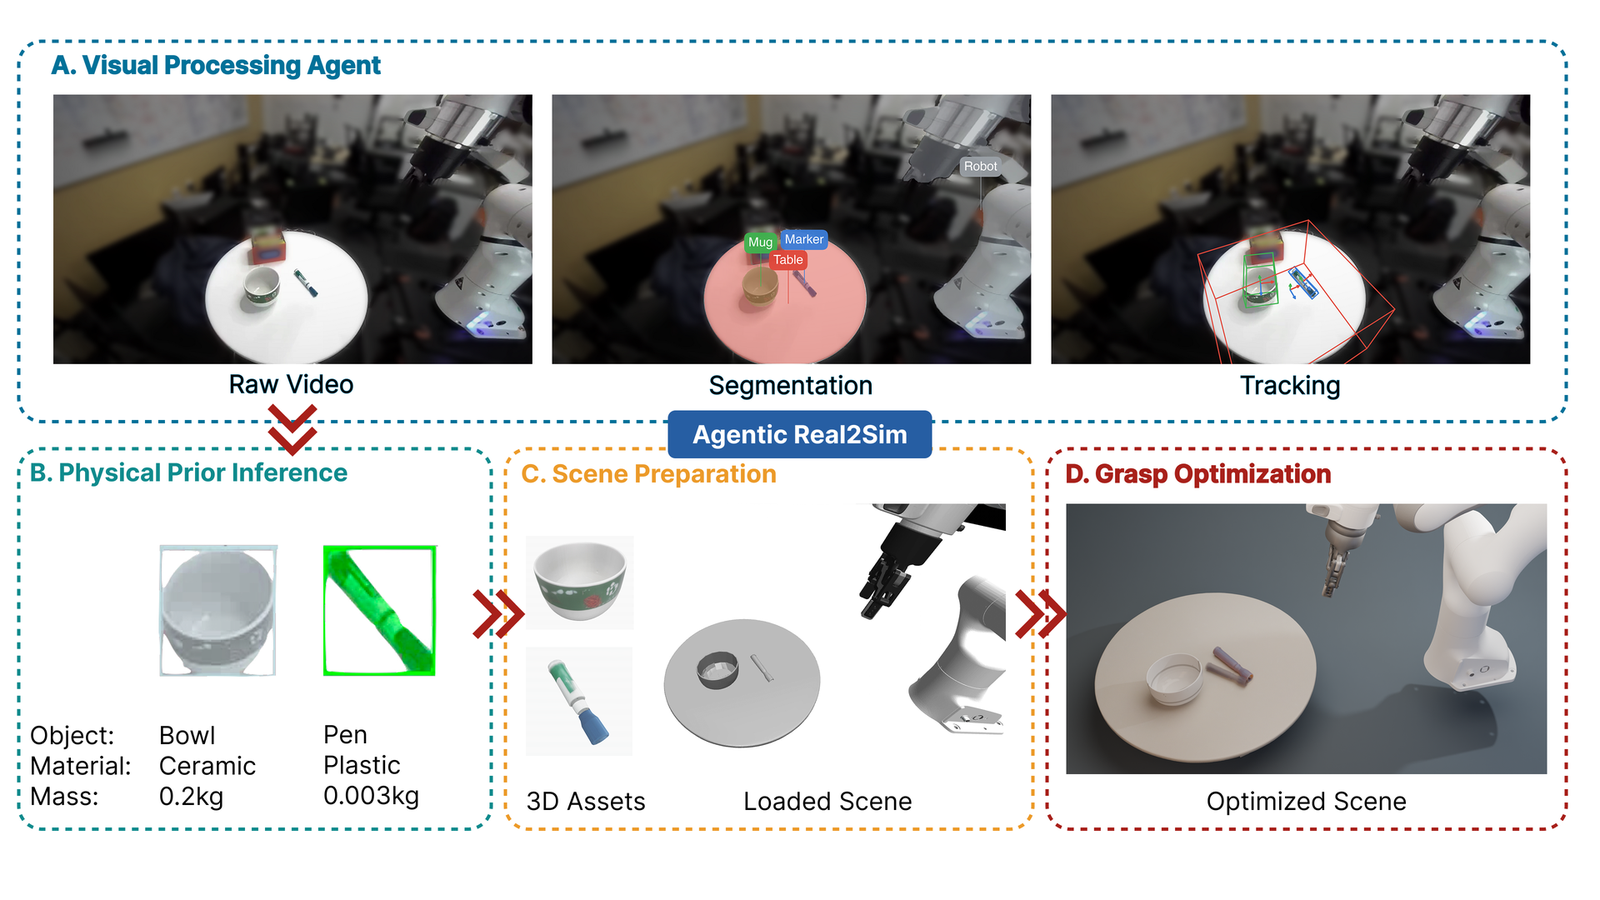
Agentic Real2Sim 的核心设计思想,在于严格切分“智能体的高层语义决策”与“底层确定性的专业感知工具”。VLM 不直接参与密集的低层几何运算或物理积分,而是扮演调度者和质量评判者(Critic)的角色。
整个转换流由四个高度联动的阶段构成:
-
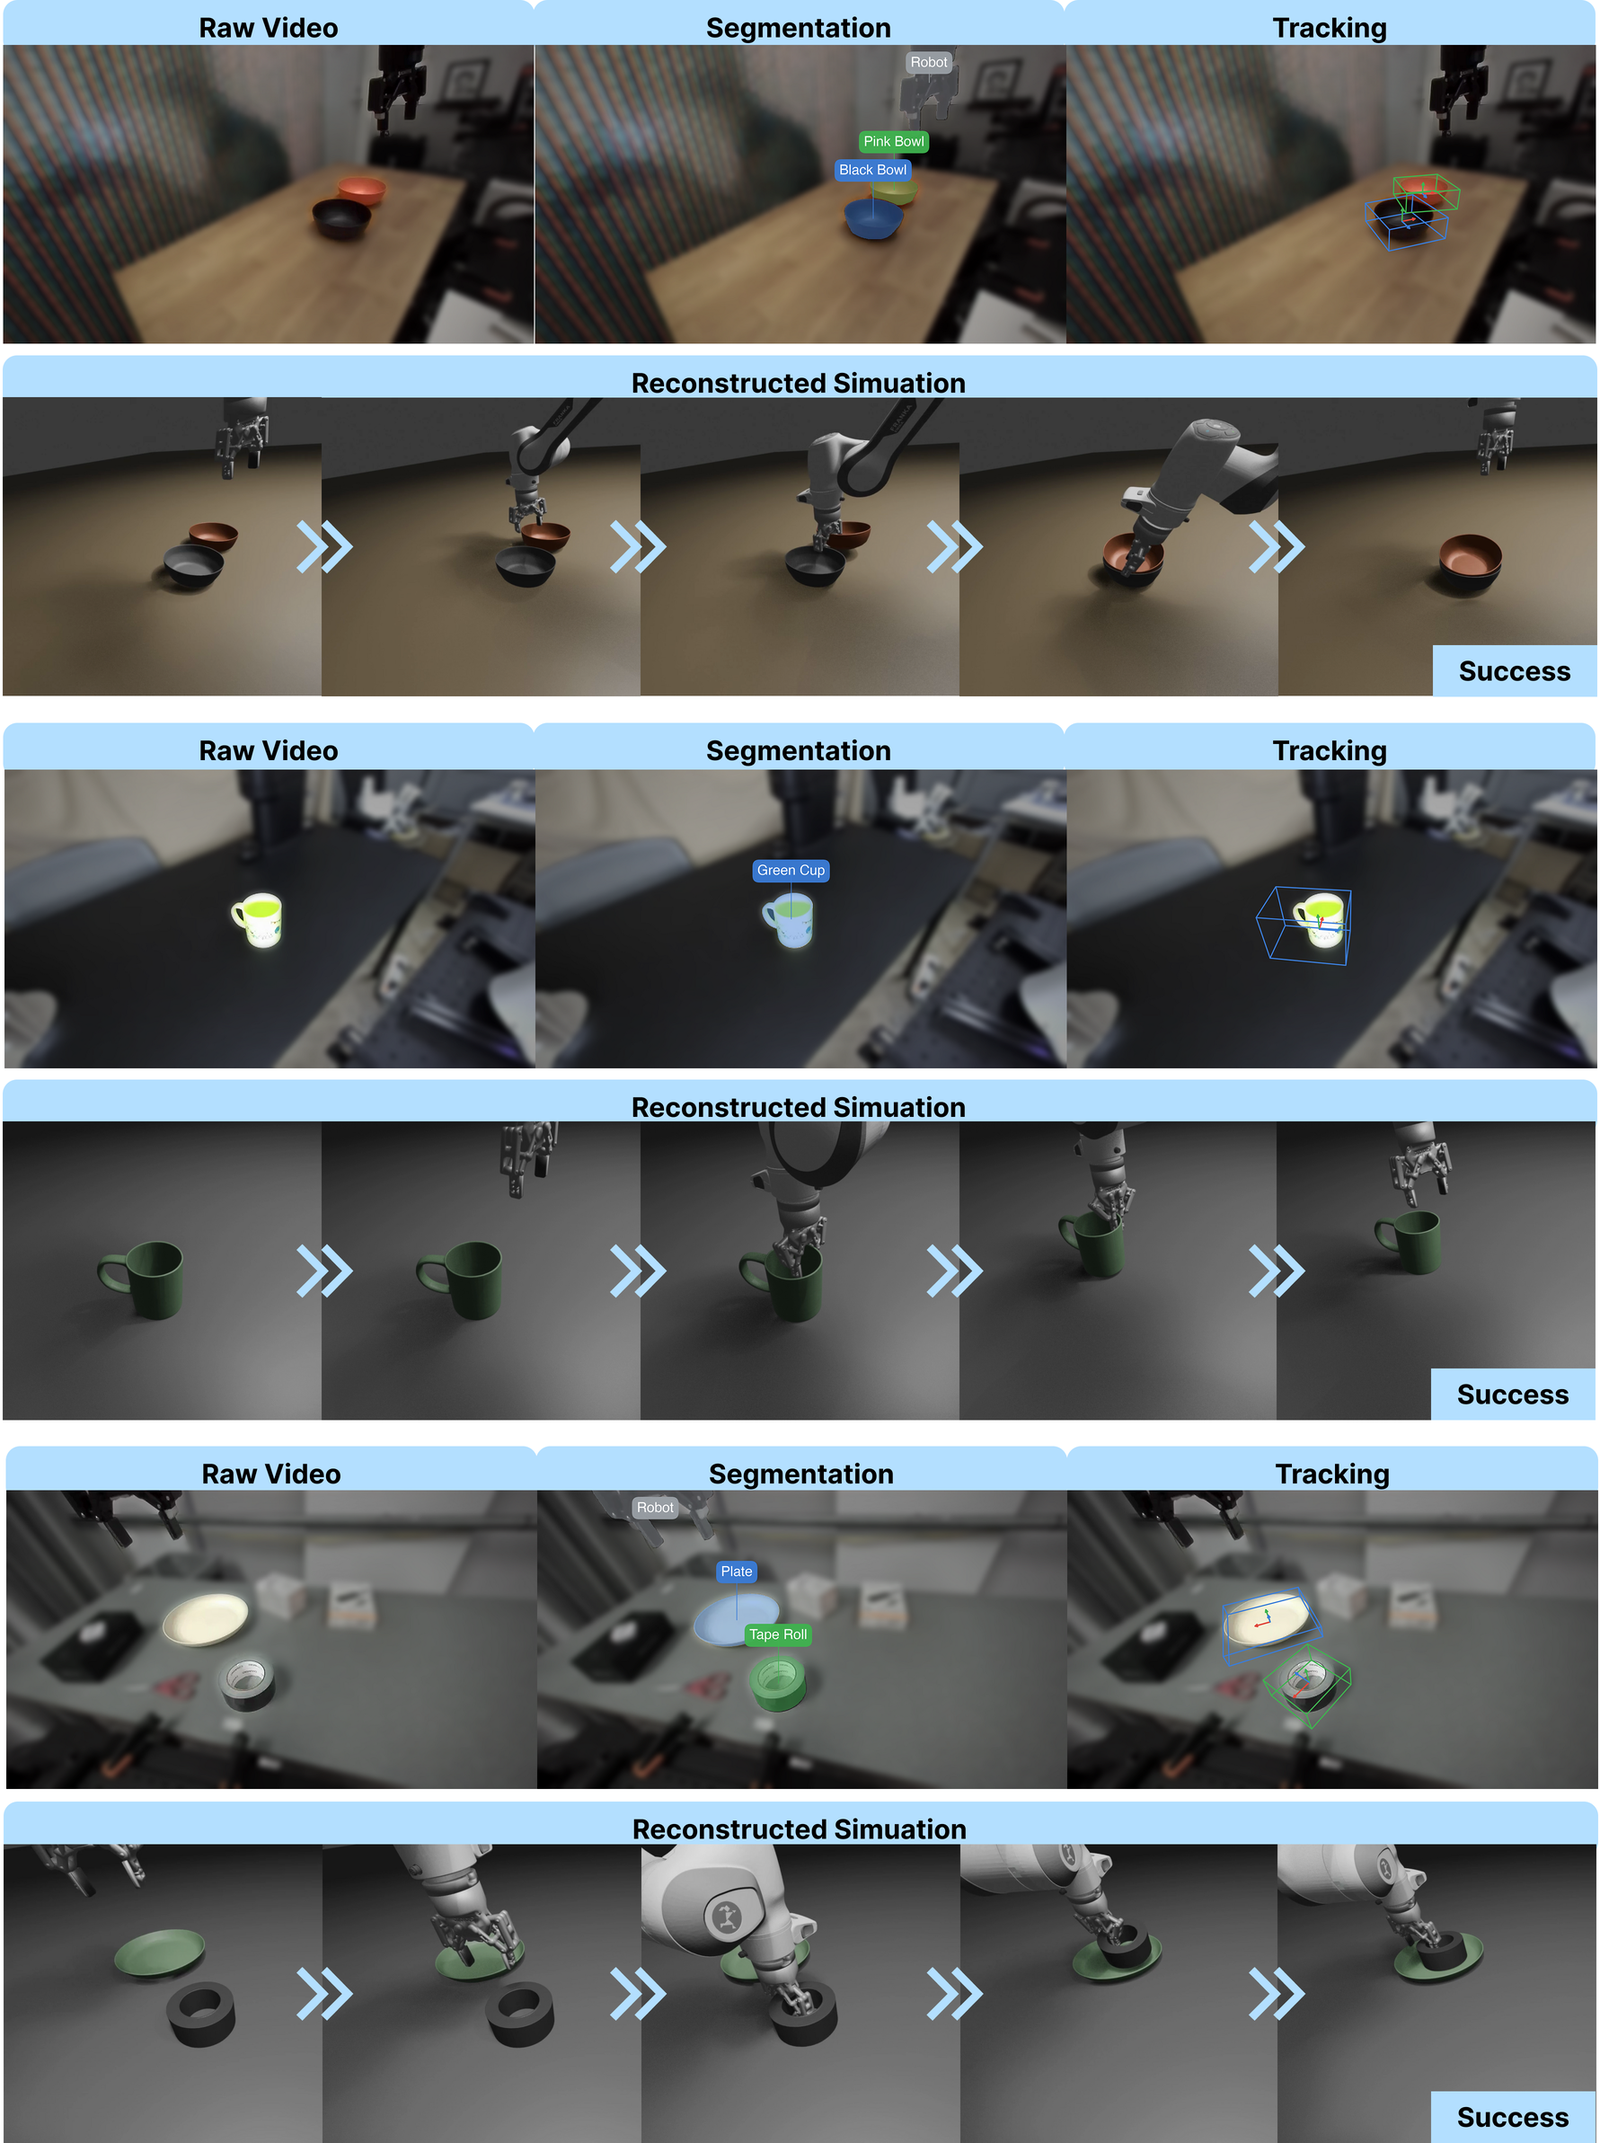
视觉处理智能体(Visual Processing Agent): 面对来自真实数据集(如包含多路同步相机的 DROID 机械臂数据集)的原始视频,智能体负责挑选主要视角相机、从复杂场景中发现候选操作实体,并自适应选取高质量关键帧。系统接入了 SAM 等开集分割工具与深度估计模型,并引入分割评判机制(Mask Critic),若分割质量不合格可在预算内重试。随后,结合深度信息与 FoundationPose 工具完成 6D 姿态追踪与三维网格缩放。
-
物理先验推断智能体(Physical-Prior Inference Agent): 从纯视觉图像中很难直接测定物体的质量与内部属性。此时 VLM 发挥强大的多模态常识推理能力,将视觉特征与语言指令结合,推断出物体的材质类别(如塑料、金属、泡沫)、质量大致范围以及关键的接触参数,将其转化为仿真器所接受的动力学配置文件。
-
场景准备智能体(Scene Preparation Agent): 物理仿真常因为坐标系错位而崩溃。该智能体专门处理空间对齐问题,精确标定机器人基座、目标物体与环境摄像机之间的相对位形,并调用语义理解确定整个场景的地面参考面(Ground Reference),避免物体在仿真刚启动时发生凭空掉落或穿模爆炸。
-
仿真在环抓取优化(Simulator-in-the-Loop Grasp Optimization): 即使静态位姿对齐无误,直接重放末端轨迹仍可能因为厘米级的追踪漂移导致夹爪抓空。系统在 MuJoCo 物理仿真中执行主动探索与扫描,对目标物体的初始放置位姿进行微米/厘米级的闭环寻优微调,直到机械臂能够稳定抓取并复现目标行为。
严格的物理重放评测与低成本模型验证
为了客观量化转换质量,研究人员构建了 DROID-100 基准,从中随机抽取了 100 个涵盖不同相机视角、遮挡模式以及推、取、放、插等代表性操作动词的真实操作片段。评测并未采用宽泛的“主观打分”,而是引入了基于多模型交叉评判的严格打分规程:在起始、两个中间帧和结束帧四个锚点处,三位独立的判官针对目标物体标识、最终位置误差、动作匹配度与夹爪末端偏差进行综合评分,只有得分达到 8 分(满分 10 分)以上才被计入真正的转换成功。
评测展现出两个极具行业启示的关键发现:
-
开源模型表现亮眼: 使用开源的 Gemma 4 31B 作为智能体底座时,在 DROID-100 上达成了 48 次完全成功与 8 次部分成功,这一表现不逊于甚至略微优于同台测试的顶级闭源大模型。
-
调用成本断崖式下降: 由于整个框架将 VLM 的调用限定在模式固定的结构化决策节点(如选择帧、识别操作目标、判定追踪漂移),而非让模型盲目发散生成代码,开源 31B 模型运行 100 个完整情节的总账单仅为 2.62 美元,而调用顶尖商用模型的账单则高达 82.30 美元。
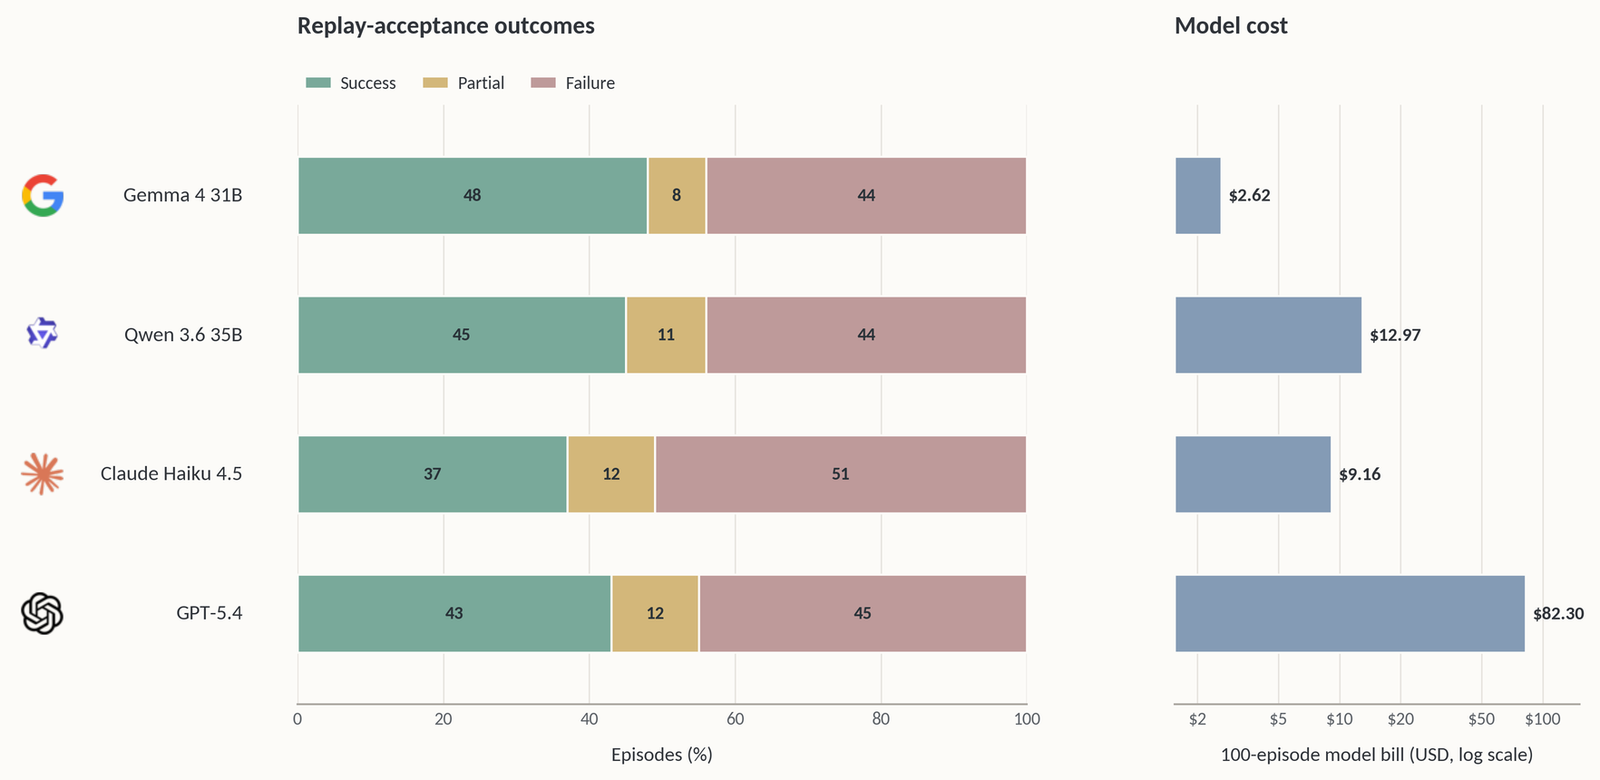
这也揭示了一个核心趋势:在复杂的机器人具身转换任务中,限制成功率上限的往往是底层的立体视觉深度估计质量、单目 6D 姿态追踪的连续性,而非 VLM 的单纯参数规模。合理设定智能体的职责边界,小规模开权重模型同样能在具身智能基础设施中充当高可靠的中枢。
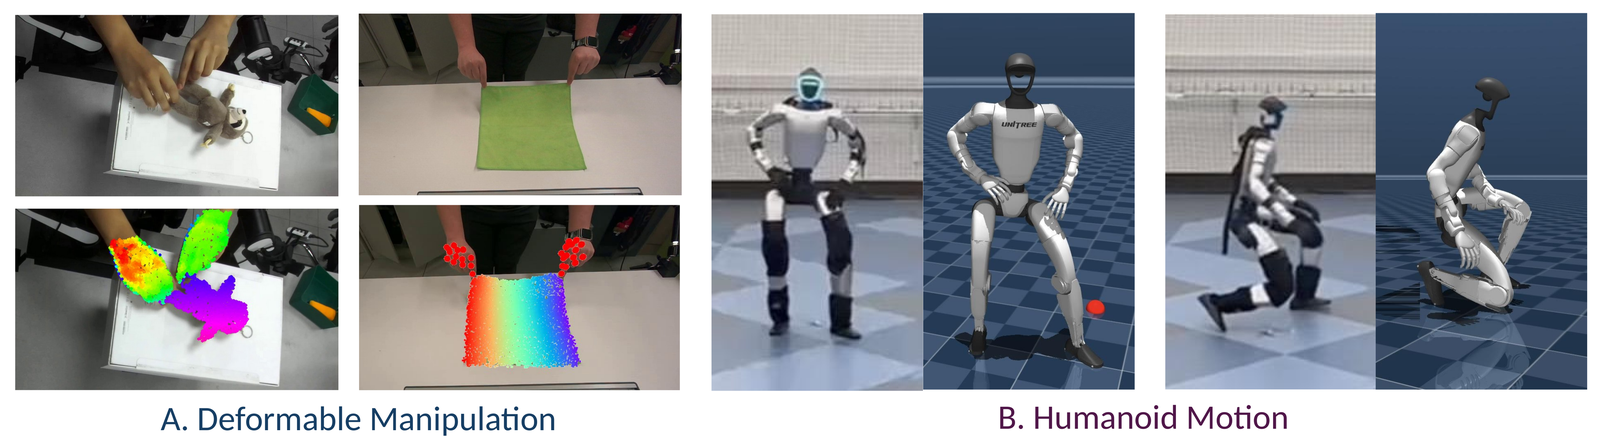
扩展至非刚体形变与双足人形控制
除了在以刚体操控为主的 DROID 数据集上进行大规模验证,Agentic Real2Sim 还证明了这套“输入-智能体提炼-物理重放-反馈优化”契约的良好泛化性,将其无缝拓展至另外两个截然不同的物理动力学场景:
-
可变形物体交互(PhysTwin 风格): 面对绳索、布料、毛绒玩具及软质包装等弹塑性材料,系统将刚体 6D 位姿追踪替换为三维几何点云与弹簧粒子状态的跟踪,并通过仿真回放校验恢复的材质形变参数,精确还原真实视频中的拉伸、弯曲与接触。
-
人形机器人全身运控(BFM-Zero 风格): 在 Unitree G1 人形机器人场景下,系统调取动作先验进行闭环重定向,在仿真物理引擎中自适应调节关节控制增益,使得机器人在站立、跪倒及短距离行走过程中保持质心稳定并与真实时序相位一致。
总结与展望
Agentic Real2Sim 为机器人社区提供了一个将海量真实操作视频转化为高价值物理资产的可行范式。它不再将 Real-to-Sim 视作碎片化的格式转换脚本,而是利用 VLM 智能体的综合常识与评判反馈,串联起从感知抽取到仿真器参数在环优化的完整闭环。
虽然在当前的 100 个剧集测试中,受限于上游视觉追踪遮挡和接触漂移,绝对完全成功率仍有待突破 50%,但这一探索验证了开源轻量级基座模型驱动物理数字孪生构建的实用性。随着底层 3D 视觉追踪感知工具的迭代,这一框架有望进一步降低现实数据转化为机器人强化学习“合成练兵场”的技术门槛。