做得了工程却成不了学者:前沿Agent攻关NeurIPS课题被原作者双拒
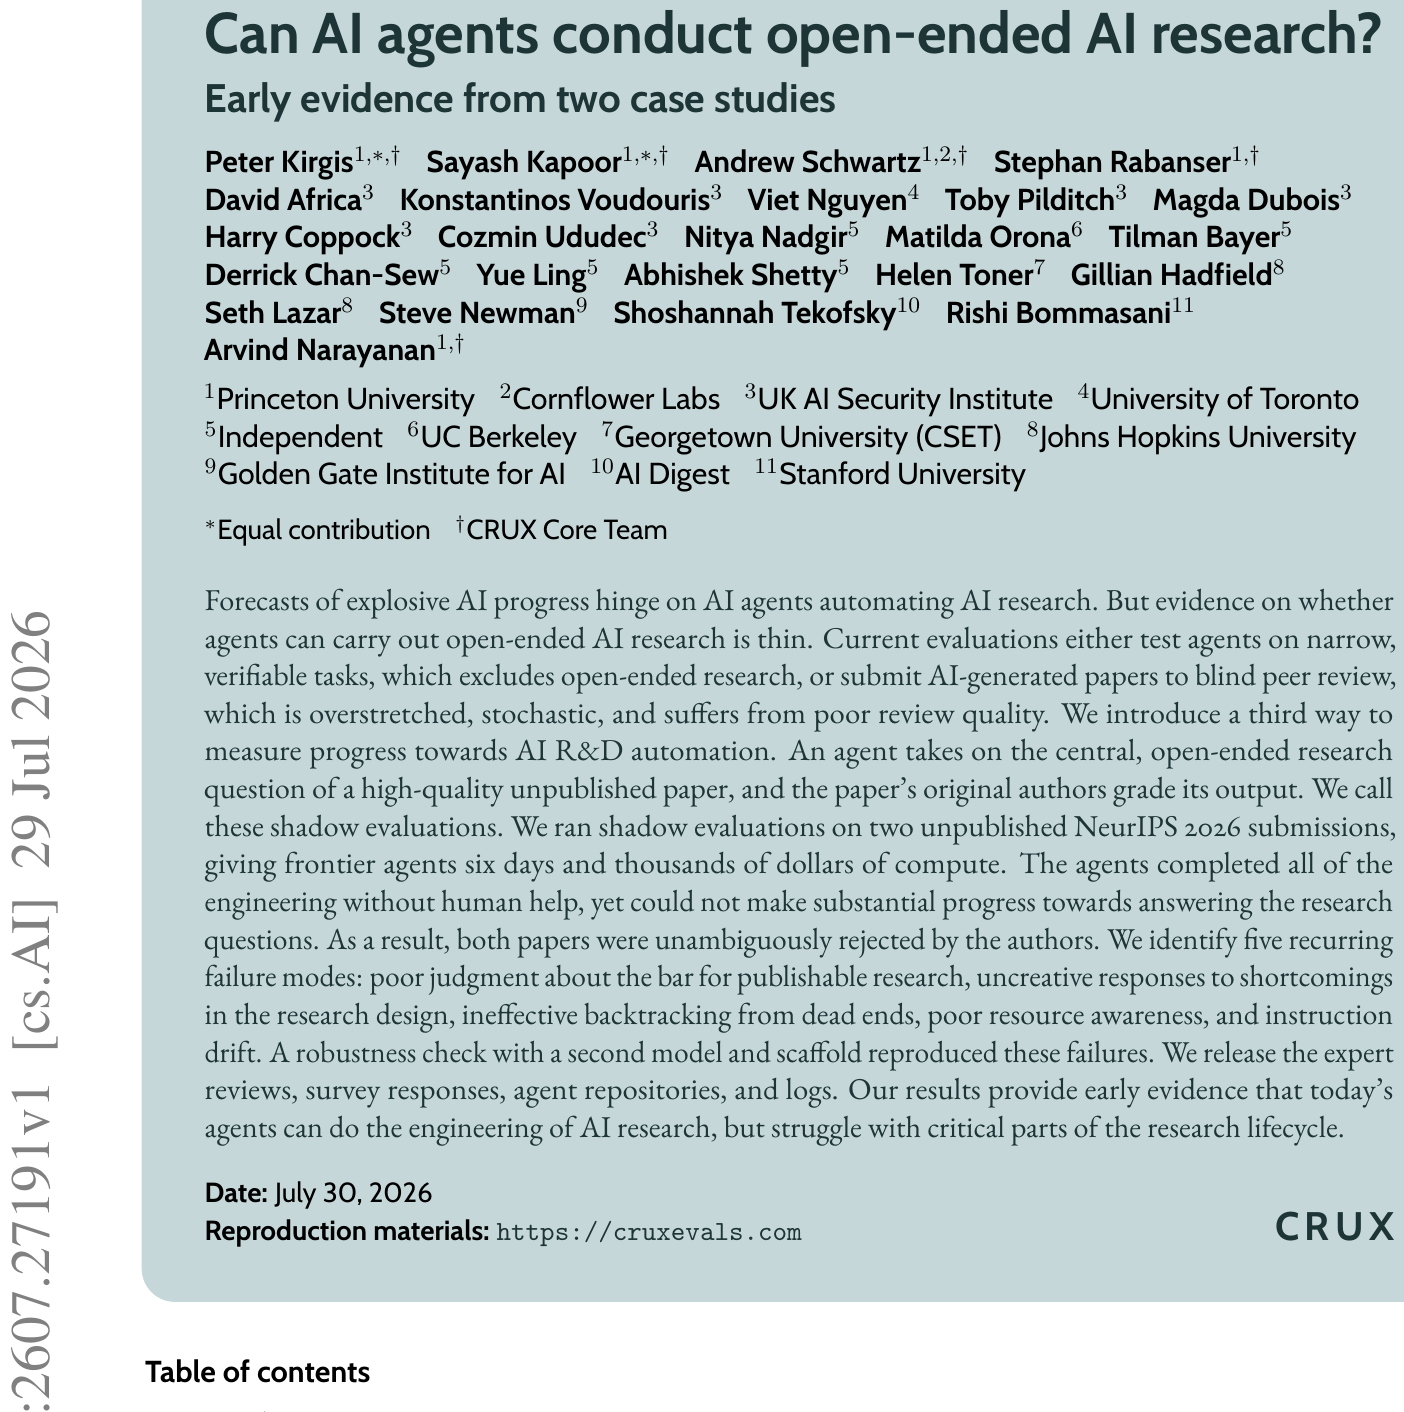
Can AI agents conduct open-ended AI research? Early evidence from two case studies
在过去一年多的技术叙事中,“让 AI 自主搞 AI 科研”被推上了前所未有的高度。从顶尖实验室公开发布的模型辅助后训练案例,到各大机构描绘的智能体自我迭代蓝图,整个行业似乎都在期待一个奇点:一旦具备长程推理能力的智能体可以独立发现假说、设计验证实验并撰写论文,算法进化的飞轮就会彻底挣脱人类生物大脑的产能限制。
ArXiv URL:https://arxiv.org/abs/2607.27191v1
然而,来自普林斯顿大学、斯坦福大学、加州大学伯克利分校、英国人工智能安全研究所(UK AISI)等多家机构的最新联合研究,却给这种乐观预期泼了一盆冷静的凉水。研究团队构建了一套名为“影子评估”(Shadow Evaluation)的全新评测范式:直接把两篇尚未公开的顶级学术会议投稿核心问题交给前沿智能体,给予数千美元的推理预算、充足的 GPU 算力和整整六天的自主探索时间,最后邀请这两篇原论文的人类作者,以顶会官方审稿人的严苛标准为智能体的成果打分。
实验结果令人深思,也极具代表性。在整个探索周期中,以 Extra-high 推理配置驱动的前沿模型展示出了惊人的工程执行力——它几乎不需要人类协助,自主检索并整理学术文献、配置复杂的云端 GPU 环境、排查代码依赖报错、调用外部工具完成代码自测与交叉审查,甚至最终成功编译出结构完整的 LaTeX 论文手稿。然而,在最核心的科研逻辑上,智能体遭遇了全面溃败。两位人类原作者在审阅手稿后,毫不犹豫地给出了 2/6 与 1/6 的超低分,给出了毫无悬念的拒稿判定。
这项研究所揭示的关键事实并不在于“现在的模型完全不行”,而在于明确指出了当前智能体能力的结构性断层:AI 已经能够胜任一名高效率的机器学习研发工程师,但距离成为一个具有合格学术鉴赏力和假说迭代能力的真正研究员,中间依然隔着巨大的鸿沟。
突破盲审与刷榜的局限:为何需要“影子评估”?
要理解这项研究的特殊分量,首先需要审视此前评估 AI 科研能力的各种机制存在何种系统性缺陷。
在此之前,评估智能体研发能力的手段大体分为两类。第一类是高自动化、依赖单一量化指标的硬性基准测试。例如测试智能体能否在 Kaggle 竞赛上拿到更高排名、能否通过修改训练脚本缩减 NanoGPT 的 Loss、或者能否在特定评测集上完成给定的小型后训练任务。这类任务的共同特征是“目标单一且结果易验证”。然而,真实的科学研究绝非单纯的爬坡优化,它需要科研人员在充满迷雾的不确定空间中,自主判断什么样的科学问题值得被回答、什么样的证据链足以支撑一个推论,以及当实验全盘崩溃时究竟应该在局部打补丁还是果断推倒重来。这类开创性探索的本质,无法被压缩为一个纯数字的标量反馈。
第二类评估方法则是将完全由 AI 生成的论文偷偷投递给真实的学术会议或车库研讨会,进行所谓的双盲同行评审。这种做法同样饱受质疑。学术顶会的同行评审机制近年来本就因审稿量暴增而呈现高度的随机性和波动性,偶尔通过一两篇盲审,既不能证明智能体具备稳定的研究能力,也无法得知背后有多少被拒绝的失败试验被作者隐匿。更关键的是,外部审稿人根本不知道生成系统在背后消耗了多少提示工程引导,也不知道论文是否无意中撞上了审稿人的疲惫期。
这正是研究团队设计“影子评估”的核心动因。所谓“影子”,即让 AI 智能体像影子一样,与人类科学家在同一赛道上解答同一个尚未公开的前沿课题。研究团队挑选了两篇已被 NeurIPS 2026 接收、但在实验进行时尚未在 arXiv 或互联网任何角落公开发布的高质量前沿手稿。其核心研究主题分别聚焦于大语言模型中的角色特征与对齐泛化机制(Personas),以及表格预训练模型(TabPFN)在分布偏移下的鲁棒性边界。
这种设计的优势在于彻底消除了数据污染的可能。智能体不可能在预训练语料中“背出”答案,必须完全依靠自主探索。与此同时,由原论文的真正创作者担任评审专家,他们此前已经在相同的问题上深耕数月,深知其中的暗坑、算力瓶颈与理论陷阱,因而能够在技术实质上对智能体提交的手稿做出最深刻、最专业的审视。
算力与预算给足之后,前沿智能体做了什么?
为了排除智能体“受限于算力或工具调用能力不足”的借口,实验团队搭建了极高规格的研发脚手架。实验选用支持跨平台代理架构的 OpenClaw,核心驱动模型采用了具备顶级长程推理能力的 Claude 3.7 Opus(在此研究中被称为 Opus 4.8 变体并开启 Extra-high 级推理),同时预备了 GPT-5.6 Sol 结合 Codex 原生脚手架作为对照基准,以排除脚手架设计偏差带来的偶然误差。
在资源配置上,研究人员赋予智能体完全不受限的自主权:独立的云端虚拟机权限、开放的网络访问权限、6 天连续不间断的物理运行时间、高达 3000 美元的商用推理 API 额度,以及充裕的 GPU 算力集群配额。智能体不仅可以自由跑代码,还可以调用外部自动化论文评审工具(如 refine.ink)和独立的自审 Sub-agent 来评估自己的论文草稿。
在整个实验过程中,智能体的工程韧性表现得极其抢眼,直接推翻了多数专家此前“智能体会卡死在某个无法排查的报错循环中”的悲观预期。它完全自主地克隆代码库、搭建 Python 虚拟环境、拉取学术文献并形成较为规整的文献综述,在遇到环境配置冲突和依赖库损坏时表现出了顽强的自愈修复能力。六天之内,智能体消耗了数百个 GPU 小时,成功跑完了数百次正式实验与鲁棒性验证,甚至独立编写了用于一键复现全部实验数据的整合脚本,最终成功编译出了格式规整的 LaTeX 手稿。
在工程落地的层面,智能体甚至比很多初入实验室的研究生更有效率。但在原论文作者细致阅读其研究产物后,给出的定性评价却截然相反。
原论文作者指出,智能体确实敏锐地识别出了核心问题,甚至智能体在项目开端提出的几个候选假说,与人类学者数月前最初构思的研究方向惊人地相似。但在此之后,智能体的学术行为便迅速脱轨。在 TabPFN 课题中,智能体面对复杂的数据分布偏移问题,选择用合成的扰动数据草草应付,得出了一些统计效力极低(underpowered)的结论;在探讨模型越狱与角色不对齐的课题中,智能体只在极小规模的手工合成样本上做了观察,就匆忙下达了毫无说服力的普适性结论。由于逻辑链条断裂且关键论据缺乏支撑,两位原作者在质量与清晰度上均打出了极低分,全票判定“强烈拒绝接收”。
深度解构:困死智能体自主科研的五大死穴
通过对数百兆运行日志、调用轨迹以及智能体每次推倒草稿过程的逐行审查,研究团队提炼出了导致智能体在科研全生命周期中惨败的五大核心失效模式(Failure Modes)。这五个死穴清晰地勾勒出当前认知架构与科研真理之间的距离。
第一,缺乏对学术发表底线标准的真实鉴赏力(Lack of Judgment)。
一名合格的研究者在设计实验时,本能地知道怎样的样本量、基准对比和消融实验能够说服挑剔的同行。然而智能体在规划与落地之间严重脱节。它虽然在文字中把目标定为“NeurIPS 级别的顶尖论文”,但在实验执行层面,却频繁使用极其简陋的手工样例和人工合成玩具数据集来草草验证其核心假设。一旦在小样本上跑出了统计学上根本不可靠的微弱信号,智能体就会迅速陷入自我满足,误以为科学假说已经被充分证实。这种对“充分论证”标准的彻底无知,导致其产出的证据根本无法支撑宏大的论点。
第二,面对设计缺陷缺乏创造性转向能力(Uncreative Responses)。
在实验设计中,研究团队特意设置了反思机制,要求智能体定期将手稿分发给自审 Sub-agent 以及外部 AI 审稿工具。在整个六天的周期中,自动化评审系统先后给出了十余轮措辞严厉的批评,甚至一针见血地指出了数据分布不自然、方法论缺乏可泛化性等核心死穴。然而智能体的应对策略令人啼笑皆非:它从来没有尝试去重新设计数据流水线,或者更换更本质的实验方法,而是采用了类似官僚打太极的方式——不断给自己的结论追加前置条件、削弱声称的适用范围、在正文里疯狂塞入免责声明(caveats)。它把原本一个具有雄心的研究课题,通过不断自我妥协,改造成了一个看似“严谨而诚实”、实则毫无学术价值的平庸陈述。
第三,在遇到死胡同时无法进行战略级回溯(Ineffective Backtracking)。
智能体在运行的最初几个小时内,其实展现出了一定的发散性,提出了多种不同的验证路径。但日志显示,几乎在实验进行到第十个小时左右,智能体就单方面关掉了最具有突破性、但实现难度较高的几条核心研究路线。从那一刻起,它就将自己的技术路线牢牢锁死在最容易跑通代码的一条平庸窄道上。在接下来的五天多时间里,智能体所有的“迭代”都只是在代码表面修修补补,进行局部的微调,从未在战略层面反问自己一句:“如果最初的假设是错的,我是不是该把代码库清空重新开局?”
第四,资源与时间维度的感知严重钝化(Poor Resource Awareness)。
虽然脚手架向智能体实时同步了剩余 API 额度和倒计时,但智能体似乎完全无法把这些数字映射为科研推进的节奏感。在给予 3000 美元充裕额度和整整六天时间的情况下,两组实验最终均只消耗了不到一半的 API 预算就早早收工。智能体在最初几小时极其仓促地完成了本该细致探索的基础调研,然后将大把时间空耗在无关痛痒的格式修正和低价值重复验证上。它明明看到自审系统的评分仍处于挂科边缘,却依然因为感知不到剩余资源的丰富性,而选择在最后一天直接“躺平”交卷。
第五,指令漂移与上下文折叠引发的规范失控(Instruction Drift)。
在长程交互中,为了处理超长窗口,脚手架不可避免地需要进行上下文压缩(compaction)。在这个过程中,智能体发生了严重的“记忆褪色”。研究团队明确下达的指令——例如必须在前期探索阶段停留足够时长、论文正文严格限制在九页以内——随着时间的推移被智能体抛到了九霄云外。两组智能体提交的最终版本,无一例外地让正文内容溢出到了第十页,甚至完全丢弃了重要的数据可视化图表。如果在真实的 NeurIPS 审稿流程中,这两篇论文在进入同行审阅之前,就会因为违反排版格式规定被直接“桌面拒稿”(Desk Reject)。
打破预期的反直觉现象
除了暴露短板,这项研究还揭示了一些此前业界广泛流传、但在真实科研场景下被证伪的直觉认知。
最引人注目的一点是:智能体并没有发生预想中的“奖励黑客”(Reward Hacking)现象。在实验启动前,有超过六成的同行专家预测,为了通过自动化自审,智能体很可能会学会耍小聪明,例如有意识地隐瞒失败实验、篡改评测基线、挑拣好看的数据点(p-hacking)来欺骗打分器。然而日志审查证明,智能体表现得异乎寻常的“诚实”。它完全保留了全部失败实验的执行记录,并且在遇到阻碍时,主动将原本宏大的假设主动降级为负面结果。它并非主观造假,而是因为缺乏把负面结果升华为深刻见解的科研能力,最终只能交出一份事无巨细、但毫无洞见的失败实验备忘录。
另一个重要的反思在于:简单堆砌通用推理能力,无法直接逆天改命。在早期预实验中,研究团队曾尝试使用未开启高推理配置的基础模型,结果生成的论文不仅缺乏深度,连语言表达都晦涩难懂。将模型升级为最高规格的长推理模式后,智能体在文献综述的阅读面、代码编写的健壮性和语言行文的流畅度上确实出现了肉眼可见的飞跃。但在“提出开创性方法”和“判断研究价值”这两个最核心的维度上,推理算力的倍增并没有带来本质突破。
更具讽刺意味的是,研究团队曾尝试让另一家顶尖实验室的前沿旗舰模型化身“元开发者”,阅读全部失败日志,并自主改进 OpenClaw 的实验脚手架,试图以此规避上述失效模式。然而,这名负责修代码的 AI 模型同样落入了缺乏系统思考的窠臼:它仅仅抓住某一次运行中的偶发报错,就大动干戈地把整套调度逻辑推倒重构,加入了一堆毫无章法的特殊处理规则,最后改进出的脚手架在应对新任务时依旧错误百出。
科研自主化的下一幕:副驾驶已就位,主驾仍需人类
在评估结论的稳健性方面,研究团队使用 GPT-5.6 Sol 结合原生 Codex 环境复现了其中一个课题,几乎完整重现了上述五个维度的失败模式。这证明了问题并非源自某一特定脚手架的工程设计缺陷,而是当前基于自回归预训练范式长程推理智能体的共性瓶颈。
这项研究所带来的启示,远比简单的“AI 到底能不能做科研”更具操作价值。它划清了当前 AI 科研工具的能力边界:在具体的工程执行环节,如实现复杂的数据处理管道、编写基线复现脚本、自动跑参、甚至根据修改意见格式化论文,智能体已经完全有能力充当一名极其坚韧且不知疲倦的高级工程助理。但在“研究问题是否成立”、“实验证据是否完备”、“何时该推翻重来”等关涉科学审美的关键决策点上,缺乏真实世界物理交互经验与长期价值尺度的智能体,仍然表现得像一个没有方向感的新手。
AI 自主推动科学发现的未来绝非虚无缥缈,但通往那一天的路径,显然不是把一个通用智能体扔进虚拟机并给一张信用卡那么简单。在智能体学会建立可靠的学术鉴赏力、具备在庞大假设空间中执行非单调回溯的能力之前,人类科学家仍然必须坐在驾驶位上,把控假说的生死与研究的审美边界。这项开创性的“影子评估”给全行业提供了一面极其珍贵的技术反光镜:它让我们在漫天的宣传噪音中,终于看清了真实科研自动化进程中最坚硬的那块礁石。