CameraAnything:解耦内外参控制,单次生成搞定运镜重拍与跨画幅适配
CameraAnything: Refilming Videos with Arbitrary Camera Control
用 AI 生成一段视频已经不再稀奇,但如果想把一段现成的视频“重新拍一遍”——比如让原本平移的镜头突然拉远、把焦距换成长焦拍出希区柯克式的变焦感、或是直接从横屏电影构图切成竖屏短视频,现有的视频生成模型往往无能为力。
ArXiv URL:https://arxiv.org/abs/2607.24591v1
以往的镜头控制方案存在明显的两难困境。一类方案依赖显式 3D 重建(如点云或 Mesh),先重建再重新渲染,但在动态物体与复杂几何面前极易崩溃并产生撕裂伪影;另一类方案直接训练生成式 Diffusion 模型,但几乎全部局限在外参控制(即相机的空间位姿),无法调整焦距,更无法原生适应不同的画面分辨率。当相机内外参在电影视听语言中深度耦合时(例如滑动变焦 Dolly Zoom 要求位移与焦距协同变化),现有工具更难以实现解耦控制。
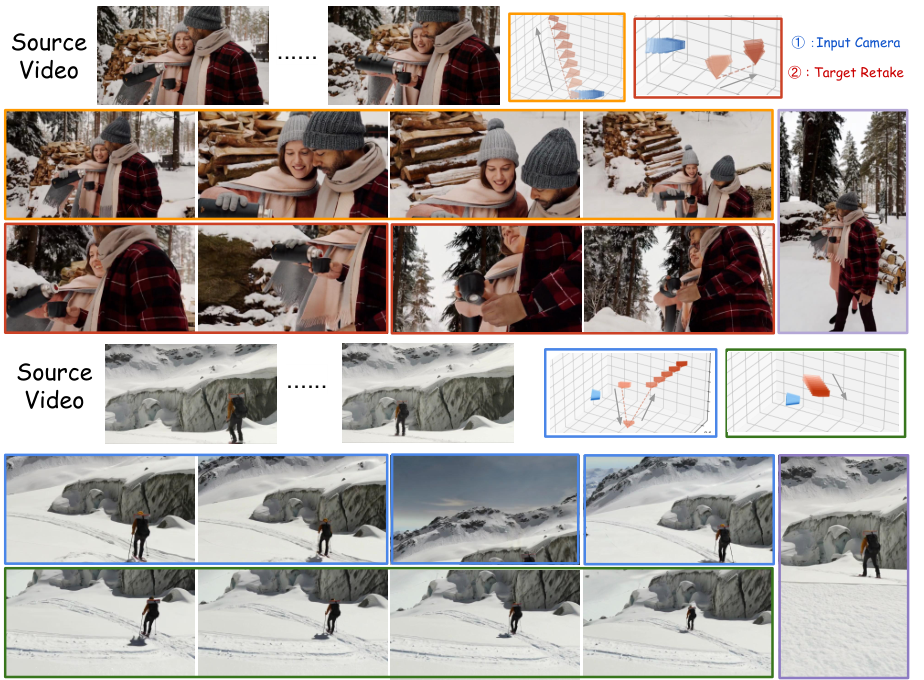
针对这一空白,来自蚂蚁集团、香港中文大学、香港科技大学、清华大学和浙江大学的研究团队提出了 CameraAnything。这是首个将相机外参、内参以及画幅比例统一起来的视频编辑框架。它无需先建 3D 模型,也无需外扩重绘(Outpainting)或裁切,仅凭一次扩散生成过程,就能在保留原视频内容的前提下,以任意视点、焦距、分辨率甚至分镜头跳切方式对视频进行全自由度的“数字重拍”。
为什么现有视频重拍总是“缺内参”?
在专业摄影中,视听语言往往是由相机外参(位置与旋转)与内参(焦距、视场角、成像分辨率)共同决定的。传统生成模型之所以难以支持完整的相机语言,关键在于相机内参和外参对画面像素表现的影响高度耦合。
以往最具代表性的工作如 ReCamMaster,通常是将展平的相机外参矩阵直接打包成特征向量,再整体注入到生成模型中。这种做法将整张画面的相机状态粗暴地压缩为单一的全局向量,完全抹平了不同空间像素在三维射线投影上的内在差异。这种基于全局特征的注入方式,既无法精细表达由焦距畸变带来的局部透视变化,更无法在输出分辨率变化时保持三维几何的内在自洽。
当用户试图把一个固定横屏的单镜头视频,重拍为带有景别推拉、镜头跳切并且适配竖屏画幅的内容时,现有的视频编辑模型就不可避免地陷入几何畸变、画面撕裂或运动轨迹失真的死局。
普吕克射线与 3D RoPE:让空间位置感知相机几何
CameraAnything 选择基于开源视频扩散骨干网络 Wan2.1-T2V-1.3B 进行深度重构。Wan2.1 依赖 3D 变分自编码器(3D VAE)将输入视频压缩进潜在空间,并使用 Diffusion Transformer(DiT)进行多步去噪。
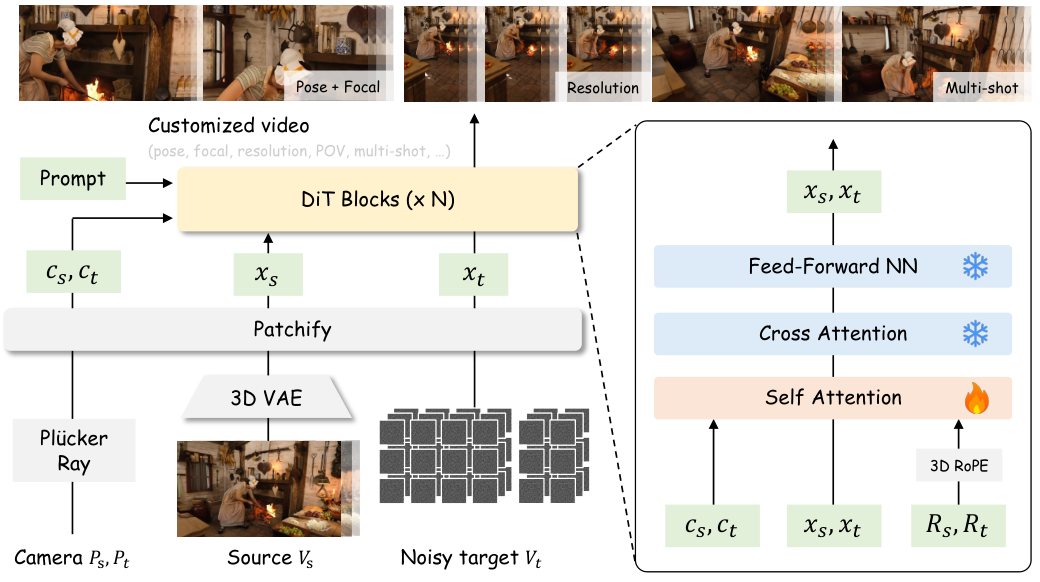
为了让目标视频能够充分参考源视频,框架借鉴了帧维度拼接(Frame-dimension Conditioning)机制,将源视频潜在 Token $x_s$ 与目标视频潜在 Token $x_t$ 沿时间轴直接拼在一起,构成双倍长度的输入序列。这种设计使得在自注意力机制中,目标帧与源帧的每一个 Patch 都能跨越时空自由交互,远比在通道维度拼接带来更稳定的内容一致性。
面对几何控制难题,研究团队系统对比了多种参数化表达与特征注入路径:
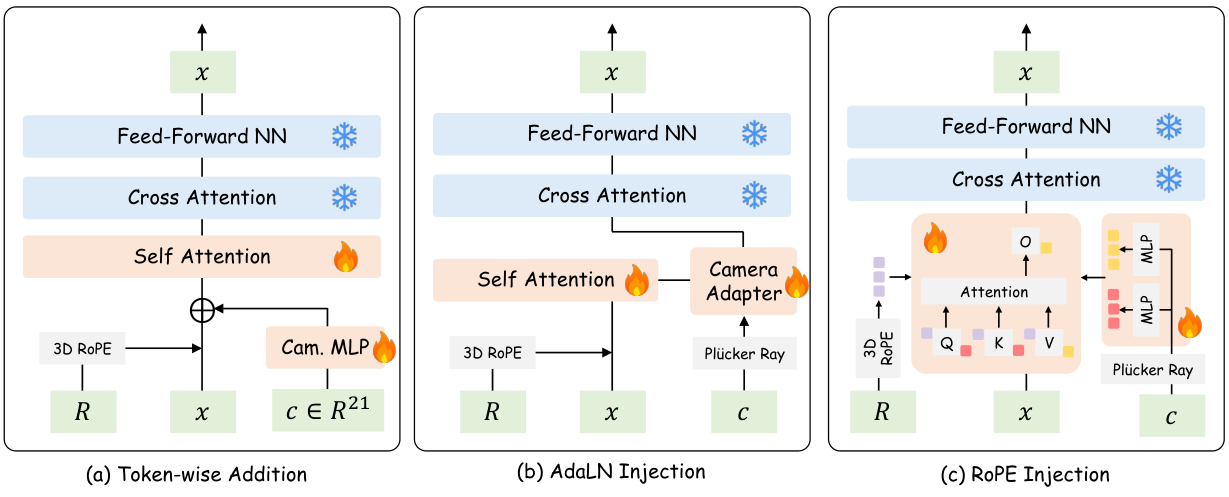
研究人员放弃了过去粗粒度的 21 维相机矩阵线性投影,转而采用普吕克射线(Plücker Ray)对每个 Token 进行精确的三维几何建模。对于目标画面中坐标为 $(u,v)$ 的任意像素,其在世界坐标系中的光线方向与相机光心均可由外参矩阵与由水平视场角(hfov)构成的内参矩阵 $\mathbf{K}$ 精确推导:
\[\mathbf{d}_{i,uv}=\mathbf{R}_i\cdot\hat{\mathbf{d}}_{i,uv},\quad\hat{\mathbf{d}}_{i,uv}=\left[\tfrac{u-c_x}{f_x},\;\tfrac{v-c_y}{f_x},\;1\right]^{\top}\big/\|\cdot\|,\quad\mathbf{o}_i=\mathbf{t}_i\]由光心与方向拼接而成的六维普吕克向量 $\boldsymbol{\pi}{i,uv}=[\mathbf{o}_i;\,\mathbf{d}{i,uv}]\in\mathbb{R}^6$,天然且唯一地锁定了从三维世界投影到二维像素的完整几何路径。更关键的是,这一表征原生兼容画幅比例调整:当目标分辨率 $H_t \times W_t$ 发生变化时,内参矩阵改变,对应的射线场也随之自适应重算,从根源上避免了遮罩外绘或后期拉伸裁剪所带来的画质衰减。
在特征注入方式上,研究对比了三种方案:
-
Token 维度直接相加(Token-wise Addition):虽然实现简单,但会直接干扰预训练模型内部的特征分布,在多重控制混杂时极易引发训练震荡。
-
自适应层归一化(AdaLN):利用相机特征预测 Scale 和 Shift 参数来缩放特征分布,保留了预训练先验,但对复杂几何细节的约束力仍偏弱。
-
基于 3D RoPE 的相位注入(RoPE Injection):最终被证明是最优雅且最有效的方案。团队借鉴了旋转相机编码(RoCE)的思想,将普吕克射线特征经过轻量 MLP 映射为旋转位置编码中的附加相移 $\boldsymbol{\phi}$:
\[\bar{\mathbf{q}}^{\prime}=\bar{\mathbf{q}}\circ\mathbf{R}_{\text{rope}}\circ e^{i\boldsymbol{\phi}},\quad\bar{\mathbf{k}}^{\prime}=\bar{\mathbf{k}}\circ\mathbf{R}_{\text{rope}}\circ e^{i\boldsymbol{\phi}}\]
在复杂的注意力计算域中,相机信息被具象化为一个高维旋转角度。当两个视觉 Token 共享几何自洽的视角与射线时,相移会主动放大二者之间的注意力相似度;而在空间几何上相互违背的 Token,其注意力权重则被天然压制。与此同时,3D RoPE 本身具有分辨率感知特性,其网格坐标直接基于目标潜在分辨率生成,让模型在改变画幅时无需更改底层骨干网络。
正交采样:12 种任务组合破除数据瓶颈
具备了强大的建模能力,训练数据成为下一步的关键壁垒。真实世界中几乎无法同时拍摄同一动态场景在不同机位、不同焦距和不同分辨率下的多路视频流。
为此,作者使用 Unreal Engine 5 搭建了大规模高保真合成管线。在三维动态场景中,系统布置了结构化多机位阵列,同步渲染出包含多种运动轨迹、动态连续调焦以及多视角画面跳切的视频对。
在此数据底座之上,研究团队提出了一种“正交训练策略”。整个生成任务被拆解为三个互相独立的控制维度:
-
相机外参控制:包含连续轨迹平移运镜或分镜头多机位跳切(Cut);
-
相机焦距调整:从广角到长焦的连续或离散变焦;
-
目标画幅比例:包含横屏(如 $480\times 832$)、竖屏(如 $832\times 480$)、方形(如 $640\times 640$)等不同比例规格。
这三个维度相互交叉,自然衍生出最多 $3 \times 2 \times 2 = 12$ 种任务组合。在训练批次中,模型不仅需要学会单独改变轨迹或单独缩放焦距,还要处理“大范围运镜 + 焦距拉伸 + 画面转竖屏”的复合指令。通过仅对自注意力层与新增的相机适配模块进行微调(其余权重全部冻结),CameraAnything 在保留原有视频先验的同时,建立了对相机参数极其敏感的几何控制流。
实验与实测:从合成场景到真实世界的泛化
在合成基准与真实视频数据集(DAVIS)的测试中,CameraAnything 展现出了全面的优势。
在定量评价中,对于外参和焦距控制任务,CameraAnything 在合成数据集上的重建峰值信噪比(PSNR)达到了 15.88 dB,显著超越了基于点云重建的 TrajectoryCrafter(12.24 dB)和此前最先进的 ReCamMaster(12.87 dB)。
在评估相机跟踪真实度的指标上,通过在生成视频上运行几何位姿估计工具 ViPE 反推相机轨迹,CameraAnything 展现了断层式的精度优势:
-
平均旋转误差(RotErr):从 TrajectoryCrafter 的 13.99° 和 ReCamMaster 的 5.12°,大幅降低至 2.76°;
-
平均平移误差(TransErr):控制在 0.33,明显低于对照方案的 0.99 与 0.46。
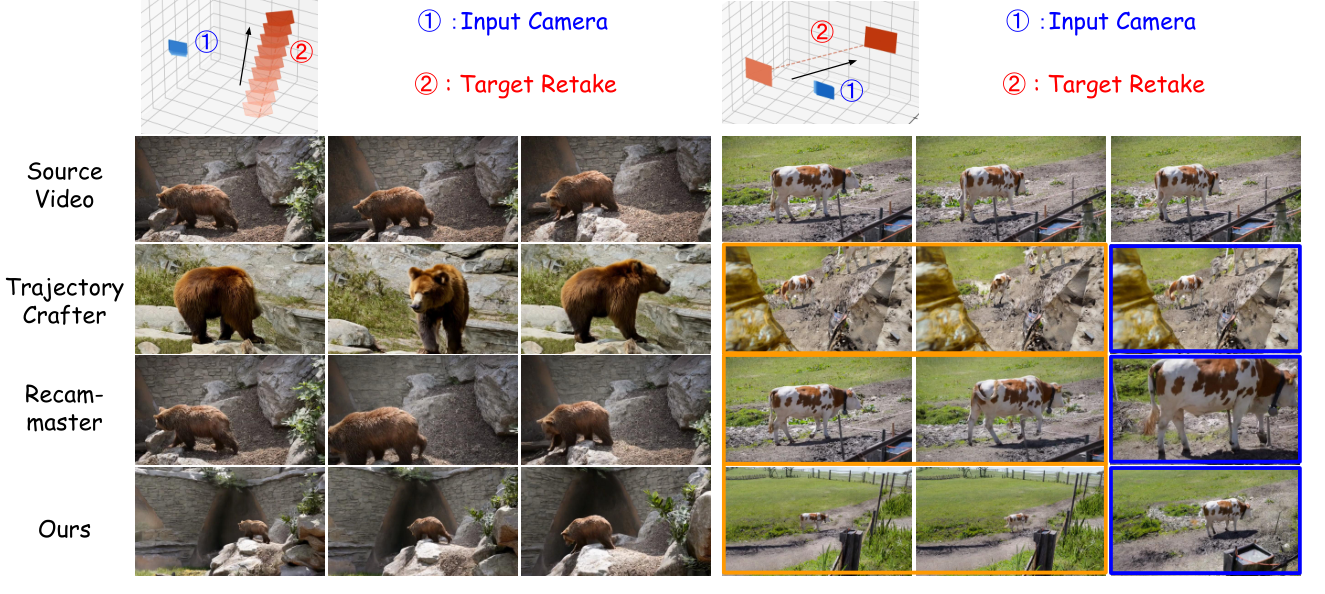
从定性表现看,基于点云的 TrajectoryCrafter 只要遇到大位移,生成的画面就会大面积破碎、物体边缘产生严重的拉扯伪影;而 ReCamMaster 倾向于将第一帧死死固定在原视频视角,缺乏跨机位跳切(Cut)的生成能力,遇到复杂多镜头序列时相机几乎无法遵循指令。CameraAnything 则能够在大幅度旋转、视角突变的情况下,依然稳定维持主体的一致性与场景几何的完整性。
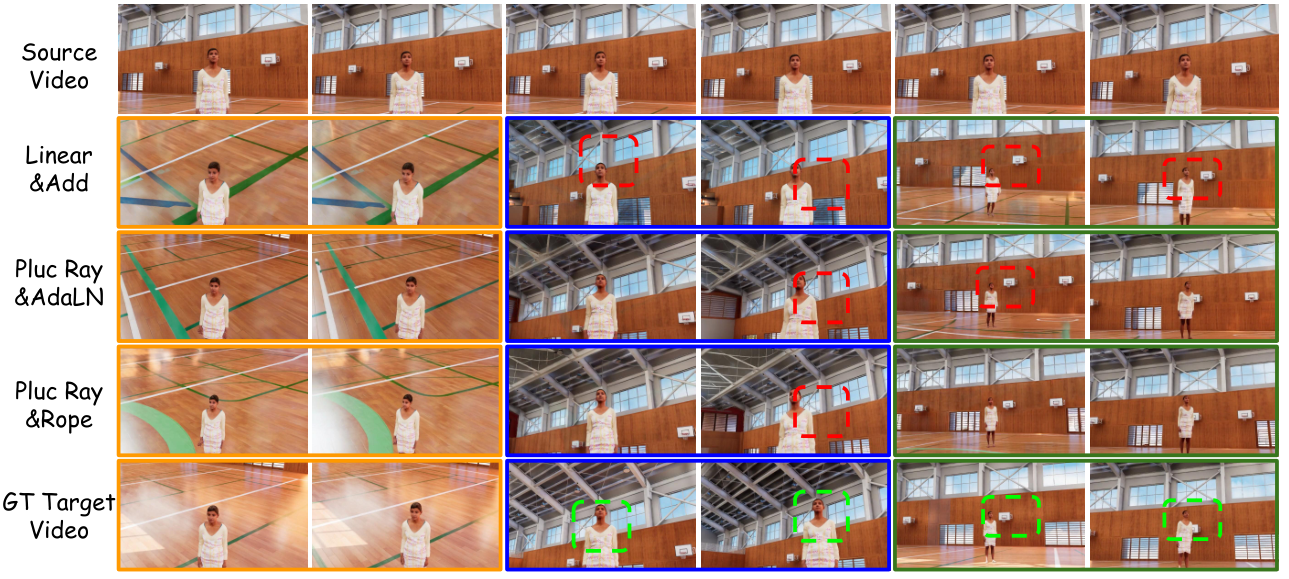
消融实验进一步证实了核心架构选型的必要性。如图 7 所示,若使用普通的线性相机表征或直接进行加法注入,画面常会出现明显的几何坍缩与模糊失真;唯有“普吕克射线 + 3D RoPE 注入”的组合,能够生成视差自然且纹理锐利的重拍画面。
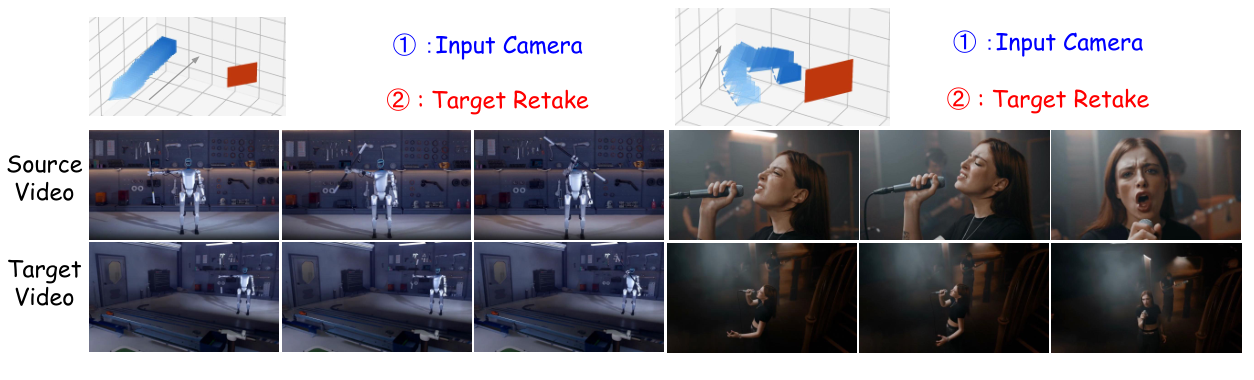
更令人惊喜的是其泛化能力。尽管模型完全是在合成的虚幻引擎数据上完成训练,但面对日常手持拍摄、真实复杂街景以及野生动物等未经修饰的视频素材(图 6),CameraAnything 依然能够精准解析源视频的隐式几何,完成极具电影质感的运镜重拍与跨平台竖屏画幅重构。
技术启示与影视工业前景
CameraAnything 的核心突破在于:它改变了视频重拍单纯依赖“外参位移”或“三维重建”的旧范式,证明了基于普吕克射线的密集内参注入与自注意力位置编码协同,可以在纯生成框架下完成极高精度的相机解耦控制。
这项研究不仅让 Dolly Zoom 等影视经典特效能够以纯算法的形式轻量化落地,更为工业级视频生产带来了直接价值:专业制作团队今后只需拍摄一次基础素材,即可在后期无损派生出适配横屏电视、竖屏短视频、特写分镜等全套物料,大幅拉低影视工业中多机位设置与重拍的资金门槛。随着内参控制与几何先验在视频大模型中的进一步渗透,“用提示词调度摄影机”的时代正在加速到来。