Hunyuan3D-Buffalo 1.0:从孤岛到统一,87M数据破解3D编辑
Hunyuan3D-Buffalo 1.0: A Unified Multimodal Model for Scalable 3D Generation, Understanding, and Editing
在二维多模态生成领域,图像理解、生成与局部编辑早已经历了从碎片化工具到大一统模型的范式转变。无论是基于自回归统一表征的架构,还是多模态理解与扩散骨干协同的混合系统,2D 视觉模型均已证明:当语义理解、内容合成与指令修改被置于同一个表征空间时,不同任务之间不仅不会互相冲突,反而能形成显著的跨任务能力互补。
ArXiv URL:https://arxiv.org/abs/2608.02711
然而,3D 领域的技术演进却长期处于分裂状态。长久以来,工业界与学术界对三维空间资产的处理被拆分得支离破碎:三维问答与空间定位(Grounding)依赖专门的 3D-VLM,高质量 3D 资产生成依赖基于流匹配或扩散变换器(DiT)的独立模型,而文本驱动的 3D 编辑则受困于逐个样本的优化、脆弱的 2D 视角反投影或无监督隐空间变换。导致这一割裂局面的核心痛点并非模型架构的设计受限,而是优质、规模化且在几何层面上绝对对齐的 3D 编辑监督数据极度匮乏。
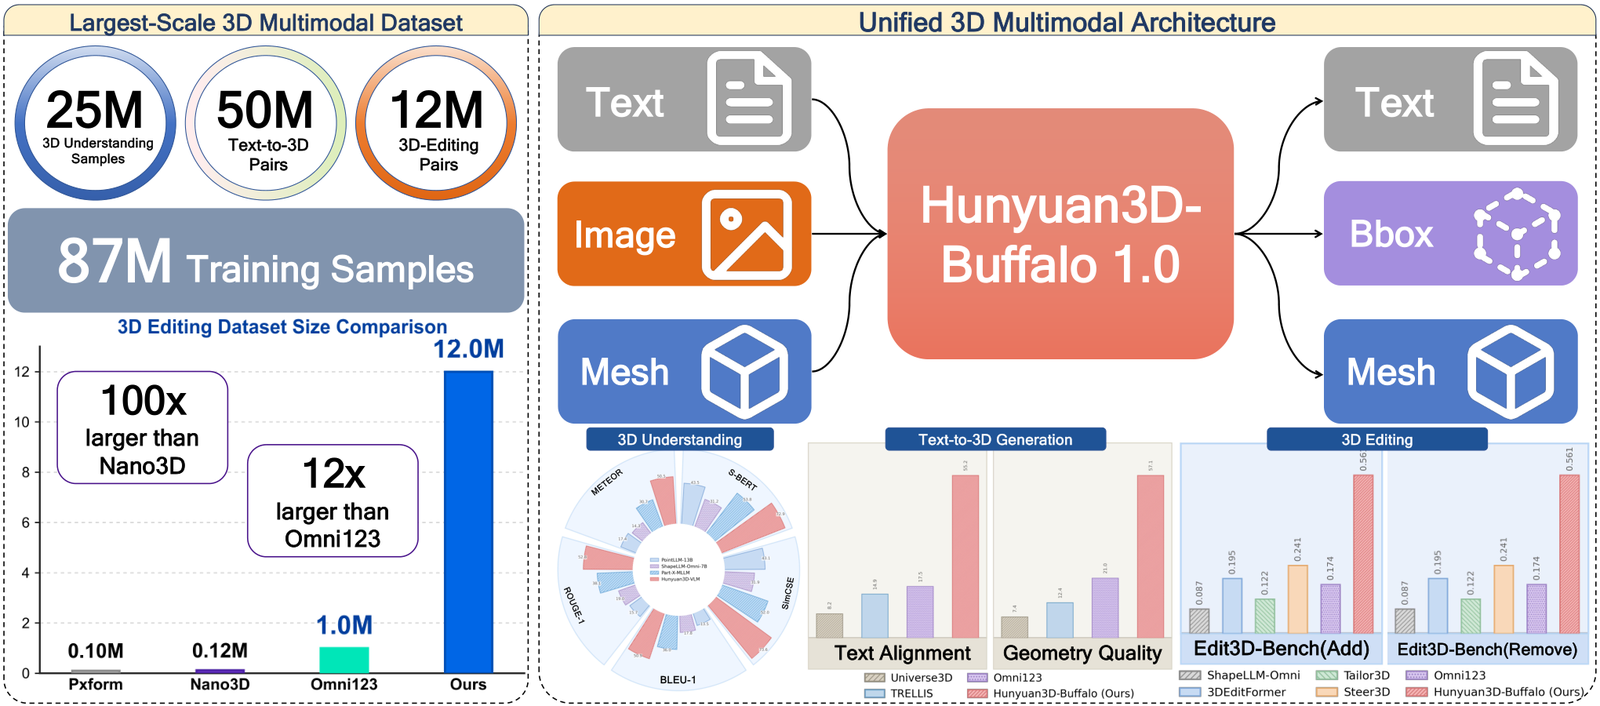
为了打破 3D 模型“各管一摊”的僵局,腾讯混元团队推出了全功能统一 3D 多模态框架 Hunyuan3D-Buffalo 1.0。该工作在单一系统内部,整合了 3D 细粒度理解、文本生成 3D、自然语言引导的 3D 编辑,以及文本引导的部件级生成。为了支撑这套庞大系统的训练,研究团队首先攻克了底层的数据地基,通过自动化智能体管线构建起规模达 8700 万(87M)的多模态 3D 语料库,其中包括 1200 万对高质量几何一致的 3D 编辑对。更关键的是,该研究在系统化评测中揭示了多模态 3D 训练中的双重协同律:更强大的文本生 3D 生成先验能够直接改善编辑生成的完整性,而更细致的 3D 空间理解能力则显著降低了编辑过程中的区域误伤。
割裂的三维建模:数据瓶颈与架构妥协
要理解 Hunyuan3D-Buffalo 1.0 的突破点,首先需要审视三维空间生成面临的结构性困境。在二维图像中,任意局部修图操作都可以直接映射到像素平面的替换,且互联网中天然存在大量修图前后成对的数据;但在三维世界中,资产包含顶点拓扑、法线、体素分布、表面材质以及复杂的内部空腔。
此前针对 3D 编辑的研究主要分为两大流派。第一种流派基于评分蒸馏采样(SDS)或 2D 扩散先验对单一三维模型反复优化,耗时数十分钟甚至数小时,且容易产生多头怪异的多视角伪影;另一种流派则先在 2D 渲染视角上做图像编辑,随后试图将多视角像素重建成 3D 资产,然而视角之间轻微的光照与形变不一致,就会在三维几何上引发严重的网格撕裂与结构畸变。至于免训练的隐空间操作,虽然可以快速编辑体素或潜变量,但在面对复杂指令和非刚性形变时缺乏稳定性。
这直接导致了三维模型训练的长期割裂:3D 理解模型看不到高精度几何生成的过程,生成模型无法理解复杂的局部空间方位,而编辑模型缺乏大规模数据投喂,只能停留在玩具级别的实验中。没有统一的语义-视觉-几何联合表征,3D 模型就始终无法形成通用智能交互能力。
87M 数据引擎:Nano3D-v2 如何制造海量三维编辑对
大规模监督训练的有效性完全取决于数据质量与规模。研究团队构建的 87M 训练语料分为三大块:涵盖语言推理与 3D 点云问答的 25M 理解数据、50M 文本生 3D 数据,以及规模前所未有的 12M 3D 编辑对。
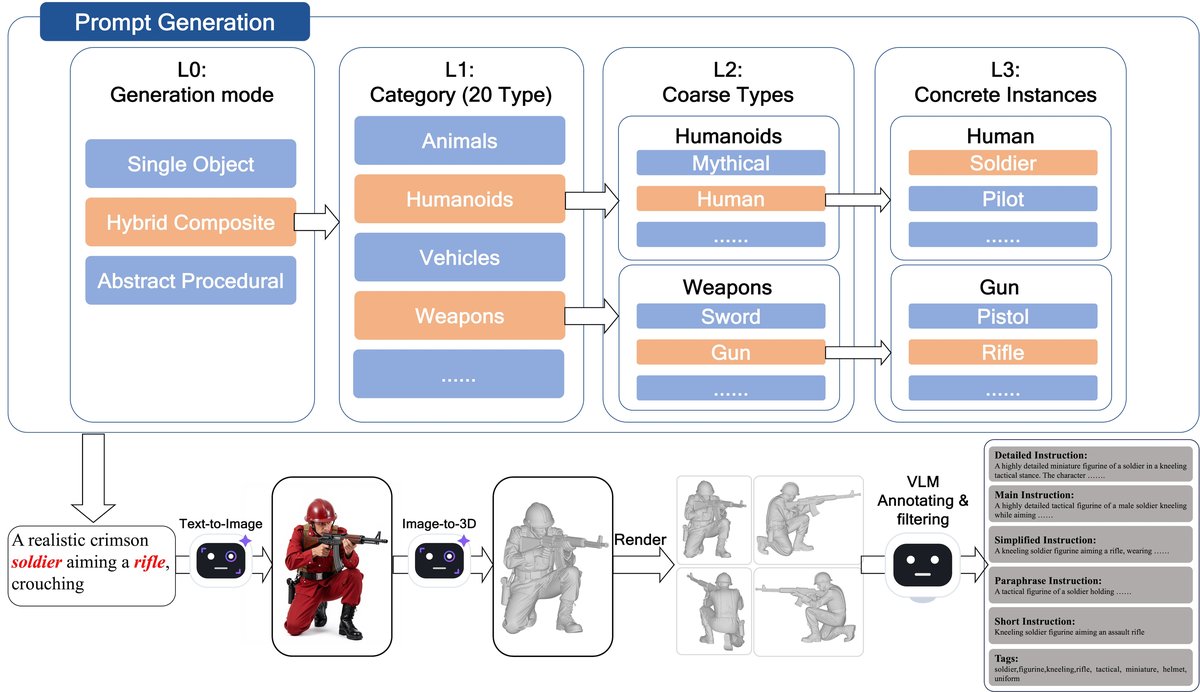
在 50M 文本生 3D 数据的构建中,研究团队采用了一套全自动的五阶段流水线。首先通过四级分层分类法(L0 到 L3)解耦概念与属性,结合交互采样器生成符合物理与常识规律的高复杂度组合提示词;随后借助图像到 3D 模型生成多视角资产,并在无贴图白模状态下引入多级描述生成与几何质量评分模型。通过施加极端严苛的白模缺陷打分标准,系统过滤掉了拓扑断裂、浮动碎片与肢体重复的模型,留存下几何饱满的三维资产。
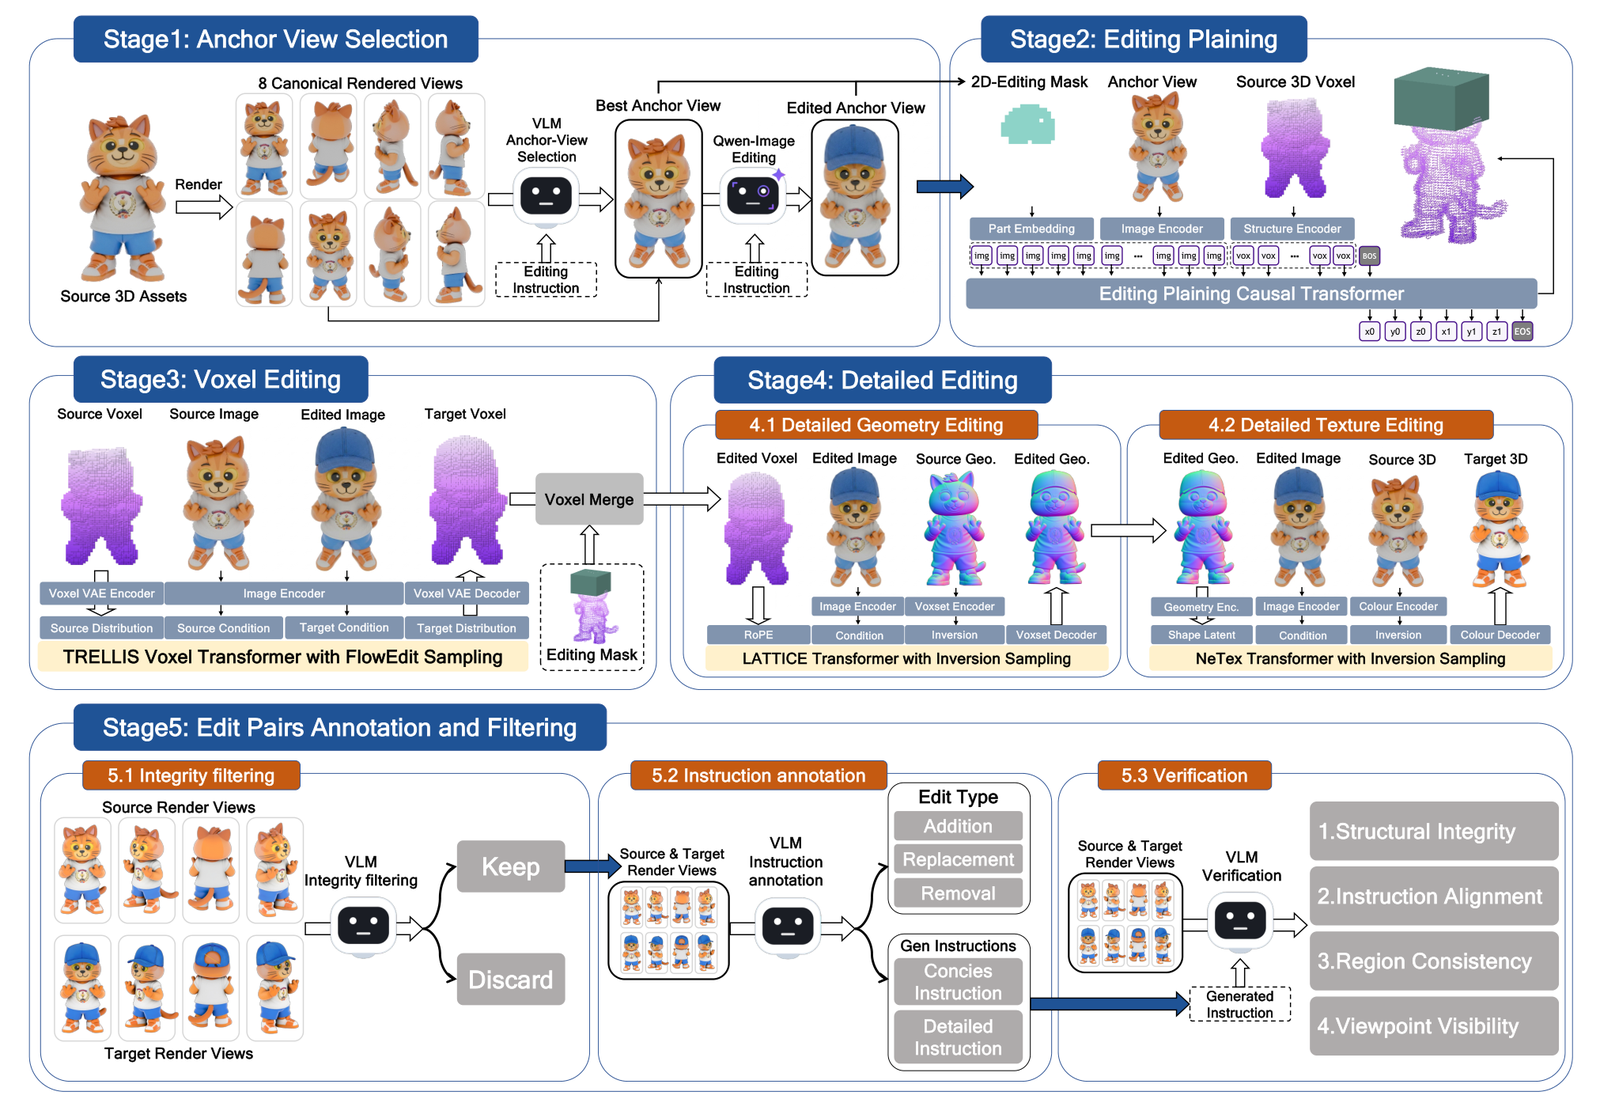
更为关键的飞跃在于 12M 编辑数据的合成。以往合成 3D 编辑数据最大的障碍是:修改了局部的同时,未修改的区域容易发生全局漂移。为此,团队研发了基于智能体的三维编辑数据生成管线 Nano3D-v2。该流程横跨五个精密控制阶段:
-
锚点视角选择与 2D 指令编辑:从源资产渲染出的 8 个正交视角中,利用视觉语言模型挑选出最能体现编辑意图的关键视角,并借助强大的图像编辑模型对该视角的投影进行 2D 修改,确立准确的二维视觉落脚点。
-
编辑规划与 3D 空间锁定:算法比对修改前后的 2D 像素差异形成掩码,接着驱动一个专门训练的自回归 Transformer,根据 2D 掩码和源体素预测出精准的 3D 空间三维边界框(3D Bounding Box)。该三维框充当了物理硬约束:框内体素允许发生流动变化,框外体素则被严格物理锁定。
-
体素级流动编辑与局部合并:以编辑后的锚点图像和三维框为条件,调用体素级 FlowEdit 实施局部变形,并在完成后将未编辑区域的体素强制替换为原始体素,根除全局身份漂移。
-
亚体素几何细化与无缝纹理补全:借助 LATTICE 架构在亚体素级别执行基于反演的网格修补,消除编辑边界处的拓扑破损与缝隙;同时利用纹理生成模型与边界处的空间 Alpha 混合,实现无痕材质过渡。
-
多视角严苛质检与反向标注:最后,通过多视角渲染对编辑后网格进行拓扑完整性校验,并利用 VLM 从几何事实出发,重新生成精确的指令式描述与结果判读。
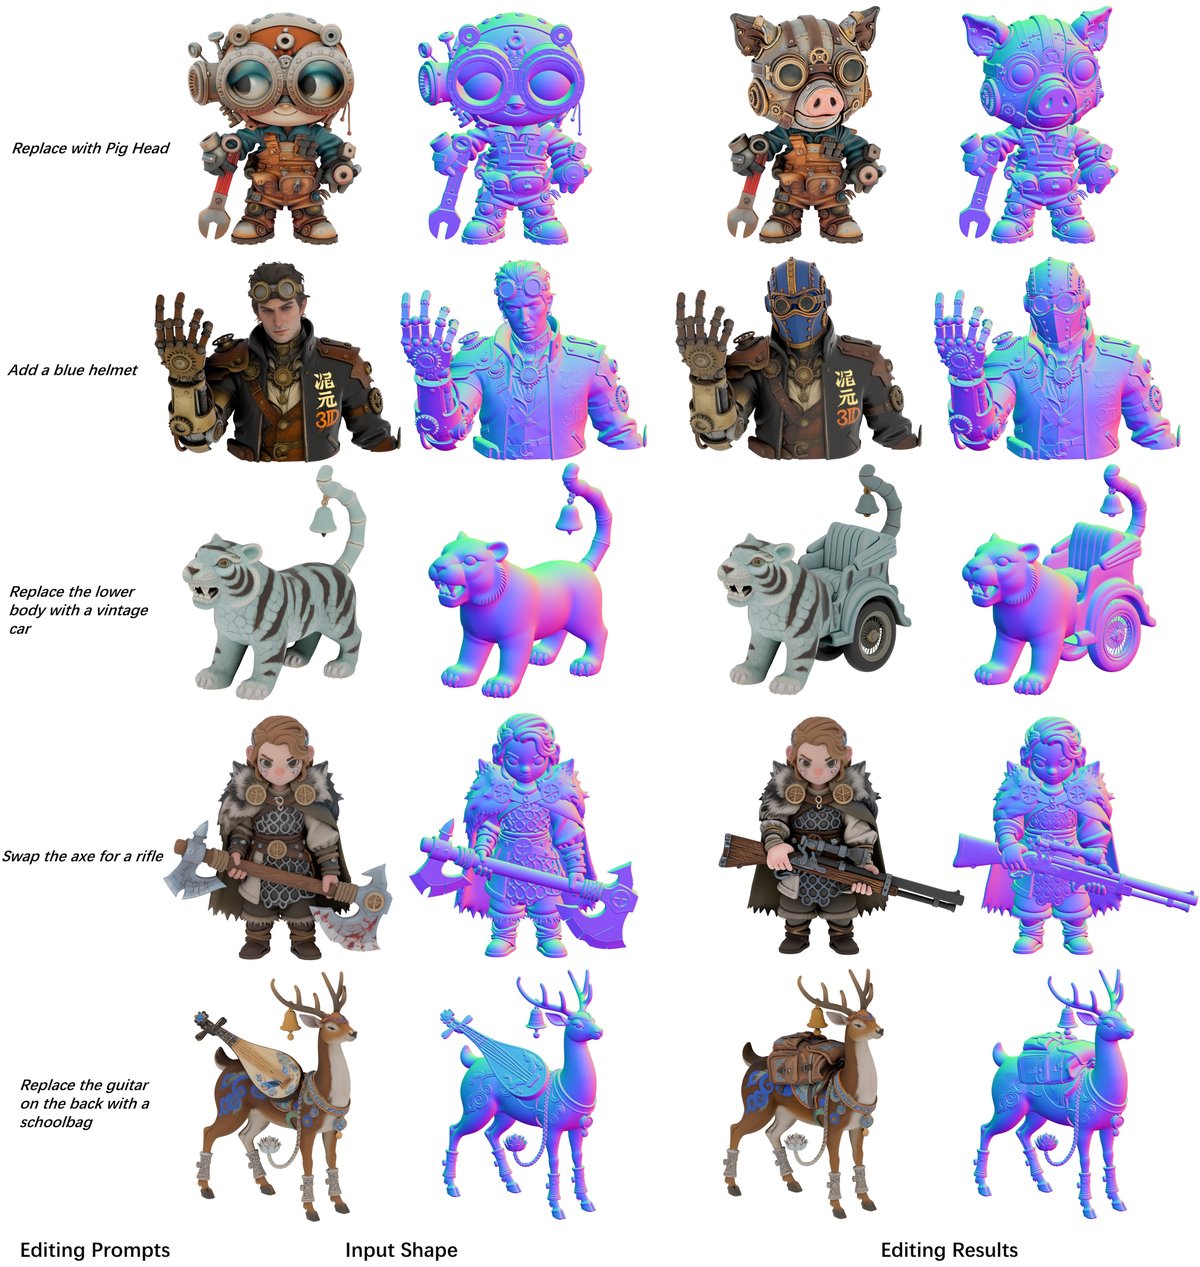
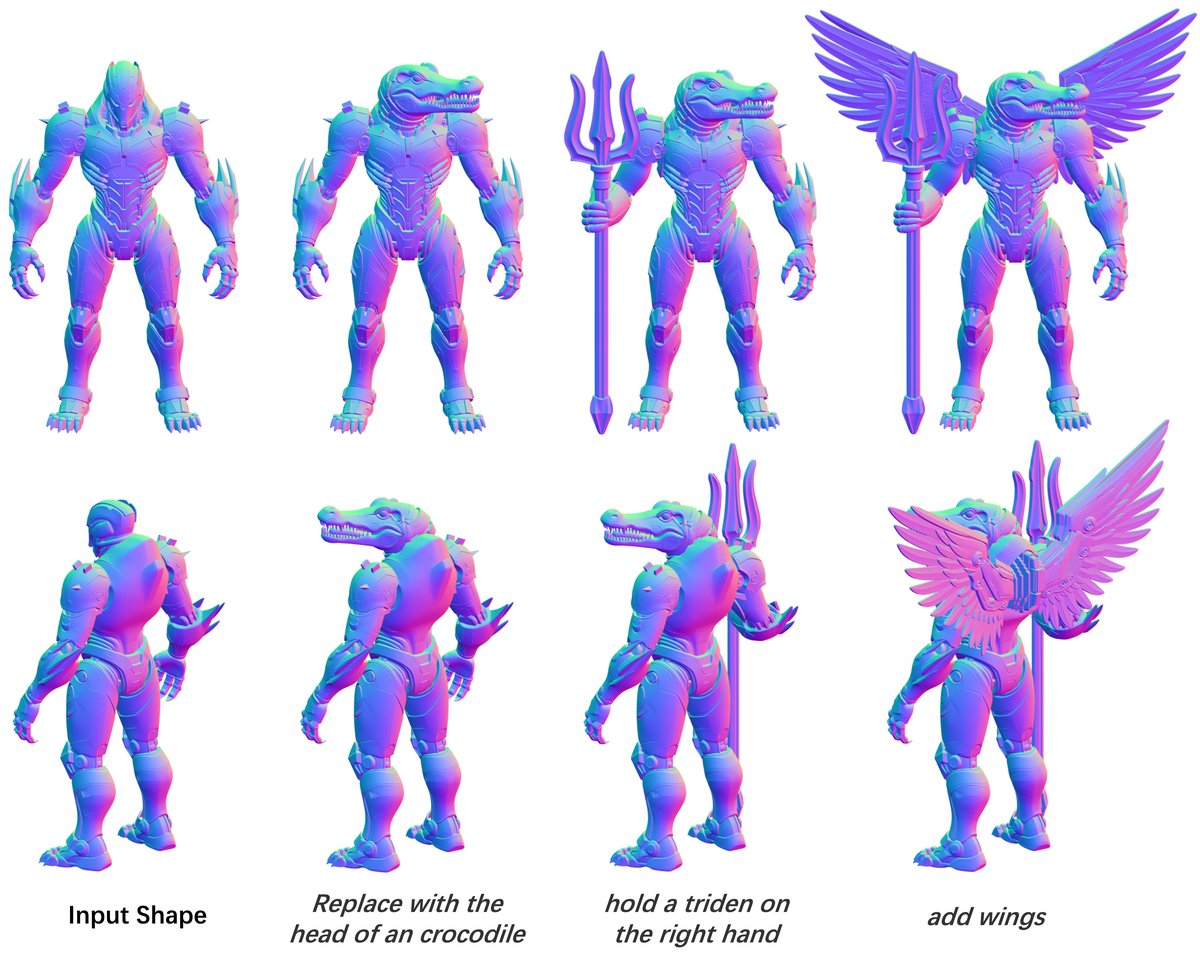
从最终生成的样本可以看出,无论是将独角兽的角变为树枝,还是在多轮交互中逐步给玩偶穿上衣服、替换头部配饰,Nano3D-v2 都做到了在精细刻画修改区域的同时,原始资产的几何细节未发生任何细微变形。
架构融合:Hunyuan3D-VLM 与扩散变换器的解耦共生
有了庞大的三维数据池,如何设计模型骨干成为下一个关键。在 2D 领域,部分工作尝试将图像全部离散化为 Token 并用纯自回归 Transformer 处理,但在 3D 领域,离散化 Token 往往意味着高频几何特征的灾难性丢失。
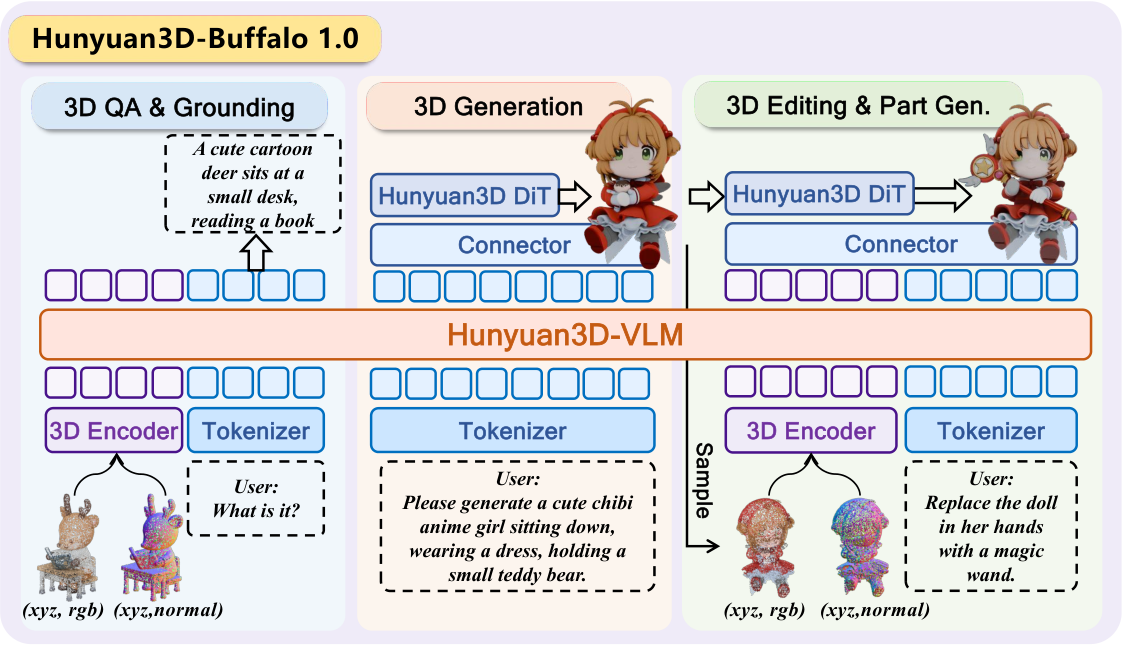
Hunyuan3D-Buffalo 1.0 采取了混合解耦架构:以专门构建的 Hunyuan3D-VLM 作为多模态语义与空间认知中枢,以基于 Hunyuan3D-2.1 初始化的 3D-DiT 作为底层高保真几何扩散生成器,二者通过轻量级的 MLP-Connector 形成条件联结。
为了赋予 VLM 真正的三维空间感知力,Hunyuan3D-VLM 对输入的点云资产采用了双通道编码策略。结构通道专门解析三维空间坐标 $XYZ$ 与表面法向量,捕获物体的宏观骨架、空间尺度与局部边缘;语义通道则编码点云的 RGB 颜色信息,用于区分几何形态相同但纹理相异的区域。双通道信息经由 VecSet 编码器提取特征后,再通过 Q-Former 压缩为长度仅为 512 的紧凑潜序列,能够极其丝滑地与文本、图像 Token 在大语言模型中穿插混合。
为了让系统能够胜任精细的空间定位(3D Grounding)和局部编辑指令解析,模型词表扩充了 133 个特殊的空间 Token。其中包含界定点云占位符的序列边界符,以及用于表示 3D 空间包围盒的离散坐标 Token,将连续的三维空间量化在 $[0, 127]$ 区间内。任何一个 3D 边界框都被编码为 6 个量化坐标并被专用边界符包裹。这意味着,诸如“指出机器人的左臂在哪个空间位置”“提取汽车后排的备胎”等任务,与常规的 3D 问答在自回归层面上被统一成同一种序列预测形式。
在生成与编辑阶段,Hunyuan3D-VLM 负责吃进复杂的图文与点云上下文,输出深层多模态隐藏状态,MLP-Connector 将其映射到扩散模型的条件嵌入空间。当执行编辑或部件级生成任务时,扩散模型不仅接收 VLM 的语义指导,还会引入源物体的潜空间特征来做 Cross-Attention 约束,从而确保非编辑区域在去噪生成过程中获得强力的结构锚定。
密集感知即生成:文本锚定部件的原生拆解
在传统 3D 流程中,生成可拆解、带有独立语义部件的模型(Part Generation)往往需要极其繁琐的外部几何切割算法或多阶段 2D 轮廓投影分割,不仅效率低下,而且对部件名称的词汇量有严格限制。
Hunyuan3D-Buffalo 1.0 吸收了 2D 领域将密集感知任务视作条件生成的先进理念,把 3D 部件拆解完全当作一种自然语言指令驱动的生成子任务。为了让模型学会理解并独立生成局部部件,研究团队构建了一套语义网格合并工具:
首先通过 VLM 观察资产的完整多视角渲染,推导出一套互斥且符合直觉的局部词汇表(如轮子、尾翼、把手、头部);随后在渲染图中用高亮标记单独的网格碎块,让 VLM 裁定碎块归属并组合为语言可寻址的“宏观部件”(Macro Parts);最后,对完整模型、单独抽离出的部件网格、以及剔除该部件后的残缺模型进行严格对齐与标准化,打包为三元组训练对。
当用户输入“将该载具的轮子单独分离生成”或者“移除椅子的靠背”时,Hunyuan3D-Buffalo 1.0 不再依赖外部布尔运算或第三方几何工具,而是直接由 3D-DiT 在统一潜空间中将目标部件的网格结构条件合成出来。这种将空间感知与内容生成彻底融为一体的机制,使模型在处理资产层级结构时具备了原生支持。
双向增强:统一三维多模态训练的协同律
评测指标证实了 Hunyuan3D-Buffalo 1.0 的全面实力:在各类公开的文本生成 3D 和 3D 指令编辑测试集上,该模型在几何忠实度、多视角外观一致性与指令遵循能力上均处于行业领先水准。然而,相比单纯的基准跑分,该论文更具理论价值的贡献在于揭示了 3D 跨任务训练中客观存在的协同互补效应。
长久以来,多任务训练常常伴随着“能力竞争与遗忘”的担忧,即同时学习理解和生成会导致单一性能下滑。但团队的消融分析明确指出了两条正向迁移规律:
第一,生成能力越强,编辑质量越高。在 3D 编辑场景下,模型面临的本质挑战是“如何在原模型被挖空或变形的区域,凭空生成出符合全局空间逻辑的新几何体”。消融结果表明,在冻结或削弱生成骨干预训练先验的对照组中,编辑后的网格在修改交界处频繁出现断裂与空洞;而引入更强大、多样的生成数据后,编辑模块借用了更完整的生成先验,补全出的新网格过渡自然、拓扑完整。
第二,空间理解能力越深,局部编辑控制越精准。在缺乏细粒度 3D 空间理解能力的消融版本中,模型虽然能执行编辑指令,但经常破坏指令范围之外的结构——例如指令要求“为角色戴上一顶帽子”,模型往往连带把角色的发型甚至面部五官全部重新生成一遍。而得益于 Hunyuan3D-VLM 具备对 3D 边界框的离散预测能力与细粒度外观结构感知,完整的 Hunyuan3D-Buffalo 1.0 能够精确隔离出必须被修改的三维体素范围,从而把“未编辑区域保留度”提升到了极高水准。
这种协同效应确凿地证明,3D 领域的“理解、生成、编辑”不仅不应该割裂,而且在底层数据对齐的前提下,三者能够通过共享的潜空间实现正反馈。
走向三维通用智能基础设施
Hunyuan3D-Buffalo 1.0 的发布标志着 3D 内容创作领域正在经历与二维视觉相同的架构重组。以往在游戏工业、虚拟现实和三维动画管线中,资产从初步概念生成到局部微调、从整体拓扑构建到部件级拆解,需要穿梭在数个互不兼容的软件与专用小模型之间,不仅协作链路极其冗长,而且每一次跨软件转换都会丢失中间语义与精度。
通过构建 87M 规模的高质量几何对齐语料库,并打通 VLM 与 DiT 之间的结构与语义鸿沟,这项工作证明了在单一模型内部闭环完成“看懂 3D、无中生有创造 3D、随心所欲修改 3D、细致入微拆解 3D”的可行性。它不仅为三维工业生产提供了一个高可控、高保真的一体化模型范式,更为未来三维具身智能在复杂物理世界中的几何感知与交互重建,奠定了一个扎实的通用三维多模态底座。