不用微调模型,就能超越微调基线11%?GuideSkill让临床指南变成可执行技能库
GuideSkill: Evolving Executable LLM Agent Skills for Guideline-Grounded Clinical Reasoning
让大语言模型(LLM)做临床鉴别诊断,最常见的做法无非两种:要么在提示词里检索塞入临床实践指南(Clinical Practice Guidelines, CPGs),也就是标准的 RAG 方案;要么收集大量医学文献和病例,对模型进行全参或指令微调。然而在实际临床场景中,这两种方式都显得有些“力不从心”。RAG 只是把文本堆砌在上下文窗口里,模型很容易在长文本中漏掉核心排他条件或关键阈值;参数微调不仅计算昂贵,而且知识一旦注入权重,具体的临床决策规则便无法被医生直观审核和修改。更严重的是,真实世界中的临床指南数量有限,单纯依赖指南文本库,根本无法覆盖复杂的罕见病或非典型病例。
ArXiv URL:https://arxiv.org/abs/2607.26160v1
来自阿尔伯特·爱因斯坦医学院、香港中文大学(深圳)以及伊利诺伊大学厄巴纳-香槟分校的研究团队提出了一种全新解法:GuideSkill。他们没有选择继续“卷微调”或“堆检索”,而是构建了一个模型外部的解耦推理层,将死板的临床指南文本“编译”成结构化的可执行技能(Executable Skills),并允许通过病例进一步自动化进化。
实验数据给出了相当扎实的证明:无需修改任何底层模型参数,初始化版本 GuideSkill-Zero 就在四项基准上让平均准确率比传统指南 RAG 高出 13.45%;进一步通过病例进化后的 GuideSkill-Evo,相比直接推理取得 18.49% 的相对增益,甚至在 9B 参数的开源模型上直接跨越微调与强化学习基线 11.16%。
从“阅读指南”到“代码化执行”
临床诊断本质上是一个高度严密、分步验证的多级推理任务。医生看病绝不仅是知识联想,而是需要先提出一组成型的鉴别诊断候选名单,随后针对每一个怀疑的疾病,逐一核对症状、体征、检验检查数据是否吻合,并利用关键阴性结果排除干扰项。
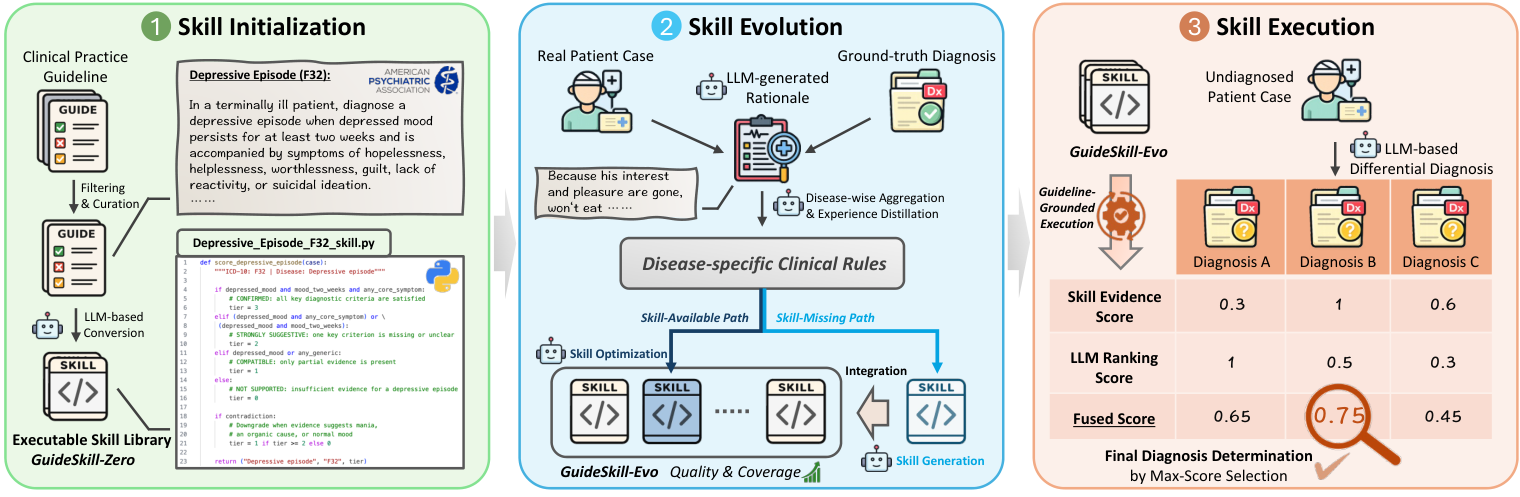
GuideSkill 的核心思想是让模型专心做它擅长的发散性生成,让可执行的程序负责决定性的规则校验。系统整体被清晰地划分为三个阶段:技能初始化、病例驱动进化、以及测试期协同执行。
在初始阶段,系统打造了名为 GuideSkill-Zero 的技能库。团队收集并筛选了权威的临床实践指南,利用能力较强的大模型将每一篇指南中的核心条目编译成以疾病为索引的可执行评测函数 $g_d^{(0)}$。这些函数并不输出模糊的自然语言描述,而是强制返回确定性的四级序数支持分级:确诊(Confirmed)、高度提示(Strongly Suggestive)、符合(Compatible)以及不支持(Not Supported)。每个技能内还严格内嵌了矛盾证据与排除规则,一旦触发排除项便自动降级评分。
但静态指南存在天然边界:指南往往只覆盖常见、典型的疾病大类,而在急诊或复杂的住院病案中,有相当一部分属于指南未覆盖的病种,亦或是伴随严重非典型表现。
为此,研究引入了 GuideSkill-Evo。该机制利用带标注的真实临床病例 $(x_j, d_j)$,让模型自发提炼实际病例中的特征模式。如果该疾病已经在现有技能库中,算法会利用增量信息更新现有规则库,提升对非典型症状的容忍度与精准度;如果该疾病在初始指南库中完全缺席,算法则会根据病例特征自动生成全新的疾病判别技能。这一步让标准黄金标签对应的技能覆盖率直接从最初的 56.50% 跃升至 99.50%,彻底填补了指南库的知识盲区。
推理时双轨协同与打分融合
到了实际测试推理阶段,GuideSkill 并不会用技能库完全锁死模型的思维,而是设计了一种兼顾开放性与严谨性的双轨架构。
面对一份未知的长篇病历 $x$,基础 LLM 首先生成一个排序后的鉴别诊断候选集 $\mathcal{C}(x)={d_1, \dots, d_K}$。这一步保留了大模型应对罕见病和开创性思维的能力。候选疾病确定后,系统依据标准的三位 ICD-10 编码在外部技能库 $\mathcal{G}^{\mathrm{Evo}}$ 中检索对应的可执行规则。
随后,模型执行特征锚定(Feature Grounding),从原始病历中提取出该疾病技能所需要的临床变量 $\phi_{d_i}(x)$,并喂给该技能执行打分,得到客观支持度得分 $s_{\mathrm{skill}}(x, d_i)$。与此同时,候选名单中的初始生成位次也会转化为基础排序得分:
\[s_{\mathrm{LLM}}(x, d_i) = \frac{1}{\mathrm{rank}_i + 1}\]最终,两者通过一个动态权重系数 $\alpha \in [0, 1]$ 融合为最终决策得分:
\[s_{\mathrm{fuse}}(x, d_i) = \alpha s_{\mathrm{LLM}}(x, d_i) + (1 - \alpha) s_{\mathrm{skill}}(x, d_i)\]取融合得分最高者作为最终输出。这种设计不仅巧妙保留了基础大模型宽阔的临床直觉,还强行借助外部可审计的规则层,把那些经常被模型幻觉忽略的阴性指标和核心检验阈值变成了实打实的打分防线。
四大基准跨模型全线验证
为了全面检验该框架的泛化能力,研究团队在四个异质性极强的医学鉴别诊断基准上展开了对比评测:MedCaseReasoning(医学病例长文本推断)、ER-Reason(急诊室序贯推理)、MIMIC-CDM-FI(真实重症监护急性腹痛全信息诊断)以及 MedThink-Bench(多步医疗问答)。值得注意的是,MedThink-Bench 在技能进化阶段被完全隔离,以此严格考察技能库在零样本未见基准上的跨场景迁移能力。
在测试底座上,作者横跨了闭源顶级模型(GPT-5.4、Claude-Sonnet-4.6)与开源领域/通用模型(MedGemma-27B、Qwen3.5-9B),以验证机制的通用性。
实验结果展现了极其一致的规律。在所有模型底座上,GuideSkill-Zero 的宏平均准确率均稳定超越传统的检索增强生成(Guideline RAG),平均相对提升 13.45%。而经过病例进化的 GuideSkill-Evo 则在全部 16 组“模型-数据集”对比中拿下最高分,平均准确率相较模型直接推理提升 18.49%。在最具代表性的前沿模型上,GPT-5.4 的宏平均准确率达到了 56.97%,Claude-Sonnet-4.6 达到 56.64%,分别将最强基线提升了 6.98 和 8.39 个百分点。
更具启发意义的对比发生在开源模型 Qwen3.5-9B 上。研究人员对比了包括指南全参微调、病例全参微调、基于病例的强化学习(RL)、以及“微调+RL”级联等一系列昂贵的权重更新方案。
结果令人惊讶:未经任何参数修改的 GuideSkill-Evo,以 50.98% 的宏平均准确率遥遥领先于所有参数微调和强化学习基线,比最强的微调基准高出 5.12 个百分点(相对提升达 11.16%)。即便是未经病例进化的零样本初始版本 GuideSkill-Zero(46.38%),也足以击败绝大多数参数优化方案。这说明,在高度依赖逻辑排查与规则比对的临床场景中,通过外部代码将指南逻辑结构化,远比盲目让网络拟合语料更能触及诊断的本质。
为什么必须是“可执行”的规则?
一个很自然的疑问是:为什么一定要将指南编译成可执行的代码函数,如果让大模型拿着结构化的文本评分量表直接去打分,效果会有区别吗?
消融实验给出了直观解答。研究人员对比了“可执行技能”与“纯文本评分标准”两种形态。在同样的候选集和参数下,虽然两者的单次平均准确率非常接近(60.94% 对比 60.60%),但文本形式在大模型的多轮评估中存在显著的随机扰动与方差。而可执行技能一旦完成特征落地提取,后续规则计算与分级打分完全由代码逻辑 deterministic 执行,在连续 5 次独立评测中实现了 0 方差波动。在医疗场景下,这种绝对的可重复性与确定性,正是算法落地最需要的信任基石。
此外,进化机制并未破坏指南原有的专业性。根据执业医师进行的盲法评估,在涵盖 42 条初始规则、100 例进化病例与 120 条最终规则的质检中,生成的规则在临床合理性与条目完备性上均获得了专业医生的高度认可。而在错误根因分析中,研究者发现当前 GuideSkill-Evo 出现的失误中,有 60.9% 源于基础 LLM 在第一阶段生成鉴别诊断名单时完全漏掉了正确疾病代码(Candidate Recall 失败)。这意味着,外部技能执行层的精确度其实非常高,整个系统的上限目前很大程度上受制于大模型的第一轮联想召回。
将医学指南转化为独立于模型权重的可执行知识资产,不仅打破了闭源大模型无法微调的限制,也让医生群体参与算法审查成为了可能——每一行编译出来的判别函数、每一个排他阈值,都是可以直接阅读、编辑和动态修正的。这种外置技能层的架构思路,或许正为大模型在严肃专业领域的可靠落地指出了一条更加明朗的演进路径。