COVE:不是所有经验都需微调!记忆参数协同让训练Token缩减86%
Learning What to Remember and What to Internalize in LLM Self-Evolution via Adaptive Memory-Parameter Coordination
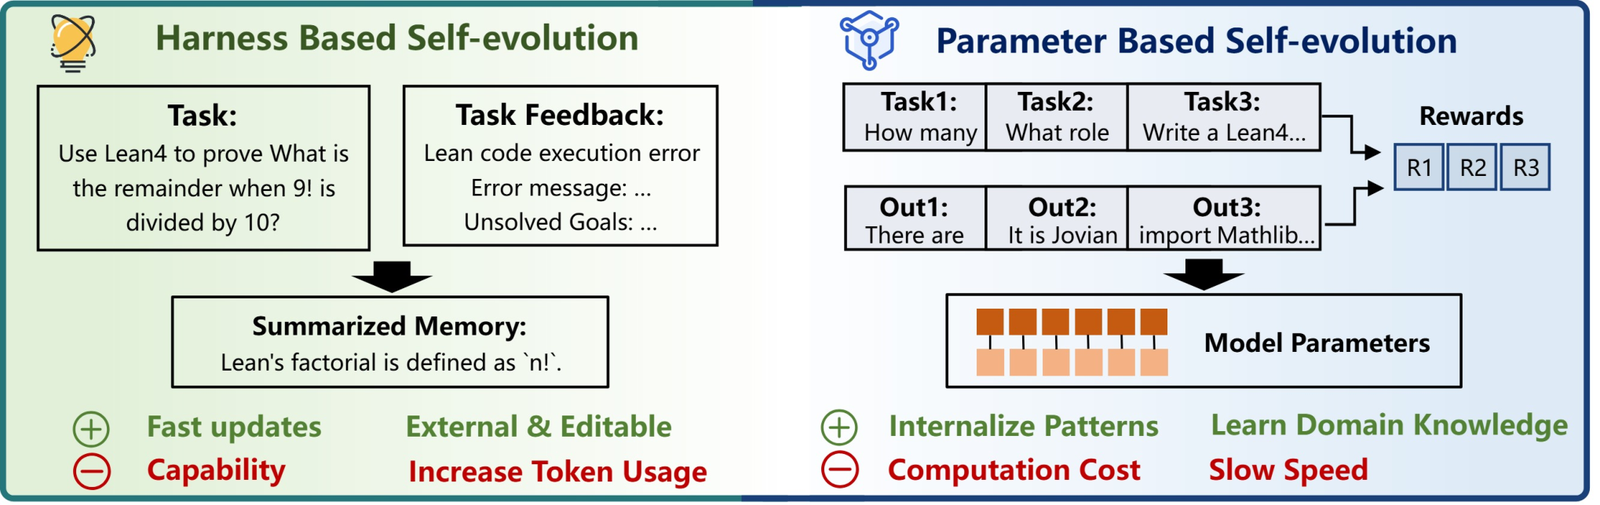
大模型智能体一旦投入实际生产环境,最让人头疼的问题莫过于外部世界的“不可预测”。今天调用的工具 API 更改了字段名,明天数据库结构进行了重构,后天业务规范又多出了几条硬性限制。为了让智能体具备持续适应环境的能力,“自进化(Self-Evolution)”正成为近期大模型系统研究的热点。然而,现有的自进化路线往往走向两个截然不同的极端:一种是外挂记忆派(Harness-based),把所有踩坑经验、交互反馈写成自然语言笔记或可执行技能,存入向量数据库,推理时再检索拼接到 Prompt 中;另一种是参数内化派(Parameter-based),收集模型与环境交互的轨迹,通过监督微调(SFT)或强化学习(RL)硬生生把经验刷进模型权重里。
ArXiv URL:https://arxiv.org/abs/2608.01234
这两条路线单拎出来都有致命缺陷。外挂记忆极其灵活、改动几乎零成本,但如果基座模型的底层逻辑能力不足,面对复杂的多步定理证明或长链路代码生成,检索再多条记忆也是“废纸一张”;参数内化能够强化深层的推理直觉,但它的更新成本极为高昂,更严重的是,模型一旦把易变的外部环境特征(例如具体的 API 命名、临时接口参数)死记硬背进参数里,只要外部稍有变动,模型的性能就会断崖式崩塌。
针对这一核心矛盾,最新研究提出了名为 COVE(Channel Orchestrated Volatility-aware Evolution,通道编排与易变性感知自进化)的全新框架。该工作不再将自进化视为盲目的经验堆叠或粗暴的权重微调,而是建立了一套统一的自适应协同机制:通过任务感知路由、阶段感知调度与双模知识优化(KnowledgePO),自主决策哪些知识该作为外置记忆动态维护,哪些规律必须内化进模型参数。实验结果显示,COVE 不仅在 Lean4 定理证明、APPS 编程、HotpotQA 等复杂任务上全面超越单通道自进化基线,更将参数更新所需的训练 Token 消耗大幅削减了 86%;在外部接口剧烈变动时,它成功遏制了模型的“死记硬背”,展现出极高的演化鲁棒性。
经验的错配:记忆与参数各有哪些死穴?
为了理清自进化的边界,研究人员首先设计了极具诊断价值的对照实验。第一项诊断是在 MiniF2F 数据集上进行 Lean 形式化定理证明。形式化证明对符号逻辑与战术推导(Tactics)有着极高的硬性要求。实验发现,如果我们只依靠外挂记忆系统,不断把交互中的报错和经验总结注入上下文,哪怕检索的记忆数量从 2 条激增到 8 条,证明成功率的提升依然不足 3%。
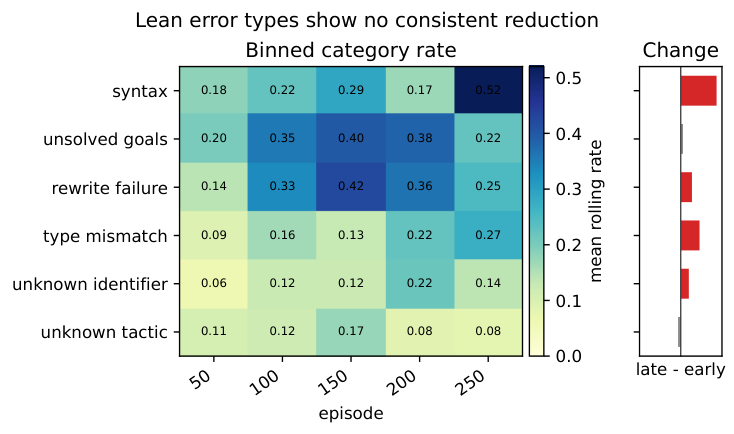
深入分析 Lean 定理证明中的错误类型可以发现,模型犯错的大头集中在基础语法违规、战术参数不匹配以及无效的状态转换上。这些本质上是底层参数缺乏对形式化逻辑系统的内生掌握。底座模型如果连 Lean 的基础语法直觉都没有,外挂记忆给出的提示再丰富,模型也无法在推理步骤中正确落实。这表明:深层次的、跨场景高度通用的逻辑范式与语法直觉,必须通过参数更新内化为本能。
然而,走向完全依赖参数更新的另一个极端,灾难来得更快。在针对 WikiTableQuestions 的接口更名诊断中,模型先通过微调学习了表格操作的专用 API 调用模式。当接口处于稳定状态时,直接微调的模型 API 调用准确率高达 96.50%;但当研究人员轻微改动了底层 API 的命名规范,并在 Prompt 中明确给出了新接口文档时,纯微调模型的调用准确率瞬间暴跌至 54.00%。模型固执地输出它在训练集里被“刷进参数”的旧接口名称,彻底无视了上下文中的最新说明。
这项对照揭示了智能体自进化中最关键的一个分水岭——知识的易变性(Volatility)。
-
高易变性知识(Volatile Knowledge):如 API 签名、库版本变迁、数据库 Schema、临时业务规则。这类信息更新快、表层化,应该留在外挂记忆或上下文中,随用随改。
-
低易变性知识(Stable / Strategic Knowledge):如通用的解题策略、数学推导规范、纠错反思模式。这类经验持久且普适,才配被内化进权重。
COVE 框架:让模型学会“该记什么、该背什么”
明确了知识属性与演化痛点后,COVE 构建了一个由三道工序构成的自适应闭环系统:
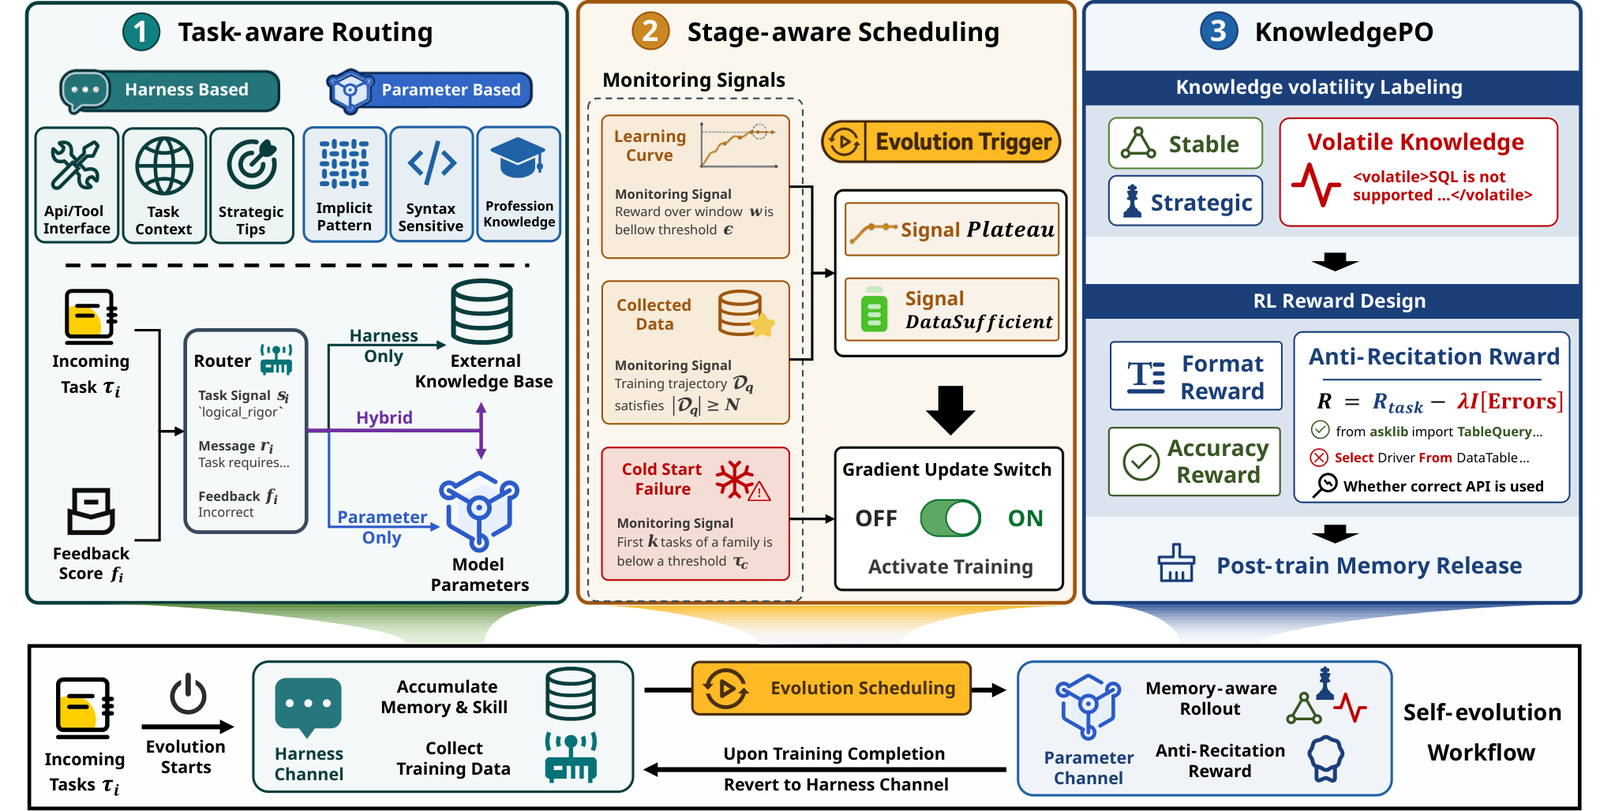
1. 任务感知路由(Task-aware Router)
传统的自进化策略通常对所有样本一视同仁,要么全走 RAG,要么攒够一批全拿去微调。COVE 则在任务执行完毕、拿到环境反馈 $f_i$ 后,首先进行细粒度归因,将任务分流到三种候选模式:
-
harness_only:如果任务失败主要源于短期上下文理解偏差,或者涉及高度易变的外部接口信息,直接将其沉淀为外挂记忆或技能卡片,坚决不碰模型权重。 -
parametric_candidate:如果失败反映出模型缺乏稳定的底层推理能力(例如数学推导逻辑硬伤、形式化语法缺失),这种能力很难靠一两句 Prompt 纠正,该样本将被标记并送入参数更新候选池。 -
hybrid:针对既包含复杂形式化推理、又重度依赖外部工具检索的高难度任务,系统激活双通道协同演化。
2. 阶段感知调度(Stage-aware Scheduler)
有了候选池,究竟什么时候该停下来微调参数?过去的方法要么每隔固定步数训一次,要么始终不训。COVE 认为,参数更新应当由智能体的学习阶段信号自适应触发。调度器定义了三个逻辑触发条件:
\[\textsc{Trigger} = \textsc{Plateau} \lor \textsc{DataSufficient} \lor \textsc{ColdStartFailure}\]-
平台期($\textsc{Plateau}$):当外挂记忆带来的性能增益达到上限,胜率不再上升时,说明外置手段已触及天花板,必须通过微调打开底层能力的瓶颈。
-
数据充分性($\textsc{DataSufficient}$):积累的高质量特定类型轨迹已达到统计意义上的训练门槛,可以高效跑一次批量参数更新。
-
冷启动失败($\textsc{ColdStartFailure}$):基座模型在某些严苛领域(如形式化定理证明)连一条合格的轨迹都跑不出来。此时外挂记忆无从谈起,必须先进行一轮小规模参数内化,为模型建立“能力底座”,之后才能激活记忆探索。
3. KnowledgePO:双模知识优化与反背诵机制
当参数更新与外挂记忆联动时,最棘手的问题是:如何防止微调过程把外挂记忆里的“易变脏数据”一起死记硬背下来?同时,参数更新完成后,旧的外挂记忆该如何处理?
KnowledgePO 在微调生成数据时,为每一条外置记忆自动打上 volatile(易变)或 stable(稳定)标签。在训练目标中,引入了特殊的反背诵(Anti-Recitation)惩罚:
如果模型在解题时,不去阅读当前 Prompt 里的最新易变定义,而是直接默写训练轨迹里的历史接口名,就会受到严厉的奖励扣减。这一机制迫使模型在权重层面学到的不是“固定的接口名词”,而是“根据当前上下文动态绑定接口”的高阶策略。
另一方面,随着参数微调的完成,许多原本需要放在外挂记忆里的知识已经被模型内化为本能。如果知识库只增不减,推理上下文会越来越长,检索噪声也会成倍放大。COVE 引入了记忆释放(Memory Release)评估:通过对保留集进行 A/B 测试,一旦发现移除某条稳定记忆后,模型在未检索该记忆的情况下的表现分差 $\Delta_j$ 小于设定阈值,系统就会将该条目从在线记忆库中果断剥离,确保外置知识库始终处于轻量、敏捷的状态。
实验印证:性能更稳,还省下了 86% 的训练开销
实验基于 Qwen3-8B 展开,在 Lean4、APPS(编程代码)、HotpotQA(多跳问答)、MATH(复杂数学推理)以及 TableQA(表格问答)五大基准上全面对比了 COVE 与纯记忆更新(Harness-only)、纯参数更新(Parametric-only)及强基线系统(如 Self-Challenging Agent)。
最引人注目的首先是资源消耗的骤降。以往为了追求自进化性能,研究者往往无休止地收集轨迹进行全量微调。COVE 由于拥有精准的路由与阶段调度,仅花费了纯参数微调方案 14% 的训练 Token(整体消耗降低 86%),就在全部评估基准上取得了持平甚至更高的综合成功率。
而在真正考验系统协同能力的 hybrid 难例子集上,COVE 的优势展现得淋漓尽致:该子集包含那些既需要工具调用、又需要严谨多步推导的硬核任务。在该子集上,基座模型的成功率仅为 15.6%,纯参数微调方案为 21.3%,而 COVE 一举攀升到了 24.1%。这直接证明了双通道不是简单的“各司其职”,而是形成了真正的正向互补。
对于路由器行为的深度分析还揭示了一个反直觉的有趣现象:在 MATH 数学任务中,路由系统出人意料地将大部分样本分流给了外挂记忆通道,而不是直接送去参数微调。这是因为 Qwen3-8B 作为基座,其本身的数学底座已经相当扎实,许多错题在推理时只需外挂反思提示就能修正,如果强行把这批样本塞进微调队列,只会白白耗费算力。相反,在 TableQA 任务中,由于操作模式重复且具有普适规律,参数通道获得了最大比例的分流;但系统依然精细地把具体的表头字段、Schema 定义保留在记忆端,防止参数过拟合。
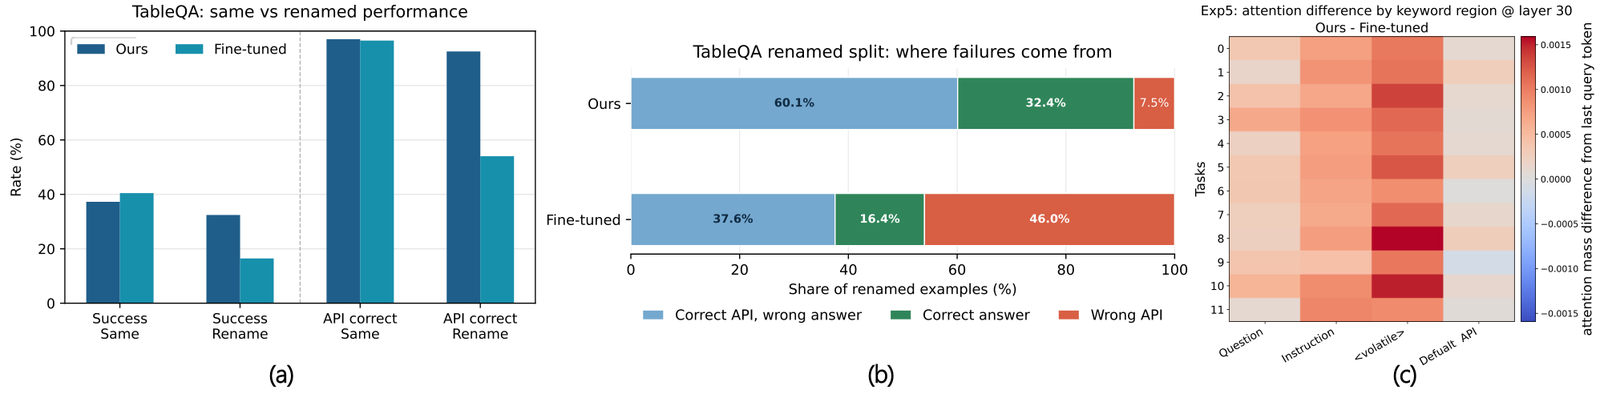
而在最为关键的 API 接口更名鲁棒性测试中,引入反背诵机制的 COVE 展现出了压倒性的适应力。如上图所示,当接口名称被临时篡改时,常规微调模型依然在执着地输出训练集中死记硬背的遗留 SQL 语法;而 COVE 模型的注意力权重分布发生了极其清晰的迁移:
在注意力差异热力图(图 7c)中,模型在 <volatile> 标记以及当前指令区域(Instruction Region)的注意力权重显著加深,而在默认旧 API 区域的注意力则被大幅压制。这有力地证实了设计初衷:模型通过强化学习,真正习得了“识别易变信号、优先服从当前指令”的行为本能,而不是机械地重复记忆片段。
从“死记硬背”走向“知进退”的自进化
在大模型落地的早期,业内对 Agent 自进化的理解往往存在某种机械论的偏向:要么迷信“外挂万物”,以为做一个无限扩容的向量库加上几套反思 Prompt 就能解决一切长尾任务;要么沉迷“暴力微调”,把线上收集到的每一次交互日记不论良莠统统拿去 SFT。
COVE 这项研究给出的最核心启发在于:健康的智能体自进化,本质上是一场关于“信息持久度与存储介质”的精准资源调配。
大模型参数就像人类大脑皮层的深层连接,极其珍贵、重构成本高昂,它应当用来雕刻深层的语法秩序、逻辑范式与指令服从元能力;而上下文窗口与外部向量存储,则如同人类的工作记忆与备忘录,随时准备记录易逝的表层信息,并在接口变动或信息过期时随时擦除。当大模型智能体学会了“什么该记在脑子里,什么该记在纸上”,它才算真正迈出了走向成熟数字员工的关键一步。