Beacon:让多模态大模型学会“看题用工具”,在13个基准上实现真收益
Beacon: Knowing When and How to Perform Agentic Visual Reasoning
在多模态大模型(MLLM)领域,为模型装上 Python 解释器、图像裁剪或放大等“外挂工具”来执行智能体视觉推理(Agentic Visual Reasoning),已然成为前沿研究的标配路线。很多人自然而然地假设:能调工具的模型,推理能力一定强于单纯“肉眼硬看”的纯文本模型。
ArXiv URL:https://arxiv.org/abs/2607.28595
然而,多模态智能体在真正执行任务时,往往陷入一种尴尬境地:在简单题上,模型频繁滥用工具,因裁剪偏离或代码微小 bug 导致原本能做对的题被白白做错;在真正困难的题上,哪怕调了工具,模型依然缺乏有效的求解策略,盲目试探后仍以失败告终。两相抵消,工具调用带来的收益几乎被其引发的副作用完全抹平。
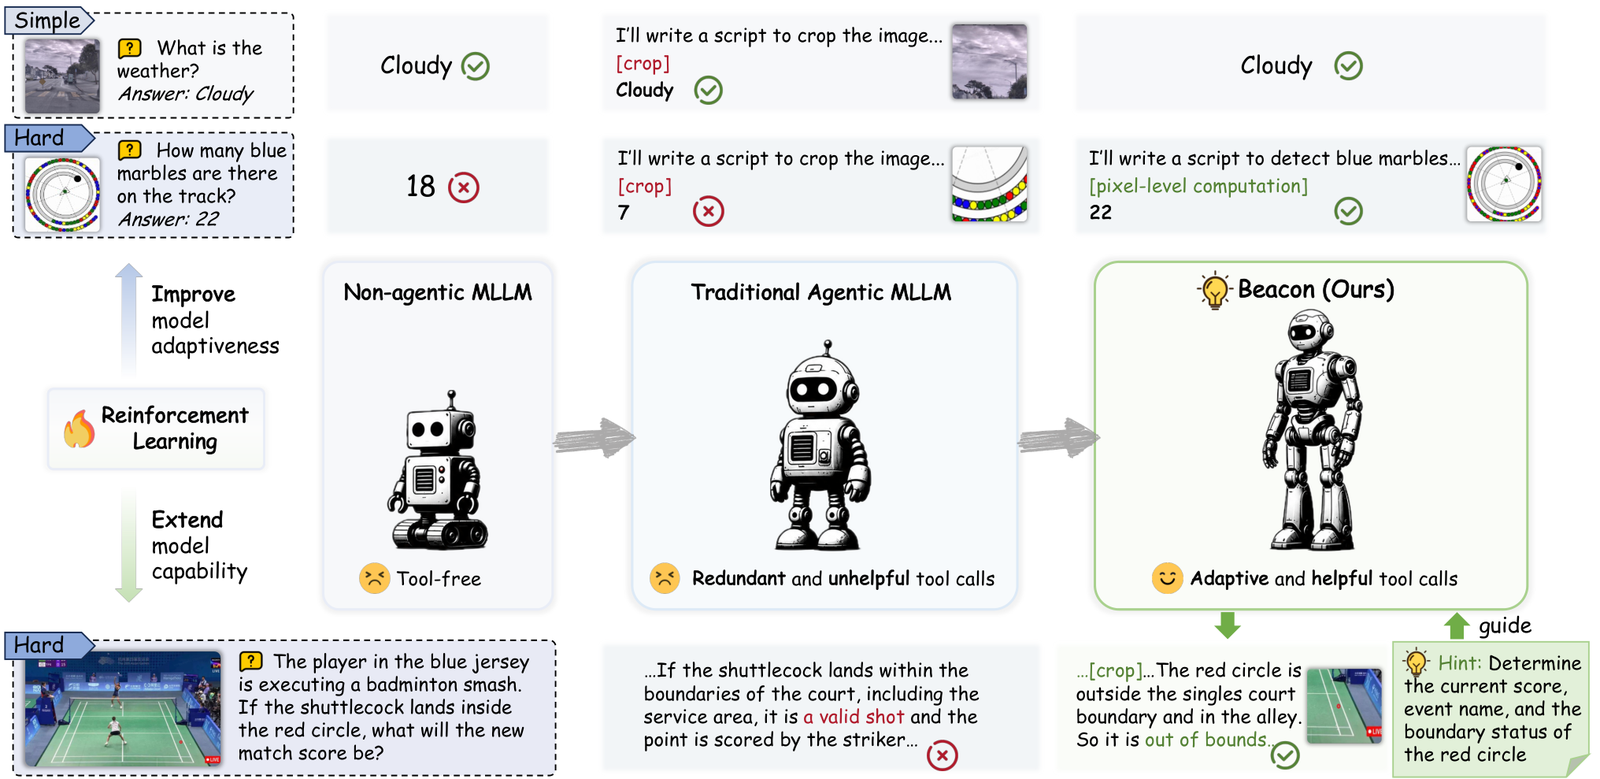
针对这一核心痛点,最新研究提出了多模态推理模型 Beacon。该研究不仅系统性量化了智能体调用工具的“自适应性”与“真实净收益”,更通过一套包含“必要性感知自适应奖励”与“提示引导能力拓展”的强化学习框架,彻底改变了智能体盲目调用外挂的现状。在涵盖高分辨率视觉搜索、空间几何与图表推理的 13 个主流基准测试中,Beacon 实现了行业领先的综合性能,首次让多模态工具调用展现出显著的真实能力扩展。
繁荣背后的虚妄:外挂工具真的带来收益了吗?
为了看清现有视觉智能体调工具的真实成色,研究团队提出了两个核心评估维度:模式自适应性(Mode Adaptiveness, MA)与工具效应(Tool Effect, TE)。
所谓模式自适应性,衡量的是模型能否根据题目难易度自主抉择推理模式。如果一道视觉题仅靠纯文本推理就能稳定做对(即“纯文本简单样本” $\mathcal{E}$),模型理应避免调用外部工具以节省开销;反之,当纯文本推理屡屡失败(即“纯文本困难样本” $\mathcal{H}$)时,模型则必须果断呼叫代码执行。研究团队将其细化为在简单题上抑制调用的 $\text{MA}_{\text{text}}$,以及在难题上主动调用的 $\text{MA}_{\text{tool}}$。
而工具效应则进一步击穿了准确率的表象:
-
工具增益(Tool-Gain):原本仅靠纯文本答不对的难题,在工具辅助下成功解出的比例;
-
工具损害(Tool-Harm):原本纯文本完全能答对的简单题,却因调用工具而意外翻车的比例。
通过对 Thyme、DeepEyesV2、CodeV 以及 Metis 等代表性模型的全面摸底,一系列令人警醒的现象浮出水面:
第一,绝大多数现有模型在允许调用工具(Tool-Available)时的平均表现,相比强制纯文本推理(Tool-Free)几乎没有实质性提升。第二,现有模型的模式自适应性极低。如果一个模型不管遇到什么题都无脑调用工具,或者自始至终不用工具,其平均自适应得分刚好是 50%;实测表明,很多开源智能体的平均表现甚至徘徊在 50% 基准线附近。它们往往形成严重的策略偏置——要么极度迷信工具,哪怕数个简单的像素块也要调 Python;要么极度抗拒工具,面对极度复杂的微小目标依然选择硬猜。
第三,也是最致命的一点:工具调用带来的 Tool-Gain 与 Tool-Harm 基本处于同一量级。换句话说,模型在困难样本上靠工具抢回来的分数,转头就被在简单样本上“画蛇添足”引入的失误全部抵消,纯粹是“高成本的无效折腾”。
究其根源,现有的强化学习对齐(如 RLVR)通常缺乏对“必要性”的明确引导,同时受限于自身预训练分布,模型在面对真正超出当前能力范围的困难题时,往往无法通过有限的自主探索生成有效的使用轨迹。
Beacon 的破解之道:自适应奖励与提示外援
Beacon 的目标非常明确:既要让模型知道什么时候该调工具,又要确保真正调工具时能把硬骨头啃下来。整个技术方案以 Qwen3-VL-8B-Instruct 为基座,分为两阶段系统构建。
首先是高质量的冷启动监督微调(SFT)。团队从 16 个涵盖感知、OCR、几何、图表的高难度基准中筛选出基座模型多次尝试均做错的困难样本,借助 Gemini 3.1 Pro 生成可执行的 Python 交互轨迹并进行多轮提纯。为了防止模型在 SFT 阶段产生“调工具依赖症”,团队在训练集中严格混入了基座模型在简单样本上生成的正确纯文本推理轨迹,确保模型保留不调工具的基础推理直觉。
进入核心的强化学习阶段,研究团队基于组相对策略优化(GRPO)算法,针对性植入了两个关键机制:
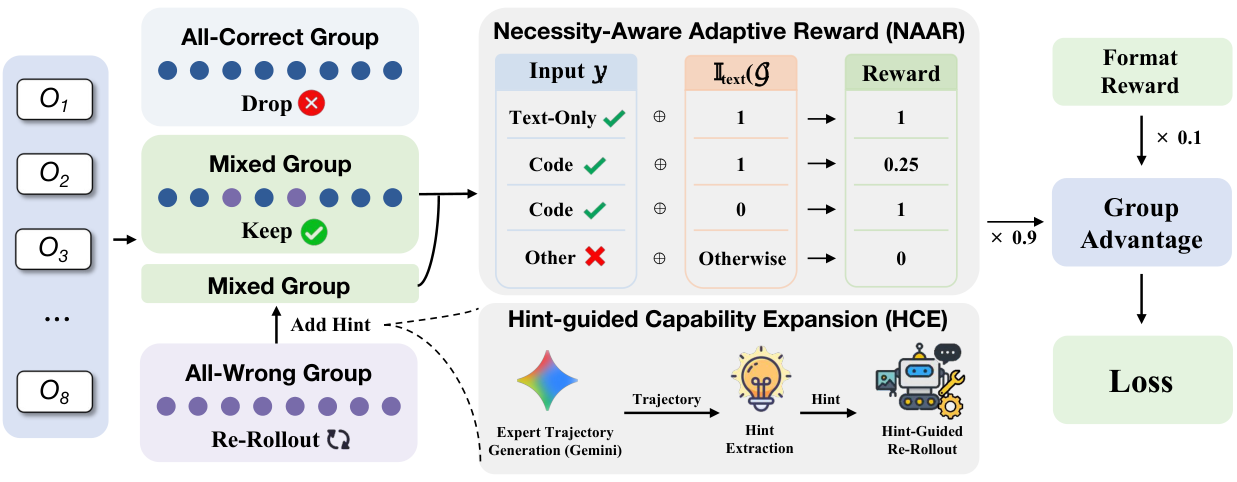
1. 必要性感知自适应奖励(NAAR)
过去的研究在做自适应时往往走向两个极端:要么像 Metis 那样简单粗暴地惩罚工具调用次数,导致遇到难题时模型也不敢用;要么基于固定的教师模型给出静态标签,引发策略漂移。
Beacon 提出的 NAAR 机制采用动态模式标记。在每一次 GRPO 采样组 $\mathcal{G}$ 中,如果判定该题纯文本推理已完全有能力解决($\mathbb{I}_{\mathrm{text}}(\mathcal{G})=1$),纯文本正确回答将获得满额奖励 1.0;若此时模型使用代码且答对,研究团队并不直接给零分或惩罚,而是保留 0.25 的部分正反馈——这样既传达了“无需动用大锤”的优先级导向,又避免了因严厉惩罚而挫伤模型生成有效代码的积极性。而一旦组内判定该题属于纯文本搞不定的难题($\mathbb{I}_{\mathrm{text}}(\mathcal{G})=0$),使用代码答对即可获得 1.0 的满额奖励。
\[R\_{\mathrm{adaptive}}(y\_{i};\mathcal{G})=\begin{cases}1,&\mathbb{I}\_{\mathrm{text}}(\mathcal{G})=1,\;y\_{i}\text{ 为纯文本且正确},\\[2.0pt] 0.25,&\mathbb{I}\_{\mathrm{text}}(\mathcal{G})=1,\;y\_{i}\text{ 使用代码且正确},\\[2.0pt] 1,&\mathbb{I}\_{\mathrm{text}}(\mathcal{G})=0,\;y\_{i}\text{ 使用代码且正确},\\[2.0pt] 0,&\text{其他情况}.\end{cases}\]2. 提示引导能力拓展(HCE)
在标准的强化学习探索中,最棘手的问题往往是“难题全军覆没”。当模型对某个极其复杂的高清图表采样 8 条轨迹均告失败时,组内优势函数计算出的 Reward 几乎全是 0,无法提供任何有效的梯度指引,极具价值的边界样本被彻底浪费。
Beacon 引入了 HCE 机制来破局。当正常采样组 $\mathcal{G}^{\mathrm{n}}$ 全部失败时,系统会激活专家模型(Gemini 3.1 Pro)对该题生成阶段性子目标与操作策略提示(Hint),构成包含工具思路但不包含最终答案的提示输入 $x^{\mathrm{h}}$,引导模型展开第二轮采样 $\mathcal{G}^{\mathrm{h}}$。
最关键的精妙设计在于参数更新环节:在策略优化计算时,输入端强行剥离掉先前注入的 Hint,替换回原始问题 prompt $x$,但保留了在 Hint 辅助下成功探索出的优质轨迹 $y_{i}^{\mathrm{h}}$。这一机制成功将“有提示辅助下探索到的高阶工具运用技能”,无缝迁移至模型在“无提示零样本”环境下的自主演化中,有效拓宽了模型在极端难题上的能力边界。
实测表现:不再为了调工具而调工具
研究团队在包括 V*、HRBench、Visual Probe、RealWorldQA、BLINK、MathVista 以及 MathVision 等 13 个极具挑战性的视觉与多模态基准上对 Beacon 进行了全面评测。
在整体性能上,Beacon 在绝大多数基准中取得了同量级开源模型的最优水平,不仅显著拉开了与原有基座模型的差距,甚至在若干需要复杂空间变换与精细计算的任务中逼近了闭源顶级模型。
更重要的突破在于行为模式的彻底改观。在模式自适应性分析中,随着题目纯文本求解难度的递增,Beacon 表现出了高度单调递增的工具调用率:在简单题上,模型能够极度克制地选用纯文本直接输出,从而保持极低的计算开销;而在面对微小物体精确定位或高难度像素运算时,调用率则迅速拉升至高位。
而在工具效应维度上,Beacon 展现出了前所未有的“净增益”特性。以往模型那种 Tool-Gain 与 Tool-Harm 互相扯平的僵局被打破:Beacon 的 Tool-Gain 达到了同类模型中的最高点,而 Tool-Harm 则被压制在极低水平,两者之间拉开了显著的正向差值。这充分证明,Beacon 所调用的 Python 工具与图像变换代码,真正转化为了解决纯文本所不能及问题的实质能力,而不是华而不实的推理冗余。
总结与展望
Beacon 的探索给当前火热的多模态智能体演化提供了一个极具清醒视角的范式转移:智能体的先进性,不取决于它调了多少次工具、写了多炫目的代码,而取决于它是否真正理解自身的能力边界。
通过将“何时用工具”与“如何用好工具”拆解为可量化、可优化的强化学习目标,Beacon 证明了在 8B 规模的模型上,完全可以激发出兼具克制与锋芒的自主推理决策能力。对于未来多模态大模型走向端侧落地、降低推理成本并实质性攻克复杂视觉任务而言,这种“知进退、懂取舍”的自适应智能体设计,无疑提供了一条高度务实且极具启发性的技术演进路线。