Chimera:混合注意力提速7.3倍,无需位置编码零样本外推30秒视频
Chimera: Designing and Chinchilla-Scaling Hybrid Visual Diffusion Transformers
当视觉生成从简单的 512 分辨率图像走向 4K 高清渲染、数十秒多镜头视频以及复杂的多模态交互时,底层架构正遭遇一场严重的“Token 吞吐危机”。在传统的视觉扩散变换器(Diffusion Transformer,即 DiT)体系中,一张 $4096 \times 4096$ 的图像切分为 $16 \times 16$ 的 Patch 后,就已包含约 6.5 万个 Visual Token;若换成高帧率长视频,序列长度更会迅速膨胀到数十万级别。标准 DiT 所依赖的全自注意力(Full Attention)机制具有二次方计算复杂度,这种开销让显存占用与计算延迟双双失控。
ArXiv URL:https://arxiv.org/abs/2607.28611
大语言模型(LLM)曾经历过类似的序列膨胀阶段,并催生了线性注意力、状态空间模型(SSM)、潜在注意力压缩(MLA)以及混合专家(MoE)等解决方案。然而,语言模型的方法并不能无缝移植到视觉扩散模型中:视觉去噪任务高度依赖二维和三维的空间与时间局部先验,需要支持不同模态间的双向交互,且整个生成过程受扩散时间步与速度场预测的严密约束。更关键的是,业界长期缺少一套像 LLM 那样可预测、成体系的超参数跨尺度迁移与算力分配定律。
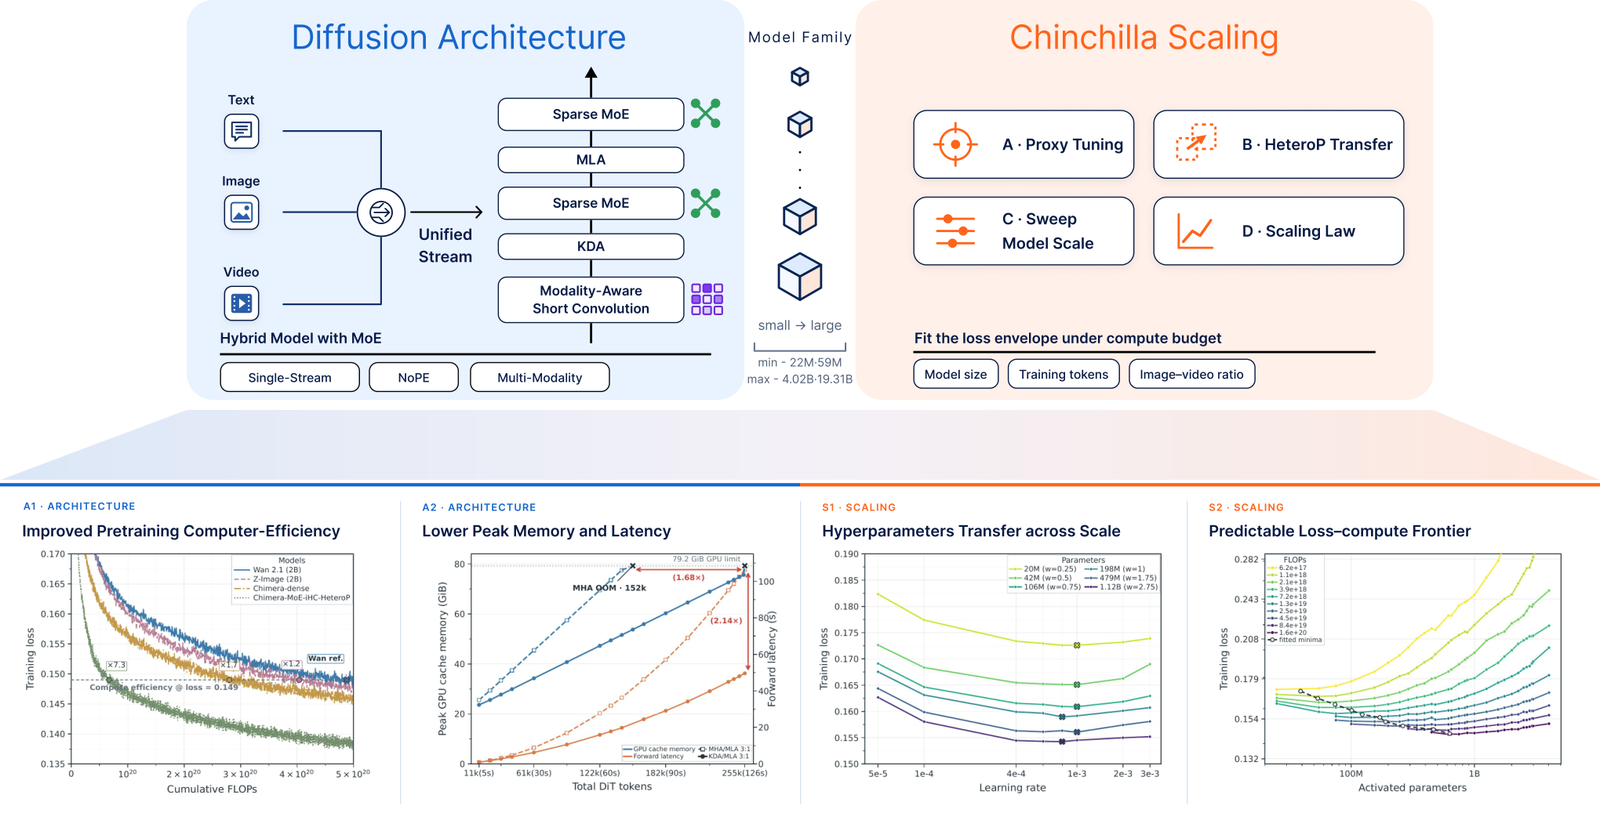
最新研究提出的 Chimera 正面打破了这一瓶颈。它是一套面向海量 Token 生成范式而设计的混合视觉扩散骨干网络,并配备了一套严密的缩放配方。Chimera 将单流统一表示、线性复杂度的 Kimi Delta Attention(KDA)、多头潜在注意力(MLA)、模态感知短卷积(mShortConv)与 MoE 结构融为一体,并且在机制上彻底舍弃了显式位置编码(NoPE)。
在计算效率方面,达到相同的预训练扩散损失,Chimera 的稠密底座比全注意力架构的 Wan-2.1(2B)基线计算效率高出 1.7 倍,而引入 MoE 的完整系统更是将计算效率倍增至 7.3 倍。在生成外推上,仅在 5 秒片段上训练的 Chimera 展现出了惊人的零样本外推能力,无需任何微调即可直接稳定合成 30 秒视频,末尾 5 秒的 FID 仅劣化 6.5%。该团队最终用大约 600 个 H100 卡天(H100 Days)训练出了包含 110 亿总参数、激活参数仅 20 亿的高性能模型,而此前同类顶尖开源模型训练通常需要消耗上万卡天。这项工作为长上下文视觉生成指明了一条兼顾效率与理论可预测性的新路径。
为什么直接搬照 LLM 的高效架构走不通?
在长文本处理中,线性注意力和状态空间模型已经展现出接近全注意力的文本建模水平,但一旦套进视频去噪任务,往往会出现图像细节模糊、时空一致性瓦解等问题。原因在于视觉数据的拓扑特性与一维文本有着本质区别。
文本本身是一维因果序列,而图像与视频则是多维刚性网格。如果简单地将三维时空张量按时间或栅格压平(Flatten)后喂给因果线性注意力,原本在空间上紧邻的上下两个像素,在序列距离上可能相隔数百个 Token。传统的局部一维卷积无法挽回这种跨行跨帧的几何邻近关系;而若像过去一些视觉 Mamba 模型那样引入上下左右、顺逆时针等四向或多向复杂扫描,又会大幅增加计算调度成本并破坏硬件的流水线执行效率。
此外,扩散去噪本质上是一个双向信息补全与精细匹配的过程,纯粹的循环状态压缩(如有限维度的隐藏状态矩阵)很难无损记录图像中所有高频纹理与远距离语义参考。因此,既要将复杂度从二次方压降下来,又要保留全图精确召回的能力,成为视觉扩散模型面临的核心矛盾。
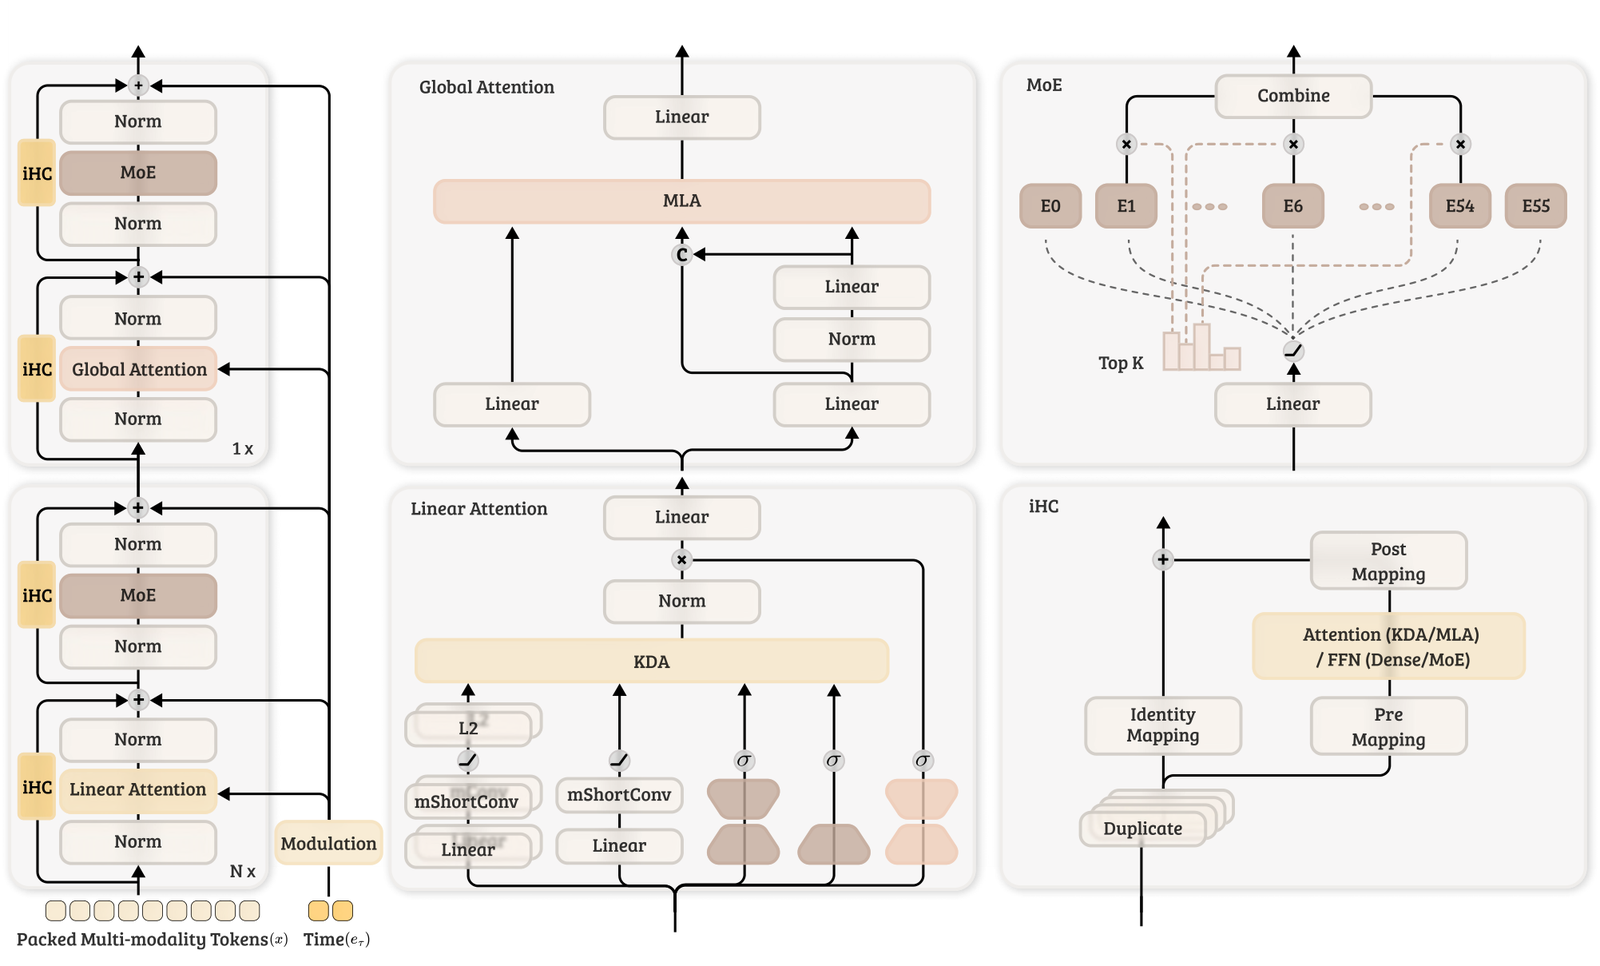
单流混合设计:KDA 与 MLA 的时空互补
为了解决上述冲突,Chimera 采用了一种单流混合骨干网络(Single-Stream Hybrid Backbone)。文本 Token 与加噪的视觉 Token 不再经过各自独立的双流分支,而是直接拼合成一条统一序列,在共享表征空间内完成深层融合。
在这套单流骨干中,Chimera 创造性地采用了以 $3:1$ 比例交替堆叠 Kimi Delta Attention(KDA)与 Multi-head Latent Attention(MLA)的模块组合。
KDA 作为一种具备 $\mathcal{O}(N)$ 线性复杂度的注意力机制,承担了绝大多数序列计算工作。在序列扫描中,KDA 维持一个固定大小的循环状态矩阵 $S_t \in \mathbb{R}^{d_k \times d_v}$。当扫描到新位置时,KDA 结合遗忘门控机制与外积修正进行增量状态写入:
\[S_{t} = \left(I - \beta_{t} k_{t} k_{t}^{\top}\right) \operatorname{Diag}(\alpha_{t}) S_{t-1} + \beta_{t} k_{t} v_{t}^{\top}\]这种 Delta 规则能够根据当前输入自适应地擦除过时信息并写入新表征,极大降低了长序列下的显存占用。然而,由于循环状态容量是常数级别的,面对超长视频时必然存在精细信息的回忆衰减。
为此,Chimera 每隔 3 层 KDA 插入一层全双向自注意力的 MLA。MLA 借鉴自 DeepSeek-V2/V3 的设计哲学,将庞大的 Key-Value 向量低秩投影到紧凑的潜在隐空间 $U$,大幅压缩长序列下的 KV Cache 吞吐负担,同时恢复无死角的双向全局交互。理论计算表明,将有限容量的状态追踪器(KDA)与无约束的全局召回器(MLA)交替级联,其表达能力在形式化语言与序列任务上严格强于单一注意力类型。这种结构在消除了全自注意力二次方算力消耗的同时,完全保全了对全图上下文的全局感知。
摆脱位置编码束缚:模态感知卷积与 NoPE
在当前的生成架构中,旋转位置编码(RoPE)几乎被奉为标准配置。但 Chimera 做出了一个大胆的架构取舍:在 KDA 和 MLA 中彻底废除显式位置编码,实现全架构的 NoPE(No Positional Embedding)。
作者深入剖析了 RoPE 在视觉模型中实际承担的角色,指出 RoPE 实际上混杂了三种不同的归纳偏置:邻近位置的精细空间选择(短距注意力峰值)、随距离衰减的局部效应、以及二维/三维网格的结构感知。然而,强行将这三种功能塞进注意力内积中,不仅消耗了宝贵的注意力投影容量,而且一旦测试时的序列长度超过训练尺寸,RoPE 的高频基底就会产生剧烈的外推失真。
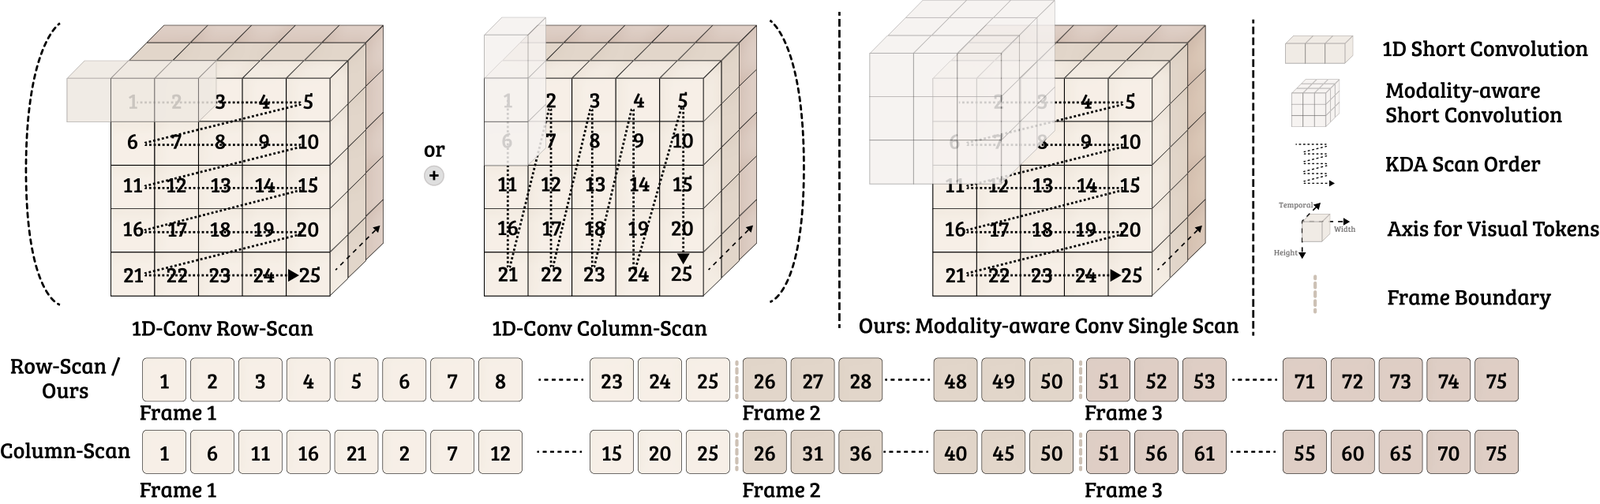
Chimera 的做法是将这三种偏置拆解,交由更纯粹的专用结构独立完成:
首先,针对几何邻域感知,Chimera 提出了模态感知短卷积(mShortConv)。在每一层 KDA 更新前,输入的特征并不按一维压平顺序进行卷积,而是根据其原始模态的几何拓扑进行定向卷积。文本 Token 采用一维因果卷积;单张图像 Token 还原为二维平面做空间卷积;视频 Token 则在三维时空网格中进行时间因果、空间对称的三维卷积。这一设计使得写入 KDA 隐藏状态的每一个向量,在写入前就已经融合了该像素周围的物理邻域信息,从而让模型完全不需要多向反复扫描,仅凭最简洁的“按时间推进、单帧内自上而下栅格扫描”单向顺序,就能完美捕获多维时空局部性。
其次,针对距离衰减与排列偏置,KDA 内部通道级的对角衰减门控 $\alpha_t$ 自然提供了随距离平滑衰减的动力学机制,而栅格扫描自身的先后因果性则赋予了自然的顺序线索。通过将空间几何与距离约束分别剥离到局部卷积与循环门控中,MLA 层的直接匹配仅需专注于纯粹的内容相关性,从而消除了对显式位置编码的依赖,为极长序列的外推能力打下了最坚实的基础。
规模化支撑:MoE 与恒等超连接
在骨干算力从二次方解耦后,前馈网络(FFN)开始成为整个模型的计算开销大头。若为了追求模型容量盲目拓宽稠密 FFN,混合注意力的加速收益将被大幅削弱。Chimera 引入了稀疏 MoE 架构,除最首层与最尾层外,中间所有层均将稠密 FFN 替换为 MoE 结构,以较小的计算代价提升参数量与模型容量。
为了防止视觉生成中常见的专家负载塌陷(Expert Collapse),Chimera 采用基于动态偏置(Load-balancing Bias)的无辅助损失路由机制。路由器通过追踪历史批次中各个专家的负载情况,自适应动态调整路由偏置,确保所有专家吞吐均衡。监测数据显示,即使在训练初期,最大专家过载比(MaxVio)也能迅速稳定在 0.5 左右,彻底杜绝了某几个专家被“挤爆”而其余专家闲置的现象。
而在多层异构模块叠加后,信号前向与梯度反向的稳定性面临严峻挑战。KDA、MLA、卷积与 MoE 的输出统计特征差异极大,标准残差连接若强行将它们简单累加,极易造成深层特征漂移。Chimera 采用了恒等超连接(Identity Hyper-Connections, iHC)配合 Sandwich RMSNorm(层前与层后双重归一化)。iHC 维持多条平行的残差通道,各子层通过数据驱动的注意力门控从多通道中读取并写入更新量,且显式保持主残差流的恒等映射特性。这种机制大幅拓宽了网络内部的信号表征通路,实验证明其能极大地平抑大模型训练过程中的激活异常与梯度震荡。
HeteroP 与异构视觉模型的 Chinchilla 定律
解决了模型架构的设计问题,下一步是如何系统性地将模型放大。传统的 $\mu$P(Maximal Update Parameterization)方案假设网络内部张量的输入输出维度随统一的模型宽度等比例缩放。但在 Chimera 这样深度交错的异构网络中,不同算子的张量行为各异:KDA 内部的状态衰减投影与模型全局宽度弱相关,短卷积核的输入依赖于物理模态,MoE 路由矩阵的行维度随宽度增长但列维度取决于专家总数。若盲目套用全局缩放倍率,极易造成小模型上搜好的学习率、初始化方差在大模型上瞬间失效。
针对这一困境,研究团队提出了模块化超参数跨尺度迁移方案 HeteroP。该方案不再依赖单一的宏观缩放标量,而是依据每个权重张量的实际“功能输入维度”(Functional Fan-in)以及模型深度,独立计算专属的学习率与初始化增益。借助 HeteroP,研发人员只需在几十兆参数的微型代理模型上调优一套优化器超参数,便能零调优地平滑迁移至 190 亿参数的超大规模模型,不同尺寸模型的训练动态与梯度范数保持惊人的一致性。
依托 HeteroP 构建的稳定模型家族,研究团队拟合出了视觉扩散模型领域的计算最优缩放法则(Chinchilla-style Scaling Laws)。与 LLM 仅考虑模型参数与文本 Token 数量不同,视觉预训练必须同时考虑模态数据配比对计算效率的影响。研究通过训练损失包络线、等算力曲面(IsoFLOP)以及参数化损失函数曲面拟合三种独立手段,揭示出两个关键结论:
-
图像预训练的最优分配比接近 1:1:在给定的算力预算 $C$ 下,最优激活参数量 $N_{\mathrm{opt}}$ 随算力的缩放指数约为 $C^{0.48 \sim 0.52}$。这意味着,若要让算力效益最大化,模型容量的扩增与训练图像 Token 总量的增长应当平分秋色,这一规律与语言模型的 Chinchilla 定律高度契合。
-
视频预训练更加偏向扩大模型容量:在视频预训练任务中,随着算力预算的增加,最优模型容量的分配指数上升至 $N_{\mathrm{opt}} \propto C^{0.53 \sim 0.56}$。这是因为视频数据具有极高的时间冗余度,盲目堆砌视频 Token 的信息增益逐渐递减,唯有更大的模型容量才能有效消化并抽象出时空动力学规律。
实验印证:高算力收益与长程零样本外推
基于这套严格拟合的缩放定律,团队指导训练了最终的代表性模型:拥有 110 亿总参数、激活参数严格控制在 20 亿的 Chimera 旗舰版本。各项严苛的实验证实了这一架构的显著收益。
在预训练效率层面,同等算力消耗下,纯稠密版本的 Chimera 底座相较于业内顶尖的全注意力模型 Wan-2.1(2B)实现了 1.7 倍的算力效率;而在开启 MoE 后,整体系统在达到同等预训练扩散损失下的算力开销仅为后者的 $\frac{1}{7.3}$。
在推理与显存表现上,在单张 80GB 的 NVIDIA A100 GPU 上,KDA/MLA 混合底座能够支撑的序列长度是全自注意力版本的 1.68 倍以上;而在处理 25.5 万级超长 Token 序列时,前向推理速度直接达到了传统注意力结构的 2.14 倍。这是因为 FlashAttention 虽能通过分块计算优化显存,但无法消除全注意力二次方的浮点计算量;而 Chimera 中占比 75% 的 KDA 层在推理时只需常数大小的状态矩阵维护,从物理本质上卸下了算力与带宽的双重包袱。
最令人惊叹的是其长视频零样本外推能力。传统视频扩散模型若要在推理时生成更长的视频,通常需要依赖滑窗重叠拼接,或者在长视频数据上进行高成本的针对性微调,否则在超出训练长度后几秒内就会发生画面撕裂、色彩崩塌或运动停滞。而 Chimera 在仅仅见过 5 秒视频训练片段的前提下,凭借无位置编码(NoPE)与模态感知短卷积所赋予的纯粹局部-因果机制,能够直接“零样本”顺畅生成长达 30 秒的连贯视频。评测显示,在生成的最后 5 秒内,其帧级 FID 仅微幅劣化 6.5%,而现有的主流全注意力基线在相同外推条件下的质量衰减幅度通常在 50% 以上。
总结与展望
长久以来,多模态与视频生成领域受困于全注意力机制的高昂代价,许多机构不得不将大笔预算倾倒在暴力堆叠算力上。Chimera 的工作提供了一种高度严密且工程落地的破局范式:
在微观架构上,它没有盲目崇拜全自注意力,也没有简单迷信纯线性注意力,而是通过 $3:1$ 的 KDA 与 MLA 杂交配比,将长上下文状态压缩与全局直接召回解耦,并利用模态感知短卷积彻底摆脱了 RoPE 对长程外推的桎梏;在宏观方法论上,它用 HeteroP 统一了异构模型的跨尺度超参数迁移,并给出了视觉去噪损失下的 Chinchilla 算力分配指导。仅用 600 卡天对撞行业以往动辄上万卡天的消耗,展示了精细化架构与系统缩放方法结合的巨大力量。这项探索预示着,在走向更高清、更长程的物理世界动态模拟时,高效且可扩展的混合骨干架构正逐渐成为下一代视觉基础模型的核心基石。