GMC:砍掉80%视觉Token仍保98%性能,VLM压缩重在消息而非Token
Messages, Not Tokens: Grounded Coresets for Faithful VLM Compression
在高分辨率多模态大模型(VLM)的推理过程中,输入图像动辄被切分为上千甚至上万个图像 Patch(例如一张高分辨率图经过动态切图可能生成数千个视觉 Token)。这些海量的视觉 Token 会全量涌入语言解码器,并在自回归生成的全生命周期中死死霸占 Prompt KV Cache,导致预填充计算和显存占用急剧膨胀。
ArXiv URL:https://arxiv.org/abs/2608.02134
为了打破这一推理瓶颈,社区涌现了大量免训练(Training-free)的视觉 Token 剪枝与压缩方案。然而,主流做法几乎都遵循同一套“独立打分”逻辑:计算每个视觉 Token 相对文本的注意力权重、特征范数或敏感度,然后直接挑出前 $K$ 个最重要的 Token(Top-$K$)。这种做法虽然直观,却在面对复杂图文推理时频频翻车——模型要么把有限的名额全部分配给画面中最吸睛的单一主体,漏掉了不起眼的数字、坐标轴刻度或微小物体;要么直接将未选中的大部分 Token 彻底丢弃,抹杀了背景群体所携带的上下文信息。
论文《Messages, Not Tokens: Grounded Coresets for Faithful VLM Compression》指出了这一范式的底层病灶:语言解码器消费的从来不是孤立的 Patch,而是由视觉群体联合贡献的、带符号的注意力聚合消息(Collective Signed Attention Messages)。 针对这一洞察,作者提出了无需训练的“锚定消息核心集剪枝”方法(Grounded Message Coreset Pruning,简称 GMC)。该方法不再纠结于单个 Token 的孤立打分,而是将视觉压缩重构为解码器消息的紧凑核心集(Coreset)构建与传输问题。
在 Qwen2.5-VL-7B 上的测试显示,GMC 在前置压缩点(H2)砍掉高达 80.2% 视觉 Token 的极端条件下,依然保留了 97.78% 的基准综合能力;若在更深层(L16)实施压缩,其性能甚至达到了未压缩基线的 100.36%。在高达 15,876 个视觉 Token 的超长文档问答基准 DocVQA 上,GMC 将 Prompt KV 显存占用削减了 73.94%,获得了 1.258 倍 的端到端实际加速,同时几乎无损精度。这一成果不仅刷新了免训练视觉压缩的上限,更在理论和实验上系统证明了:多模态压缩的关键在于保护解码器真正接收的消息,而非保留高分 Token。
从独立打分到群体消息:传统剪枝为何频频失效?
要理解 GMC 的创新,首先要拆解传统 Top-$K$ 机制的缺陷根源。
在多模态生成中,解码器各注意力头的查询向量(Query)在观察图像时,其计算形式是加权聚合:$Y_h = A_h V_h$。这意味着文本查询实际上是在“征求全体视觉 Token 的汇总陈述”。回答一个复杂问题所需要的证据往往是互补且分散的。例如,图表问答需要同时看清柱子高度、坐标轴和刻度线;空间推理需要同时锁定两个物体及其相对方位;一段文本识别可能横跨多个相邻 Patch。
如果沿用传统 Top-$K$ 的标量打分机制,就会出现两个致命问题:
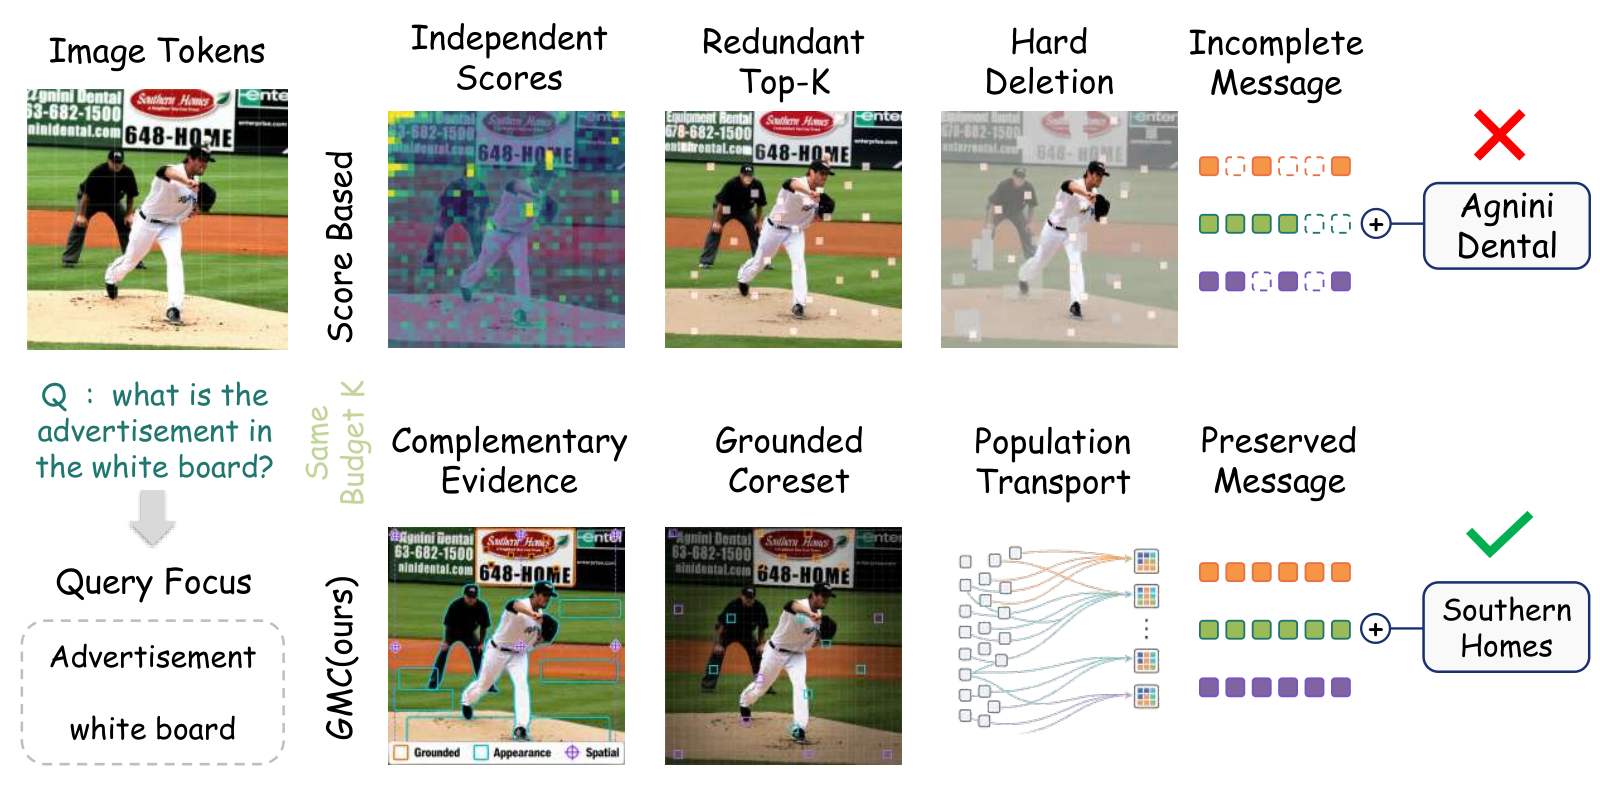
其一,支持集冗余与盲区并存。如图 1 所示,独立打分机制倾向于在显著区域(如物体主体)重复挑选特征高度重叠的 Token,而那些对推理至关重要但绝对分值偏低的点(如角落里的数字或细微边框)则被无情过滤。即便某些方法引入特征多样性惩罚,单纯基于原始特征空间的分散性也无法对齐语言解码器在特定层所需要的注意力分布。
其二,硬截断导致的群体信息蒸发。现有的硬剪枝方案直接抛弃掉未被选中的 Token。然而,即使某些区域对答案没有决定性贡献,它们所提供的背景基底、上下文衬托依然构成了注意力机制的计算分母与语义环境。简单的“一刀切”不仅会丢掉弱信号,还会让注意力权重的归一化基准产生严重畸变。虽然有部分合并(Merging)方法尝试将未选中的 Token 进行聚类混合,但若在选定代表(Support)时没有考虑群体分布,事后强行融合往往会导致“代表挑偏了、融合又抹平了细节”的尴尬局面。
GMC 给出的解法是:将保真压缩明确解耦为两个紧密咬合的核心任务——首先挑选出一组能够覆盖所有关键消息模式的“载体”(Carriers),随后将所有未选中的剩余群体状态精确“搬运”(Transport)到这些载体上。 最终,在物理压缩生效并恢复自注意力计算时,语言解码器所接收到的加权消息与未压缩状态相比几乎不发生畸变。
GMC 两阶段解耦架构:怎么选载体,怎么运信息?
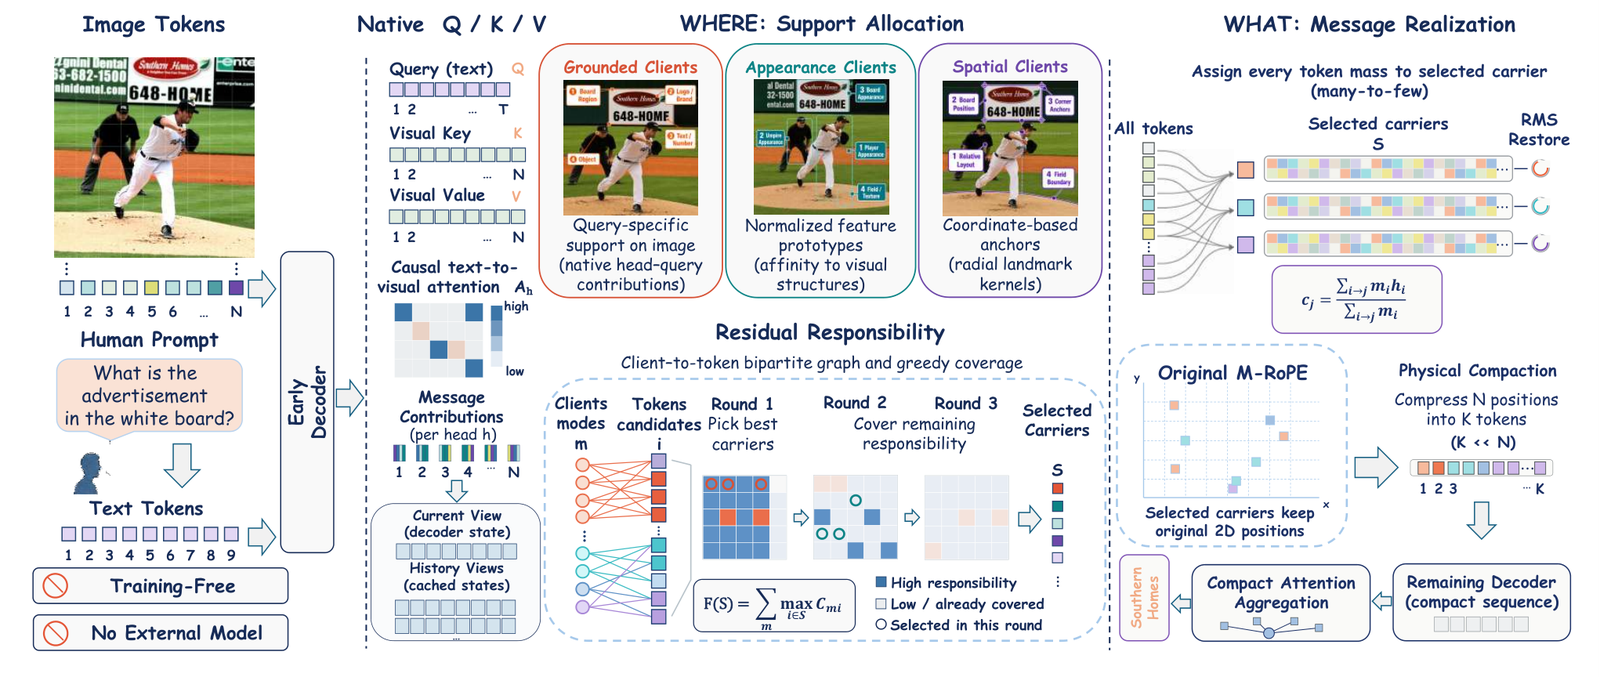
为了在不微调、不加额外模型的前提下实现这一目标,GMC 巧妙利用了 Transformer 解码器在特定层截面上的固有几何特性,将压缩流程拆解为图 2 所示的两个阶段。
阶段一:多维度证据联合分配(Support Allocation)
压缩算法首先需要决定有限的 $K$ 个预算应该落在哪些位置。GMC 抛弃了标量排序,转而将其形式化为一个加权设施选址(Facility-Location)的次模最大化问题。
系统在压缩层截面定义了三组互补的“客户端”(Clients):
-
查询锚定客户端(Query-Grounded Clients):直接从当前层各注意力头的真实 Query-Key 交互中提取。由于多头注意力中每个头关注的子空间不同,GMC 使用固定的微型正交探针将各头的值向量投影,并保留因果 Softmax 的自然归一化比例,确保当前提示词已经激活的视觉线索得到最高保真度的覆盖。
-
全局外观客户端(Appearance Clients):当前提示词虽然激活了一部分区域,但在后续的多轮自回归生成中,未来的答案 Token 可能会需要此前未被注意到的细节。因此,GMC 在归一化视觉特征上构建外观客户端,防止模型在预填充阶段因为“目光短浅”而丢失全局视觉上下文。
-
空间网格客户端(Spatial Clients):依托图像原本的物理二维坐标构建局部高斯核,确保选取的载体在物理空间上具备合理的跨度,避免丢失宏观几何关系。
在优化这个联合覆盖目标函数时,GMC 引入了一种批次负责制(Responsibility-Driven Greedy Selection)。它在每一轮迭代中,不是孤立挑选边际增益最大的单点,而是通过 Softmax 计算未被满足的客户端质量对候选点的“联合负责度”,分批将互补的载体吸纳进支持集 $S$。这保证了选出的代表天然具备证据层面的多样性与互补性。
阶段二:保真群体传输与物理重构(Population Transport)
选出了 $K$ 个最具代表性的物理载体后,被遗弃的 $N - K$ 个 Token 并不会被直接丢掉。GMC 通过保真传输机制,将被丢弃的特征状态无损搬运到这 $K$ 个代表中。
这个搬运过程不是粗暴的就近平均,而是兼顾了语义匹配与空间局域性。对于每一个被丢弃的 Token,算法计算它与同图所有当选载体之间的余弦相似度差距,构造样本可分性门控与局部模糊度权重。当语义匹配非常明确时,信息优先流向全局语义最契合的载体;而当特征处于模糊边缘时,信息则优先汇入空间邻近的载体。
确定归属后,载体以保留群体总能量为原则计算加权质心,并结合原始载体状态进行带有 RMS 尺度修复的残差重构:
\[\widetilde{h}_j = \mathcal{R}_j\left((1-\tau_j)h_j + \tau_j c_j\right)\]重构完成后,未被选中的物理位置被正式剔除,序列长度从 $N$ 骤降至 $K$。更关键的是,每个当选载体均保留其原始的多模态二维位置编码(Multimodal Position IDs)。自压缩层之后的所有后续 Transformer 块,直接在长度为 $K$ 的紧凑序列上无缝运行原生的因果注意力与前馈计算。由于没有引入任何非标准算子,计算流在底层硬件上实现了物理级别的显存与计算缩减。
为什么结果更保真?误差传递与候选稳定性的理论证明
很多免训练剪枝算法往往缺乏严谨的理论闭环,只能依赖经验调优。论文在理论层面给出了强有力的收敛与保真保障,解释了为什么“消息级保真”能够直接抑制下游大模型的生成幻觉。
首先,论文证明了其批次设施选址求解器具有严谨的下界保障。尽管支持集是成批加入的,但利用次模函数的单调性,作者推导出了一个完全由运行时在线指标构成的近似比下界:
\[F(S_T) \geq c_B F(S^*) + (1-c_B) F(S_0)\]其中 $c_B$ 随迭代推进逐步累积,实验中每一条样本都可以实时验证覆盖率的理论达标情况。
其次,针对解码器输出消息的失真,作者推导了从状态传输误差到符号注意力消息误差的控制上界(Proposition 2)。解码器下游实际接收到的注意力聚合差值被严格分解为两项:
\[\left\lVert y_g - \widetilde{y}_g \right\rVert_2 \leq \left\lVert W_g^V \right\rVert_2 \left[ R_g + H_S \left\lVert M_g - \bar{a}_g \right\rVert_1 \right]\]公式中的第一项 $R_g$ 代表特征搬运本身的残差,它直接受控于支持集对客户端的覆盖度;第二项则直接衡量了“群体总注意力质量与紧凑注意力质量的匹配度”。这一分解不仅从数学上揭示了传统硬剪枝必然导致大失真的原因,也验证了 GMC 将“载体能量分配”与“带符号消息传输”解耦处理的必要性。
更进一步,论文将压缩误差与最终文本生成的 Token 决策联系在一起。在自回归生成的决策边界处,作者定义了反先验加权的“视觉新颖度”(Visual Innovation, VIE),并证明了候选边界稳定性引理(Lemma 1):只要压缩引起的 Logit 扰动 $d_C$ 小于全量未压缩状态下的 Top-1 与 Top-2 候选边界差的一半(即 $d_C < \gamma_{ab}/\sqrt{2}$),模型的下一个 Token 预测就绝对不会发生翻转。这直接构成了对事实性错误和幻觉现象的防御屏障。
实验全景透视:80% 极限剪枝下的性能坚守
为了检验该机制的实际表现,论文在 Qwen2.5-VL-7B(默认 $N=1{,}296$)和 LLaVA-1.5-7B($N=576$)两大代表性架构上,横跨九大主流基准开展了全面评测。
评测设定了两个典型的截断截面:其一是靠前的高效操作点 H2(在第 2 个 Transformer 块前即刻压缩,最大化节省计算量);其二是靠后的高保真操作点 L16(在前 16 层保留全量上下文提炼深度语义,后续层享受紧凑加速)。
1. 综合图文理解能力
在包含 TextVQA、ChartQA、MME、POPE、MMBench 和 GQA 的标准测试集合中,GMC 表现出了远超以往强基准(如 FastV、SparseVLM、VisionZip、MMTok 等)的稳定性。
在 Qwen2.5-VL-7B 这一极具实用价值的现代架构上,当 Token 预算被暴力压制到仅剩 $K=256$(削减幅度达 80.2%)时,GMC-H2 保留了未压缩模型 97.78% 的基准性能。在更加严苛的 $K=128$(砍掉 90.1%)条件下,传统方法如 FastV 和 DivPrune 的平均分往往剧烈下滑 15% 到 30%,甚至出现长图表逻辑完全瓦解的情况,而 GMC-H2 依然稳稳守住了 93.51% 的均值。
如果将压缩截面放置在第 16 层的 GMC-L16,模型在 $K=256$ 时甚至打出了 100.36% 的满血成绩,彻底打破了“剪枝必然损耗精度”的固有认知。这说明,在深度层通过去除冗余视觉噪声并将群体能量聚焦在关键证据载体上,反而能够起到提纯提示词信号的正面效果。
2. 幻觉与事实保真度对抗
幻觉抑制是检验压缩算法是否真正“看全看懂”的试金石。论文在 POPE、AMBER、HallusionBench 以及图像描述生成度量 CHAIR(包含 CHAIRs 句子级与 CHAIRi 实例级)上进行了高强度压测。
实验结果表明,在相同的紧凑预算 $K=128$ 下,GMC 在所有幻觉基准上均显著击败了此前领先的 MMTok 和 VisionZip。尤其是在对细节要求极为严苛的 HallusionBench 上,常规剪枝由于丢弃了局部微小物体,模型往往退化为依赖语言先验“闭着眼睛瞎猜”,幻觉率直线上升;而 GMC 凭借外观与空间客户端对暗弱特征的兜底保全,以及群体特征向载体的精确收束,使 CHAIRs 的幻觉检出率大幅降低。前瞻性审计(Prospective Audit)实验更显示,450 次评测截面中没有一次真实候选预测逃逸出其安全边界,充分证实了候选稳定性引理在实际场景中的有效性。
3. 真实工业级长文档问答:DocVQA 物理加速实测
许多基于 Token 丢弃的加速论文往往只报告理论 FLOPs,一旦实测真实端到端时延,往往因为碎片化访存或掩码开销而原形毕露。作者直接在包含 15,876 个超长视觉 Token 的 DocVQA 极端场景下对 GMC 进行了全链路物理部署审计。
实验数据显示,在处理一万五千多个 Token 的高分辨率文档扫描件时:
-
GMC 实现了 73.94% 的 Prompt KV Cache 显存暴跌,直接解除了大批量并发时的显存溢出(OOM)风险;
-
实现了 1.258 倍的端到端真实推理加速,且分析证实加速收益完全来自对视觉前缀计算的物理剔除,而非生成更短的文本回答;
-
最终的 DocVQA ANLS 得分保留率高达 98.87%,几乎完美维系了对复杂版面文字、表格数据的检索与提取精度。
跨模型迁移实验进一步证实,在无需任何超参数重调的情况下,GMC 直接部署到 LLaVA-1.5-7B 上同样在 $K=64$ 和 $K=128$ 下实现了超过 99.7% 的性能保留率,展现出了极强的跨架构泛化韧性。
拆解 GMC 的增益密码:是哪些设计在起作用?
为了彻底搞清楚 GMC 强劲表现背后的驱动力,作者设计了精细的因果消融(Factorial Interventions),逐一剥离各模块进行机理诊断。
其一,支持集构建与群体传输的强协同性。实验对比了“单独使用负责制支持集选择但采用硬剪枝”、“传统独立 Top-$K$ 打分但事后强行聚类传输”以及“GMC 联合方案”。结果表明,单纯改善挑选逻辑(支持集)能带来显著跳升,而在此基础上加上群体特征传输,在极小预算(如 90.1% 压缩比)下能进一步带来超过 3 个百分点的核心精度增益。这印证了论文的核心假设:选出好载体固然重要,但把没选上的群体信息妥善安放在这些载体上,是维系最终下游消息保真度不可或缺的下半场。
其二,多维客户端的互补效应。若剥离基于真实 Query 交互的查询锚定客户端,模型在 VQA 等任务上的指向性迅速模糊;而若剥离空间与外观客户端,在需要长程自回归或探索性生成的任务中,模型往往后劲不足。多头查询、外观流与空间网格三者的权重联合,构筑起了一张动态防御网,既锁死了当前提问的焦点,又为后续潜在的生成分支保留了物理底图。
对未来 VLM 推理架构设计的启示
GMC 的工作为多模态大模型的推理优化带来了极富启发性的视角转换。
长期以来,视觉 Token 压缩领域普遍受到自然语言处理中“词级别剪枝”的惯性思维束缚,下意识地把每个视觉 Patch 视为具有独立语义的基本单元。然而,视觉信息与离散的自然语言存在本质不同:图像信号本身具有连续性、高冗余性与全局漫射性。在自注意力机制中,语言模型消费的是由这片连续信号激发的注意力加权向量场,即文中所强调的“消息”,而非某几个孤立的“视觉单词”。
GMC 证明了:只要能够精确重构并保全向后传递的加权注意力消息,我们在物理上丢弃掉 80% 到 90% 的视觉 Token 是完全可行的。 这种将“几何载体选择”与“连续群体状态传输”相互解耦、在关键层实施物理截断、同时维系多模态原始坐标系的设计,不仅为当前端侧大模型的高吞吐部署提供了一种即插即用、零额外训练成本的破局方案,也势必会启发未来更多多模态模型在预训练结构设计上,主动探索从“密集 Patch 堆叠”向“紧凑消息核心集表征”的深层演进。