MemSIF:解耦结构化交互与双轨事实,长程Agent记忆准确率提升8.79%
MemSIF: From Structured Interactions to Dual-Track Fact Memory for LLM Agents
赋予大语言模型(LLM)长期记忆,往往被简化为“把历史对话存起来,需要时做 RAG 检索或生成摘要”。然而,当智能体在长达几十个会话、横跨数万甚至十万 Token 的真实场景中运行时,这一朴素的思路迅速暴露出底层逻辑上的缺陷。大量实验与落地案例表明,简单的窗口切分或静态事实抽取,极易让 Agent 在多轮交互后陷入遗忘、上下文断裂或幻觉。
ArXiv URL:https://arxiv.org/abs/2608.01742
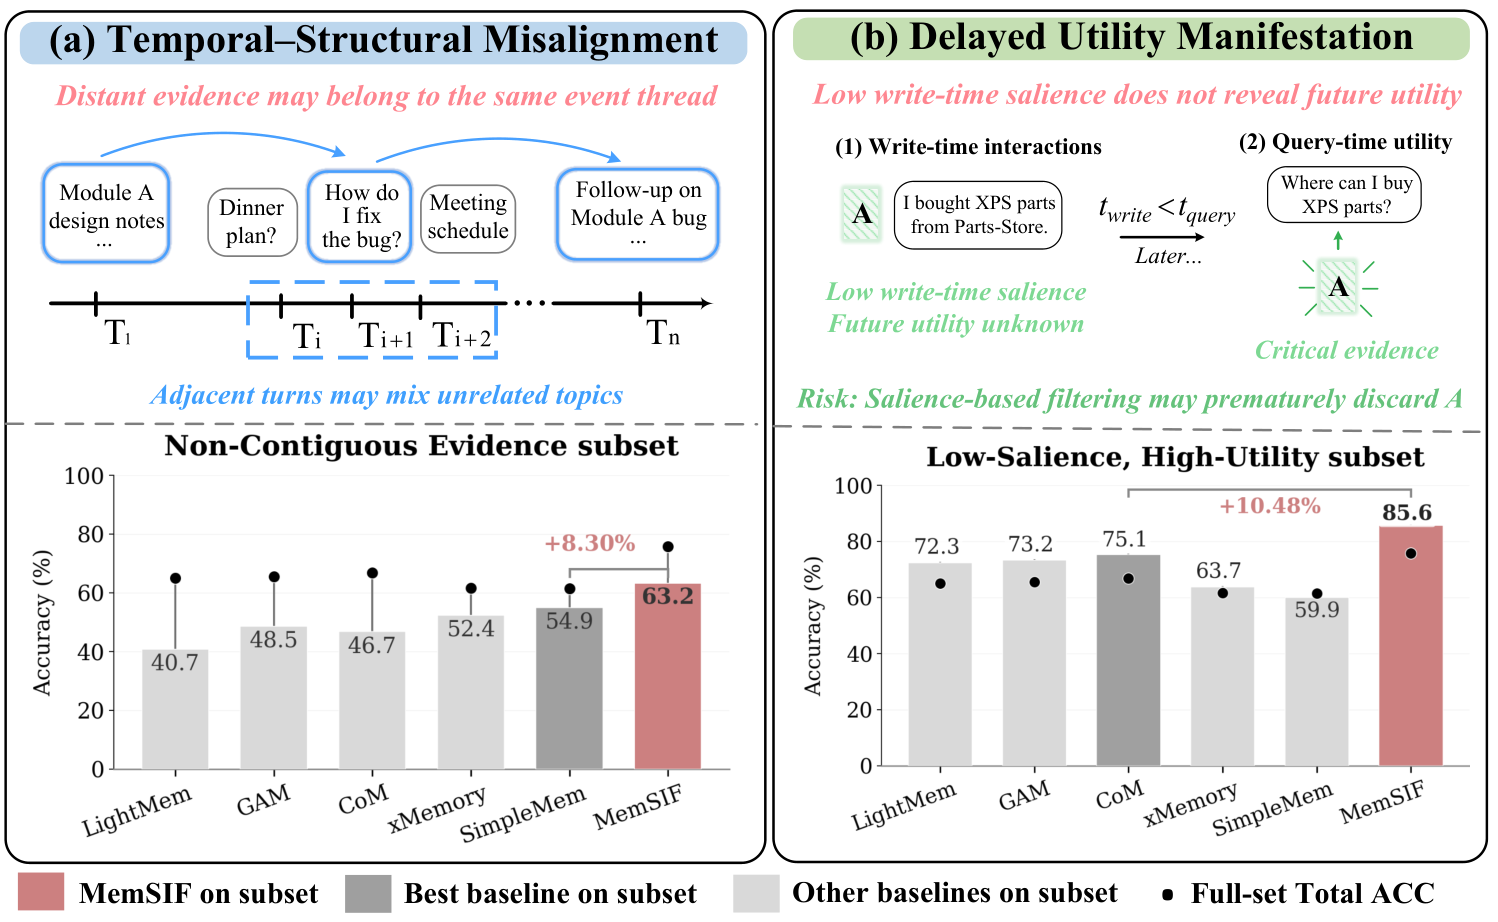
这一困境的根源并非单纯的检索算法不够强,而是现有记忆机制普遍忽视了长期人机交互中的两个系统性错配:时间-结构错配(Temporal-Structural Misalignment, TSM)与延迟效用显现(Delayed Utility Manifestation, DUM)。前者揭示了物理时间上的临近往往不代表语义或任务上的关联;后者则道出了长期记忆最棘手的工程悖论——在写入记忆的那一刹那,系统根本无法预知某条看似细碎的信息在未来是否会被高频追问。
针对这两大结构性痼疾,本文提出了 MemSIF(Memory with Structured Interactions and Facts)框架。该方法抛弃了传统的单轨交互处理方式,将原始对话重塑为保留局部话题连续性的“话题片段”与追踪跨时间任务演进的“事件轨迹”;在此基础上,进一步构建了动静分离的双轨事实层:静态的核心事实(CoreFact)负责沉淀长期稳定的画像,动态的活跃事实(ActiveFact)则依据历史支撑度与反复查询需求按需晋升。评测显示,MemSIF 在 LoCoMo 和 LongMemEval-S 两个长程记忆基准上,全面超越了 Mem0、MemoryOS、SimpleMem 和 GAM 等主流记忆方案,在多款开源及闭源大模型基座下取得 2.29% 至 8.79% 的准确率提升,并在时间跨度大、低显著度信息定位等极限诊断场景中展现出显著的抗衰减能力。
长期记忆失效的两个系统性错配
要理解 MemSIF 的设计精妙之处,首先需要看清现有 Agent 记忆方案为何频繁失灵。大多数系统要么在对话发生时(Write-time)立刻提取三元组或生成总结,要么在用户提问时(Query-time)顺着上下文深挖线索。但无论哪种路径,都绕不开时间与价值两个维度的失真。
时间-结构错配(TSM)普遍存在于自然的人机交流中。用户可能在连续几轮对话里从讨论周末聚会突兀地跳转到询问工作代码,物理时间高度相邻,话题结构却完全脱节;反过来,一项复杂的跨周任务或某个长线规划,往往被打散在相隔数天的多次对话中。现有的固定窗口分块、基于单轮对话打标或固定会话归档的做法,要么把互不相干的碎片强行塞进同一个记忆块,要么把属于同一事件的多跳线索斩断在不同的记忆单元中。当模型面对需要整合长周期背景的多跳(Multi-hop)问题时,检索机制很难把散落在各处的拼图重新拼合完整。
延迟效用显现(DUM)则直接击中了写入时评估的死穴。信息在产生瞬间的“显著度”(Salience)和它在未来的“实用价值”(Utility)极不对称。例如用户随口提及“我姐姐最近买了一只柯基”,在写入时刻,这句话很可能被紧缩算法判定为低优先级的闲聊细节而直接丢弃;但如果在十天后,用户突然提问“我应该给我姐送什么规格的宠物牵引绳?”,当初被遗弃的琐碎信息就变成了不可替代的推论锚点。如果系统在写入阶段采取激进的过滤策略,就会造成永久性遗忘;若采取保守策略全量留存,又会导致记忆库迅速膨胀,引入海量噪声与高昂的检索开销。即使依赖查询时临时深挖(如 GAM 或 CoM),由于临时抽取的证据链并没有被固化沉淀,每次面临相似提问都要重复高成本的全局扫描,极易引发连续漏检。
结构化交互记忆:重塑时空拓扑
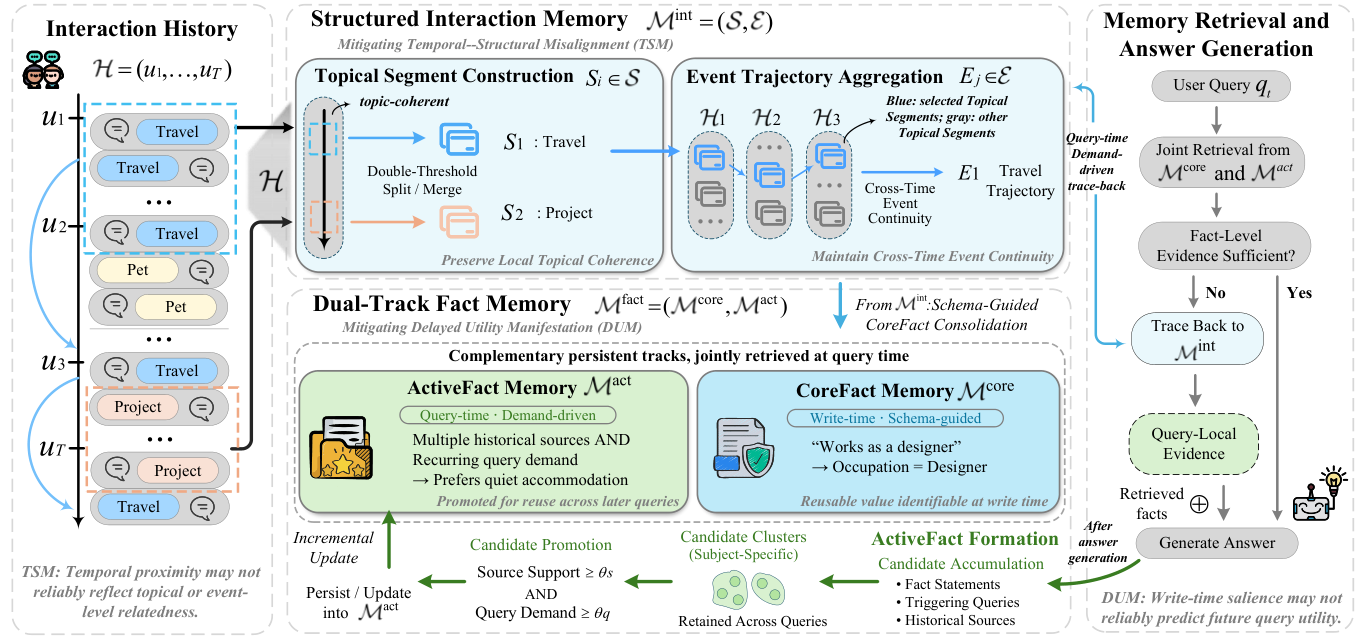
为了化解 TSM,MemSIF 首先对底层的交互历史 $\mathcal{H}$ 进行解构与重组,不再依赖生硬的固定时间切片,而是建立起双层拓扑结构:话题片段(Topical Segments, $\mathcal{S}$)与事件轨迹(Event Trajectories, $\mathcal{E}$)。
整个结构化处理以一个结合了语义表征与实体交集的联合匹配函数 $\phi(A, B)$ 为基石:
\[\phi(A,B)=\alpha s_{\mathrm{sem}}(A,B)+(1-\alpha)J(\mathcal{K}_{A},\mathcal{K}_{B})\]式中,$s_{\mathrm{sem}}$ 为归一化后的余弦文本相似度,$J$ 为实体集合间的 Jaccard 重合系数,权重 $\alpha$ 在实验中被置为 0.8,兼顾语义漂移控制与关键实体的硬重叠。对于包含多条消息的片段或轨迹,系统采用均值池化(Mean-pooling)更新表征,并将实体集持续做并集更新。
在构建局域话题片段时,MemSIF 采用了一种兼顾计算效率与语义平滑的双阈值判定机制。系统按时间序遍历输入消息 $u_t$:
-
当 $u_t$ 与当前片段 $S_i$ 的联合匹配分 $\phi(u_t, S_i) \geq \tau_{\mathrm{merge}}$ 时,判定为话题延续,直接并入;
-
当匹配分 $\phi(u_t, S_i) \leq \tau_{\mathrm{split}}$ 时,判定为明确的话题切换,立即封顶当前片段并开启新片段 $S_{i+1}$;
-
仅当相似度落入灰色区间 $(\tau_{\mathrm{split}}, \tau_{\mathrm{merge}})$ 时,系统才会调用轻量 LLM 辅助研判边界。
这种设计将绝大多数非黑即白的对话归类下放给轻量级向量与实体计算,仅把少量模糊边界留给大模型做仲裁,在严守话题局部内聚性的同时,避免了对推理 API 的频繁调用。
完成局域话题切分后,MemSIF 进一步启动跨时间跨度的事件轨迹聚合。面对新生成的片段 $S_i$,系统通过联合匹配函数召回全局历史中 Top-$K$ 个最相关的现有事件轨迹候选,再借助 LLM 统一评估事件身份(Identity)、任务连续性(Continuity)与状态演变一致性(State Consistency)。符合条件的片段会被串联进对应的长线事件流中;若无匹配轨迹,则以该片段为起点启动全新的轨迹。通过这一步,原本在物理时间轴上孤立分散但属于同一主线的线索,在图谱层面上被重新链接为连续的因果链条,从而在根本上化解了 TSM 导致的线索断裂。
双轨事实记忆:从静态收敛到动态沉淀
理顺了交互结构之后,如何应对 DUM 带来的信息效用滞后?MemSIF 的回答是打破“一次性写入即固化”的传统思路,采用核心事实($\mathcal{M}^{\mathrm{core}}$)与活跃事实($\mathcal{M}^{\mathrm{act}}$)并行协同的双轨架构。
核心事实轨(CoreFact)专注于处理确定性高、写入时价值显而易见的稳态信息。为了防止开放式抽取带来的信息污染与冗余膨胀,MemSIF 在此引入了预先定义的配置化 Schema($\mathcal{Y}^{\mathrm{core}}$),重点锚定用户偏好、长期身份档案以及关键任务状态。这些内容在写入时便具备极高的复用概率,因此直接标准化落盘,形成紧凑的持久化底座。
真正的技术创新集中在应对不确定性的活跃事实轨(ActiveFact)。ActiveFact 并不强求在写入时就对所有琐碎细节下达判决,而是允许原始细节暂时停留在结构化交互层,将提炼与固化过程推迟并分摊到后续的问答交互中:
-
查询驱动的局部抽取(Query-Local Extraction):当用户提问到来,且检索到的事实层信息无法充分回答问题时,系统会回溯至结构化交互记忆中,调用相关的话题片段和事件轨迹,抽取出支撑当前回答的原子陈述,并标记完整的源头出处(Source Provenance)。这部分证据直接用于生成当次回答,但并不草率地写入持久库,回答完毕后即刻从临时缓冲区清空。
-
候选簇沉淀与跨查询积累(Candidate Accumulation):被抽取的陈述、来源以及触发该提问的查询句,会被汇总为候选簇,跨查询持久保留在候选池内,静默等待时间与需求的考验。
-
双重信号加权晋升(Candidate Promotion):随着交互推移,MemSIF 对每一个候选事实簇 $C_k$ 持续计算两组信号——历史来源支撑度 $\mathrm{Score}{\mathrm{src}}$ 与查询需求聚合度 $\mathrm{Score}{\mathrm{qry}}$:
其中 $\lvert \mathcal{R}_k \rvert$ 代表支撑该事实的历史交互来源数量,$\lvert \mathcal{Q}_k \rvert$ 代表反复触发该事实需求的独立查询数,$\mathrm{Coh}(\cdot)$ 衡量集合内向量的平均两两余弦相似度。只有当两个维度的评分同时跨过预设阈值($\theta_s$ 与 $\theta_q$),候选条目才会被正式归一化为持久化的 ActiveFact 记忆条目:
\[P(C_{k})=\mathbf{1}\left[\mathrm{Score}_{\mathrm{src}}(C_{k})\geq\theta_{s}\land\mathrm{Score}_{\mathrm{qry}}(C_{k})\geq\theta_{q}\right]\]这一晋升机制的妙处在于,它既抵御了偶发、低频噪音对长期事实库的侵蚀,又确保了那些最初看似微不足道、但随后在真实交互中反复显现价值的“暗线事实”能够被精准打捞并永久固化。在后续查询中,系统可以直接命中这部分事实,无需一次次重构历史上下文。
检索问答全流程:自顶向下的层级路由
在推理阶段,MemSIF 建立了一套严谨的层级化供给逻辑。每当接收到新查询 $q_t$:
系统首先在轻量的事实层检索,同时拉取匹配的 CoreFact 与已晋升的 ActiveFact。接着,一个专职的“充分性检查模块”(Sufficiency Checker)接入研判:当前检索到的事实集合,能否严密、无遗漏地覆盖回答 $q_t$ 所需的全部事实?
如果判定充分,系统直接以事实级上下文输入主模型生成回答,整个过程开销极小;一旦判定事实不足,系统才激活下潜逻辑,按需穿透到底层的结构化交互记忆库中,检索相关的 Topical Segments 与 Event Trajectories,提取细粒度的支撑证据拼入上下文,并在回答生成后将新发现的线索反哺给 ActiveFact 流水线。
这种动静分离与按需回溯的机制,使得 Agent 在应对常规日常查询时只消耗极少的 Token 成本,而在面对极其复杂的跨时空追问时,又具备顺藤摸瓜调动原始时空脉络的后备能力。
实验评测:全场景领先与专项突破
论文在 LoCoMo 和 LongMemEval-S 两个极具代表性的长程记忆评测集上进行了全面验证。LoCoMo 侧重包含平均 27 个会话、长达上万 Token 的长链条复杂双人交互;LongMemEval-S 则覆盖了交互历史平均超过 100K Token 的极限长文本场景。测试横跨 Qwen3-4B、Qwen3-8B、Qwen3-32B、Llama-3.1-8B-Instruct 以及 DeepSeek-v4-pro 等 5 种不同参数规模和架构的底座模型。
从实验总准确率(Total ACC)来看,MemSIF 在所有基座模型和两套数据集上均刷新了最优记录。在 LoCoMo 上,相较于此前表现最稳固的基线(如 GAM、SimpleMem、MemoryOS 等),MemSIF 实现了 2.29% 到 8.79% 的绝对增益;在超过 10 万 Token 跨度的 LongMemEval-S 极限测试中,依然保持了 2.87% 到 6.15% 的显著领先。基于 10,000 次成对 Bootstrap 重抽样分析显示,MemSIF 的 95% 置信区间完全排除了零点,证明这些性能提升具有极高的统计稳健性,并非随机波动带来的微弱优势。
更为关键的是论文构造的两个定向诊断子集上的表现:
-
非连续证据子集(NCE):专门筛选金标准证据散布在相距甚远的回合、时间分散度 $\mathrm{TED} \geq 0.3$ 的样本。在该测试下,MemSIF 相比最强基线带来了 8.30% 的绝对跃升,印证了 Event Trajectories 缝合跨时空线索的必要性。
-
低显著度-高实用度子集(LSHU):专门挑选在产生时刻信息显著度极低($S(e) \leq 2$)但后续查询价值极高($U(e, q) = 3$)的样本。在此类严苛的“潜伏线索”考核中,MemSIF 展现出更加断层的领先优势,准确率直接超出最强基线 10.48%,强有力地支撑了 ActiveFact 按需提取与双重门禁晋升机制在化解 DUM 上的有效性。
消融实验进一步厘清了各模块的职责边界:
-
剔除话题片段(w/o TS)或剔除事件轨迹(w/o ET),均会导致多跳问答(Multi-hop)和长周期问题表现明显下滑;
-
移除核心事实(w/o CF)会使得常规属性检索的召回率受损,增加检索穿透率与计算延迟;
-
移除活跃事实(w/o AF)则使得系统在面对低显著度演化信息时退化为普通的写入期静态系统,LSHU 场景的得分发生断崖式下跌。
这表明,交互结构的重塑与事实双轨机制并非互不干涉的堆叠,而是形成了紧密的互补闭环。
准确率与系统开销的工程权衡
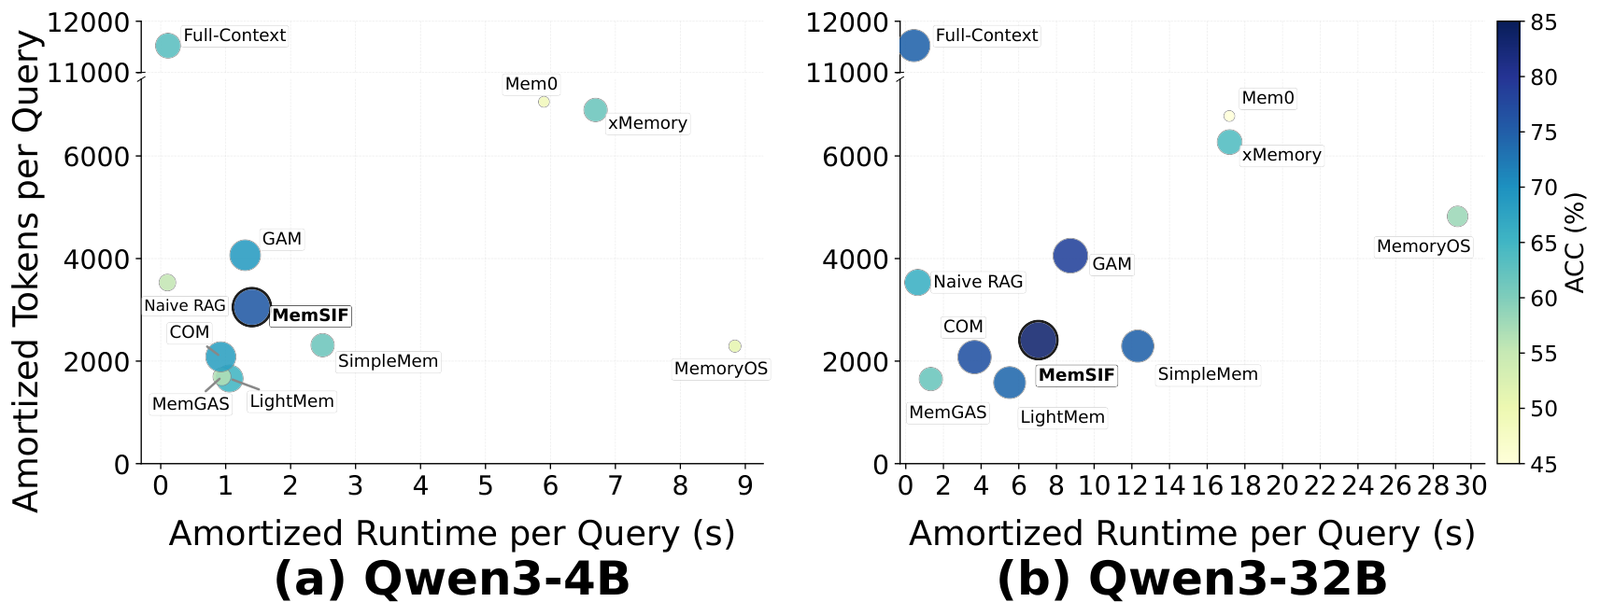
在涉及工业部署的长期记忆系统中,单纯堆叠检索深度来换取准确率往往不具备可行性。例如查询期深挖代表性方案 GAM,虽然能通过递归检索捞起长程碎片,但其开销随着交互轮数增加而陡峭攀升。
论文对整个运行链路(涵盖记忆构建、维护、检索至最终生成)的平摊 Token 消耗与单次查询延迟进行了端到端评测。如图 5 所示,在 Qwen3-32B 基座下,MemSIF 的每查询平摊 Token 消耗仅为 2.41K,比 GAM(4.06K)降低了足足 40.6%,同时准确率从 77.21% 反超至 82.99%;而与同样注重紧凑表示的 SimpleMem 相比,在相近的 Token 预算下,MemSIF 实现了 8.38% 的精度飞跃,并将运行时单次响应耗时从 12.31 秒压低至 7.04 秒,降幅达 42.8%。
这套效率优势的底层逻辑在于:CoreFact 将大量高频基础信息锁死在极其紧凑的标准三元组中;ActiveFact 则将原本在多次提问中需要重复从底层交互里“重演深挖”的线索直接升格为一劳永逸的事实条目。两次以上的相似查询,即可触发持久记忆命中,从而大幅砍掉了冗长的原始文本回溯。
走向有生命力、会演化的 Agent 记忆系统
长期以来,业界对 Agent 长期记忆的研究容易陷入一种惯性思维:要么依赖更长上下文窗口的暴力硬塞,要么将其当作传统的非结构化文档库,依靠高维向量索引打底。然而,人机对话是一条有生命、有因果关联且信息价值非对称的时间流,单纯的文本检索无法填平“时空错配”与“价值滞后”这两条鸿沟。
MemSIF 的理论价值在于,它系统性地提炼并形式化了 TSM 与 DUM 这两种长期记忆的核心失效模式,并通过一套严谨的拓扑重组与双轨演化机制完成了落地验证。它表明,优秀的记忆系统绝不应当是简单的“交互记录仪”或“静态数据库”,而必须能够理解事件的发展脉络,并具备伴随用户提问动态沉淀认知的能力。
从工程落地的视角看,这种“以话题和轨迹重整交互、以双轨兼顾稳态与动态沉淀”的解耦思路,为开发长生命周期、具有真正连续陪伴感与复杂协同能力的 AI Agent,提供了一个高准确率、低运行损耗且可复现的记忆中枢参考样本。