CAST:用求解器做轮次导师,无Logit蒸馏让大模型决策胜率提升17%
CAST: Game Solvers as Turn-Level Teachers for LLM Agents
让大语言模型走出被动文本生成的象牙塔,进入动态环境中担当自主决策的智能体(Agent),已经成为当前学术界与工业界最受关注的演进方向之一。从具身导航、复杂工具调用到多回合策略交互,智能体必须在随时间推移、状态不断演化的复杂世界里持续行动。然而,这类长程决策环境存在一个极为致命的特性:前期的决策失误往往要在很多步之后才会暴露恶果,且大多数错误动作一旦做出便无法挽回。
ArXiv URL:https://arxiv.org/abs/2607.25308v1
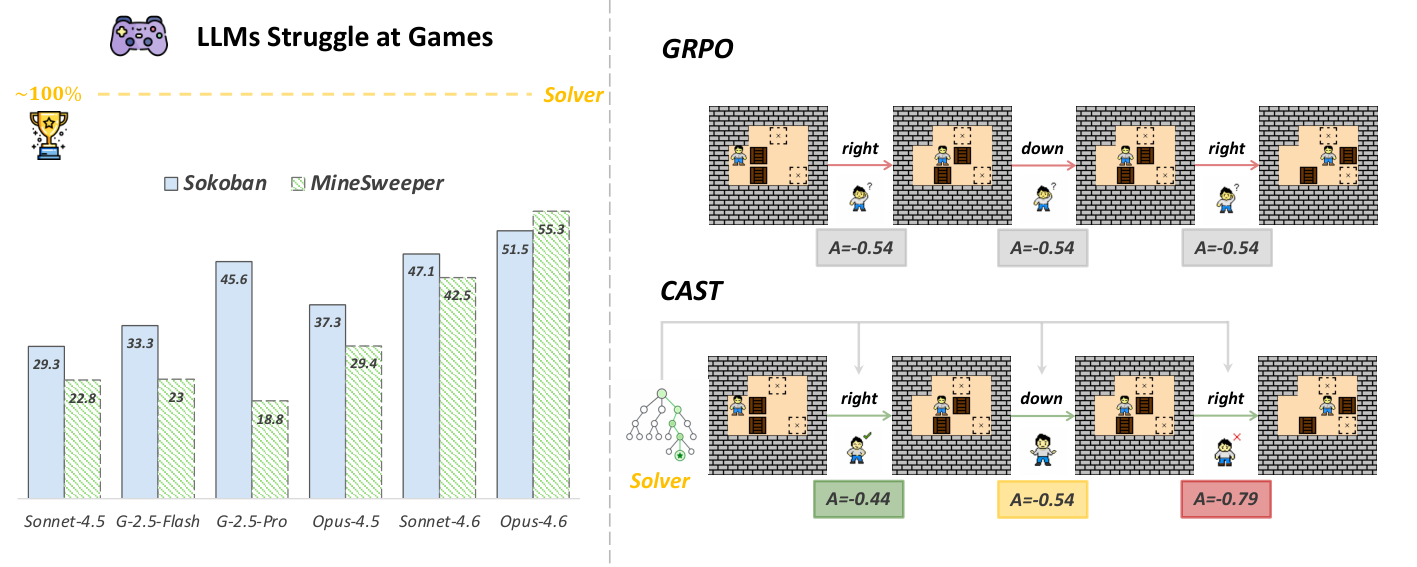
针对推理和决策任务,基于可验证奖励的强化学习(RLVR,如 DeepSeek 使用的 GRPO 以及近期提出的 DAPO 等)在单轮或短程任务中表现亮眼。但一进入需要几十步甚至上百步探索的长程游戏或真实交互中,RLVR 便陷入了严重的“信用分配(Credit Assignment)危机”。环境在终局只能给出一个 0 或 1 的输赢信号;在一条包含上百个 Token 与数十个决策轮次的轨迹中,模型完全无法得知究竟是哪一步的神来之笔锁定了胜局,还是哪一次的漫不经心导致了全盘崩溃。
来自美团、南京大学、中国科学技术大学与武汉大学的研究团队在最新论文中提出了名为 CAST(Credit Assignment from Solver Teachers) 的全新框架。研究团队敏锐地意识到:在推箱子(Sokoban)、扫雷(Minesweeper)、华容道/堵车拼图(Rush Hour)等经典长程问题中,通用大模型表现孱弱,但人类早已为这些领域开发出了高效的专用求解器(Solver)。这些求解器能够精确评估任意中间局面的“剩余成本(Cost-to-go)”。
CAST 将游戏求解器重塑为轮次级(Turn-level)的“实时导师”,利用求解器在动作前后的状态价值差计算出步级优势,直接注入 RLVR 训练管线。更重要的是,作者在理论上严格证明了:在软最优假设下,最大化这种标量优势在数学上完全等价于针对求解器的在策略蒸馏(On-Policy Distillation, OPD),从而突破了传统大模型知识蒸馏必须依赖教师模型输出完整词表 Logits 的限制。实验表明,在 Qwen3-4B-Instruct 基座上,CAST 在所有测试游戏中域内平均胜率达到 62.1%,大幅超越基准 17 个百分点以上,同时零样本泛化至具身与网页任务,展现出求解器赋能大模型的巨大潜力。
终局奖励的贫血症:长程交互中的信用分配困境
在强化学习的形式化框架下,多回合游戏通常被建模为有限时域马尔可夫决策过程(MDP)。大语言模型策略 $\pi_\theta$ 根据当前环境状态的文本表示 $s_t$,自回归采样输出动作 $a_t$,环境依据转移概率演进到下一状态 $s_{t+1}$,直至步数耗尽或游戏终结。
在 RLVR 设定下,外部环境所能提供的奖励是极其稀疏且延迟的:
\[r_t = 0 \quad (t < T), \qquad R(\tau) = r_T = \mathbf{1}\{s_T \in \mathcal{S}_{\text{solved}}\}\]为了省去训练额外价值网络(Critic)的庞大开销,当前主流的 RLVR 算法普遍采用分组相对策略优化(GRPO)这类基于轨迹组的优势估计方案。GRPO 会对同一个初始环境采样 $G$ 条完整交互轨迹,随后依据它们最终的成败回报计算轨迹级优势 $\hat{A}^{\text{outcome}}_i$。然而,这种优势是整条轨迹同质化的:无论该轨迹包含 10 个轮次还是 50 个轮次,轨迹中的每一个决策动作甚至每个生成的 Token,都被强行赋予了完全相同的标量反馈。
这种粗粒度信用分配在逻辑推理等短程任务上尚可应付,但在需要严密回溯与规划的动态环境中几乎必然失效。如果一条失败轨迹在第 30 步才因为致命失误踩雷,但前 29 步都处于高水准的探索中,整条轨迹却会被统一判定为负向更新;反之,在一条靠运气过关的冗长轨迹中,中间大量的无效甚至低级操作也会被无差别强化。
为了打破这一瓶颈,学术界曾探索过通过昂贵的蒙特卡洛树搜索(MCTS)寻找高价值分支、训练专门的过程奖励模型(PRM),或是利用跨轨迹状态对比(如 GiGPO)来构建步级信号。然而,这些方法要么计算开销过于高昂,要么 PRM 本身极易受到分布外漂移的幻觉干扰。如果直接让大语言模型在求解器生成的专家轨迹上做有监督微调(SFT),模型又只能见到完美状态,一旦在自主交互中产生微小偏差脱离专家分布,就会彻底丧失纠偏能力。这种“探索与精准指导不可兼得”的死结,正是 CAST 试图切开的核心切口。
求解器化身轮次导师:从 Cost-to-go 到平移优势
CAST 的突破点在于重新定义求解器在大模型训练中的定位:求解器不应该只用来在离线阶段造数据,而应该作为强化学习交互循环中的“裁判兼导师”。
任何合格的领域求解器(无论是基于 A* 搜索、约束满足算法还是反向广度优先搜索),天然具备一个关键特性:给定任意合法或中途偏离的局面状态 $s$,它都能计算出从该状态通向终局胜利所需的最小工作量,即剩余成本(Cost-to-go),记为 $N(s)$。在推箱子或 Rush Hour 中,$N(s)$ 是达到通关所需的最少动作步数;在扫雷中,它则是揭开所有安全格子所需的剩余翻牌数。
顺理成章地,求解器的状态价值可以形式化为负的剩余成本:$V^{\pi_{\text{Solver}}}(s) = -N(s)$。当大模型在状态 $s_t$ 自主生成并执行动作 $a_t$,转移到下一状态 $s_{t+1}$ 时,该动作在求解器眼中的优势函数 $A^{\pi_{\text{Solver}}}(s_t, a_t)$ 即可表达为:
\[A^{\pi_{\text{Solver}}}(s_t, a_t) = -1 + N(s_t) - \mathbb{E}_{s_{t+1}}[N(s_{t+1})]\]在求解器自身的理想路径上,每走一步都会使剩余成本恰好减少 1,此时 $N(s_t) - N(s_{t+1}) = 1$,代入上式会发现其优势恒等于 0;而任何次优的行动都会导致优势为负。为了让学习信号更加符合人类与强化学习算法的直觉认知——即“实质性推进行动应当获得正向激励”,研究团队引入了一个极为自然的 $+1$ 偏移,构建了平移求解器优势(Shifted Solver Advantage):
\[\widetilde{A}^{\pi_{\text{Solver}}}(s_t, a_t) = A^{\pi_{\text{Solver}}}(s_t, a_t) + 1 = N(s_t) - \mathbb{E}_{s_{t+1}}[N(s_{t+1})]\]这个公式展现出了极其清爽的物理含义:它直接对应于动作所带来的剩余成本降幅。如果模型走出一步将死局盘活或大幅推进目标,它会获得显著的正向信用;如果是在原地空转或做无效操作,得分归零;如果走出了让局势恶化、甚至让原本 5 步即可解开的局面拉长到 15 步的昏招,则直接赋予负分信用。对于直接导致游戏不可解的“死局(Dead State)”,求解器将直接赋予其 $-N(s_t)$ 的截断惩罚,直截了当地惩戒这一步抹杀了原本唾手可得的胜利。
破解蒸馏边界:Logit-Free 在策略蒸馏的数学等价
将外部求解器的优势信号拼接到策略梯度中并不罕见,但 CAST 最引人注目的理论贡献,是揭示了这一启发式操作背后严谨的数学本质。
在传统的知识蒸馏范式中,无论是离线蒸馏还是在策略蒸馏(On-Policy Distillation),学生模型为了模仿教师,都必须获取教师在当前词表上的完整概率分布(Logits),进而通过最小化 KL 散度进行对齐。但在现实中,无论是专用算法、物理仿真引擎还是基于搜索的启发式程序,它们在输出端都只是一个确定性动作或一个标量分数,根本不存在对应于自回归大模型词表的 Token 级 Logits 分布。
CAST 证明,在软最优(Soft-optimal)求解器假设下,求解器隐含的动作概率分布 $\pi_{\text{Solver}}(a \mid s)$ 会以温度 $\tau$ 与动作价值呈指数关系,即满足玻尔兹曼分布:$\pi_{\text{Solver}}(a \mid s) \propto \exp(Q^{\pi_{\text{Solver}}}(s,a)/\tau)$。由此可直接推导出:
\[A^{\pi_{\text{Solver}}}(s,a) = \tau \log \pi_{\text{Solver}}(a \mid s)\]换言之,求解器的标量优势值在数值上严格正比于求解器自身概率分布的对数项。作者由此给出了核心定理证明:在策略梯度更新中,将平移优势加权注入策略梯度的做法,在数学上等价于在优化真实任务回报的同时,联合最小化大语言模型当前策略与求解器隐式分布之间的交叉熵:
\[\mathcal{J}(\theta) = \mathbb{E}_{s_0 \sim \mu}\big[V^{\pi_\theta}_{\text{task}}(s_0)\big] - \beta \mathbb{E}_{s \sim d^{\pi_\theta}}\big[\mathrm{H}\big(\pi_\theta(\cdot \mid s), \pi_{\text{Solver}}(\cdot \mid s)\big)\big]\]这个等价性结论具有极其重要的实践指导意义:它宣告了无需 Logit 的在策略蒸馏(Logit-free OPD)是完全成立的。算法无需迫使外部专家生成昂贵的词表分布,仅凭一个在状态转移前后采样的标量差值,就能驱动大模型策略朝教师分布靠拢。
更为深刻的是,由于目标函数中同时保留了环境的真实终局回报项(Task Return),学生模型的最优策略解呈现为 $\pi^*(a \mid s) \propto \pi_{\text{Solver}}(a \mid s) \exp(A^{\pi_\theta}_{\text{task}}(s,a)/\beta)$。这意味着求解器的策略仅作为底层的结构化先验,当真实任务奖励在特定路径上带来更高收益时,指数项的存在允许学生模型打破先验约束,走出超越求解器预设路径的更优解,避免了传统蒸馏中“学生上限受死于教师水平”的宿命。
信号整形艺术:如何驾驭跨域量纲与重尾梯度
尽管在理论上无懈可击,但直接将原始的 $\widetilde{A}^{\pi_{\text{Solver}}}$ 塞进强化学习梯度却会引发灾难性的训练震荡。其根源在于两个工程现实:
-
重尾分布与极端离群值:在绝大多数合法步态下,步长变化仅在 $-1, 0, +1$ 徘徊;然而一旦触发死局,惩罚项 $-N(s_t)$ 会瞬时放大至数十分,个别离群梯度足以冲垮整个优化步。
-
跨任务量纲失调:极简关卡的初始总步长只有个位数,而复杂棋盘的总步长可达几十步,导致不同批次、不同关卡间的梯度方差极大。
针对这一问题,CAST 设计了一套极其克制但精妙的双层信号整形(Shaping)机制,彻底解决了数值稳定问题:
首先是采用反双曲正弦变换($\operatorname{asinh}$ 压缩):
\[g(x) = \operatorname{asinh}(x) = \ln\big(x + \sqrt{x^2 + 1}\big)\]$\operatorname{asinh}$ 的迷人之处在于其非线性几何特性:当输入接近 0 时,其一阶导数接近 1,完全保持了常规微小优势信号($-1, 0, +1$)的线性分辨率;而当输入值急剧膨胀时,它迅速平滑过渡至对数衰减区,将几十甚至上百的死局极值自然平抑,在理论层面这等价于对原本脆弱的 KL 约束施加了一层鲁棒化包络。
其次是引入批次级均方根归一化(Batch-level RMS Normalization):
\[h(x) = \frac{g(x)}{\mathrm{RMS}_{\mathcal{B}}(g) + \epsilon}, \qquad \mathrm{RMS}_{\mathcal{B}}(g) = \sqrt{\frac{1}{\lvert \mathcal{B} \rvert}\sum_{(i,t)\in\mathcal{B}} g\big(\widetilde{A}^{\pi_{\text{Solver}}}_{i,t}\big)^2}\]这里隐藏着一个极易被忽视但至关重要的设计取舍:归一化时只除以 RMS,绝对不减去均值(Mean)。在传统的标准化操作(如 Z-score)中,中心化(减均值)是标配;但在信用分配的语义里,数值“0”具有不可替代的物理锚点含义——它代表“不产生任何进展”。如果强行减去批次均值,就会在全局表现不佳的批次中把实际上毫无建树的“0 分动作”硬生生抬高为正奖励,破坏了正负反馈的逻辑界限。通过保留绝对原点的 RMS 缩放,不同游戏和批次的信号尺度被无缝校准至统一范数之下。
最终,成型后的步级优势以可控权重 $\alpha$ 与 GRPO 的终局轨迹优势线性相加:
\[\hat{A}_{i,t} = \hat{A}^{\text{outcome}}_i + \alpha \, h\big(\widetilde{A}^{\pi_{\text{Solver}}}_{i,t}\big)\]该式形成了优雅的三层粒度统一:$\hat{A}^{\text{outcome}}i$ 锚定轨迹级成败底线;$h(\widetilde{A}^{\pi{\text{Solver}}}_{i,t})$ 刻画轮次级动态信用;随后在反向传播中广播至该轮次的每一个 Token,无缝兼容现有的主流大模型训练框架。
实验与泛化:域内碾压、加速收敛与零样本迁移
为了验证 CAST 的实效,研究团队在三个具有代表性且各具挑战的长程博弈环境中展开了评测:推箱子(Sokoban,长程空间规划与不可逆操作)、扫雷(Minesweeper,部分可观测概率推理)以及 Rush Hour(受限网格下的组合图搜索)。基座模型统一采用开源性能领先的 Qwen3-4B-Instruct-2507。
在实验设置中,评估不仅覆盖了训练中所见的关卡难度(In-Domain, ID),更严格设置了训练中从未暴露过的更高难度级别(Unseen-Difficulty),每种设置均基于 4 次独立采样求平均胜率(Avg@4)。
在域内与未见难度的评测中,CAST 展现了近乎统治级的性能。未微调的原始 4B 基座在这些长程游戏中平均胜率仅有 16.6%(ID)和 5.9%(Unseen)。在经过相同样本与终局奖励训练的前提下:
-
经典的纯结果强化学习算法 GRPO 的 ID 平均胜率达到 44.9%,DAPO 达到 44.7%,引入了跨轨迹对比的过程级基线 GiGPO 也仅达 45.4%;
-
CAST 一举将全任务 ID 平均胜率推升至 62.1%,相比 DAPO 实现了 17.4 个百分点的绝对飞跃;而在严苛的未见难度下,CAST 依然拿下了 28.4% 的平均通关率,大幅领先基线近 10 个百分点;
-
在极度考验概率推演的扫雷环境中,CAST 的 ID 胜率跃升最为剧烈,较最强训练基线净增 14.9 分;
-
这一训练后的 4B 小模型,在同等测试条件下甚至直接击败了以零样本 ReAct 运行的 Gemini-2.5-Flash(58.7%)和 Claude-Sonnet-4.5(50.4%)。
更令人瞩目的是其在样本效率层面的改变。分析训练动力学曲线可以清晰发现,CAST 达到 DAPO 经过数十万样本才能触达的峰值胜率,在推箱子、扫雷和 Rush Hour 上分别只消耗了其 60%、50% 和 58% 的训练步数。这意味着由于消除了稀疏奖励下的盲目随机试错,求解器的介入带来了高达 1.7 到 2.0 倍的显著训练加速。
更深层的疑问是:在特定棋盘游戏中被求解器“带出来”的模型,是否仅仅记住了特化的下棋技巧,反而丧失了通用智能?
研究团队直接将训练好的模型在不加任何微调的情况下,投入完全无关的开放领域智能体基准——具身交互评测 ALFWorld 和电商网页交互评测 WebShop 中进行零样本跨域迁移(Zero-shot OOD Transfer)。
结果令人惊喜:在 ALFWorld 上,CAST 取得了 37.9% 的平均成功率;在 WebShop 上达到了 22.7%,整体跨域平均胜率达到 30.3%,高出所有纯终局奖励训练基线 5.6 个百分点以上。这有力地佐证了一个假说:在结构化求解器的步级严密监督下,模型所汲取并强化的并非简单的局部操作特征,而是一整套诸如“目标导向的状态回溯”、“步步为营的谨慎前瞻”以及“受挫后的局部纠错”等通用的长程决策底层逻辑元能力。
在消融实验与实用性分析中,作者进一步厘清了工程落地的疑虑。在消融掉 $\operatorname{asinh}$ 变换或减去均值后,模型性能均发生肉眼可见的跌落,甚至在训练初期暴发梯度发散;而在运行开销上,得益于高度优化的求解器实现,求解器带来的推理计算时间几乎被完全掩盖在 LLM 本身的自回归前向传播耗时之下。更为关键的是,即便在没有精确全局解析解的复杂场景下,使用一个预先在小规模数据上训练好的近似神经价值网络(Value Network)充当近似求解器,CAST 依然能够保留绝大部分的性能增益,为更宽广的实际应用铺平了道路。
总结与展望:符号世界对大模型的真正反哺
CAST 这项工作之所以引人深思,在于它为当下大语言模型强化学习提供了一条跳出“死磕端到端黑盒”的全新思考路径。
近一年来,业界在提升模型推理能力时,极度依赖于单纯通过大规模强化学习让模型进行“暴力试错(Brute-force rollouts)”。这种范式在解答数学竞赛题等具有单步验算性质的问题上收效显著,但在涉及多状态级联转移、包含巨大状态空间与不可逆陷阱的通用 Agent 任务中,由于信用分配链路过长,单纯的端到端学习极易演化为高方差的算力黑洞。
CAST 证明了一件非常关键的事:人类在过去数十年计算机科学中所积累的经典符号系统、精确求解算法与搜索启发式,绝非大模型时代的被淘汰遗产,而是大模型通往长程交互彼岸时最理想的高阶裁判与导师。
通过将求解器的状态价值跃迁严谨地数学映射为 Logit-free 在策略蒸馏,CAST 既保留了强化学习对于全新路径的自主探索自由度,又在每一个决策微步上为模型构筑了一条平滑坚固的“安全护栏”。这一范式不仅限于棋盘游戏,在未来的代码多轮自动化演进、硬件芯片 EDA 综合布局、复杂软件工具链协同等诸多具有已知局部约束或传统启发式验证器的真实业务场景中,这种“求解器指路、大模型决策”的协同模式,或许正是化解复杂智能体可靠性瓶颈的解题钥匙。