GAMER:解耦记忆与搜索,动作中心图让智能体成功率提升20.81%
Bridging Inference-Time Scaling and Episodic Memory with Action-Centric Graphs
推理时计算扩展(Inference-time Scaling)是近期大语言模型(LLM)实现复杂推理跃升的核心引擎。无论是在数学推导中大放异彩的思维链(CoT)、思维树(ToT),还是在测试阶段通过多路径采样与验证的 Best-of-$N$ 策略,都证明了一个朴素的法则:让模型在测试阶段“多想一会儿”,推理性能就能跨越式增长。然而,当这种范式被移植到需要长程规划与环境交互的智能体(LLM Agent)任务时,却遭遇了严重的计算内耗。
ArXiv URL:https://arxiv.org/abs/2607.27415
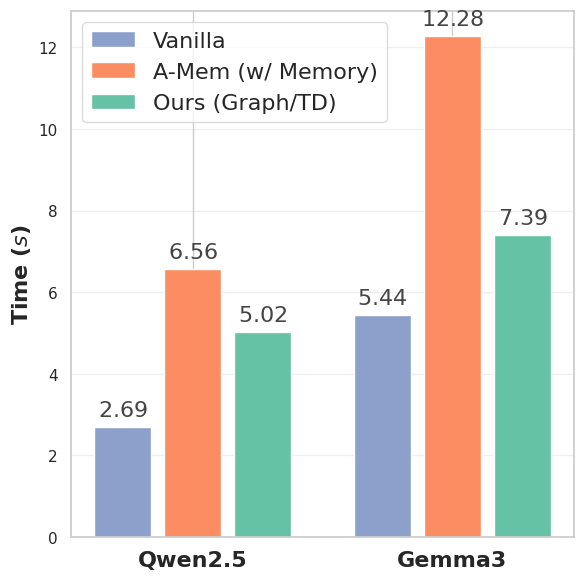
最致命的瓶颈在于智能体的无状态性(Statelessness)。现有的推理搜索算法几乎每次面对新任务都要从零构建搜索树,哪怕眼前的问题与几分钟前刚刚解决或失败的任务在逻辑结构上高度同构,智能体依然像患了“失忆症”一样,盲目地在庞大的动作空间中重新探索、重新试错、重复验证无效路径。现有的智能体记忆机制(如 A-MEM、G-MEM 等)试图通过长文本记忆库或知识图谱来弥补缺陷,但它们本质上停留在“上下文增强(Context Augmentation)”的范畴——智能体只是在 Prompt 里强行塞入了长篇累牍的过往历史文本,依然需要消耗昂贵的大模型推理 Token 去通读、理解并重新推导中间步骤,既无法从底层剪枝搜索空间,又带来了沉重的成本与延迟负担。
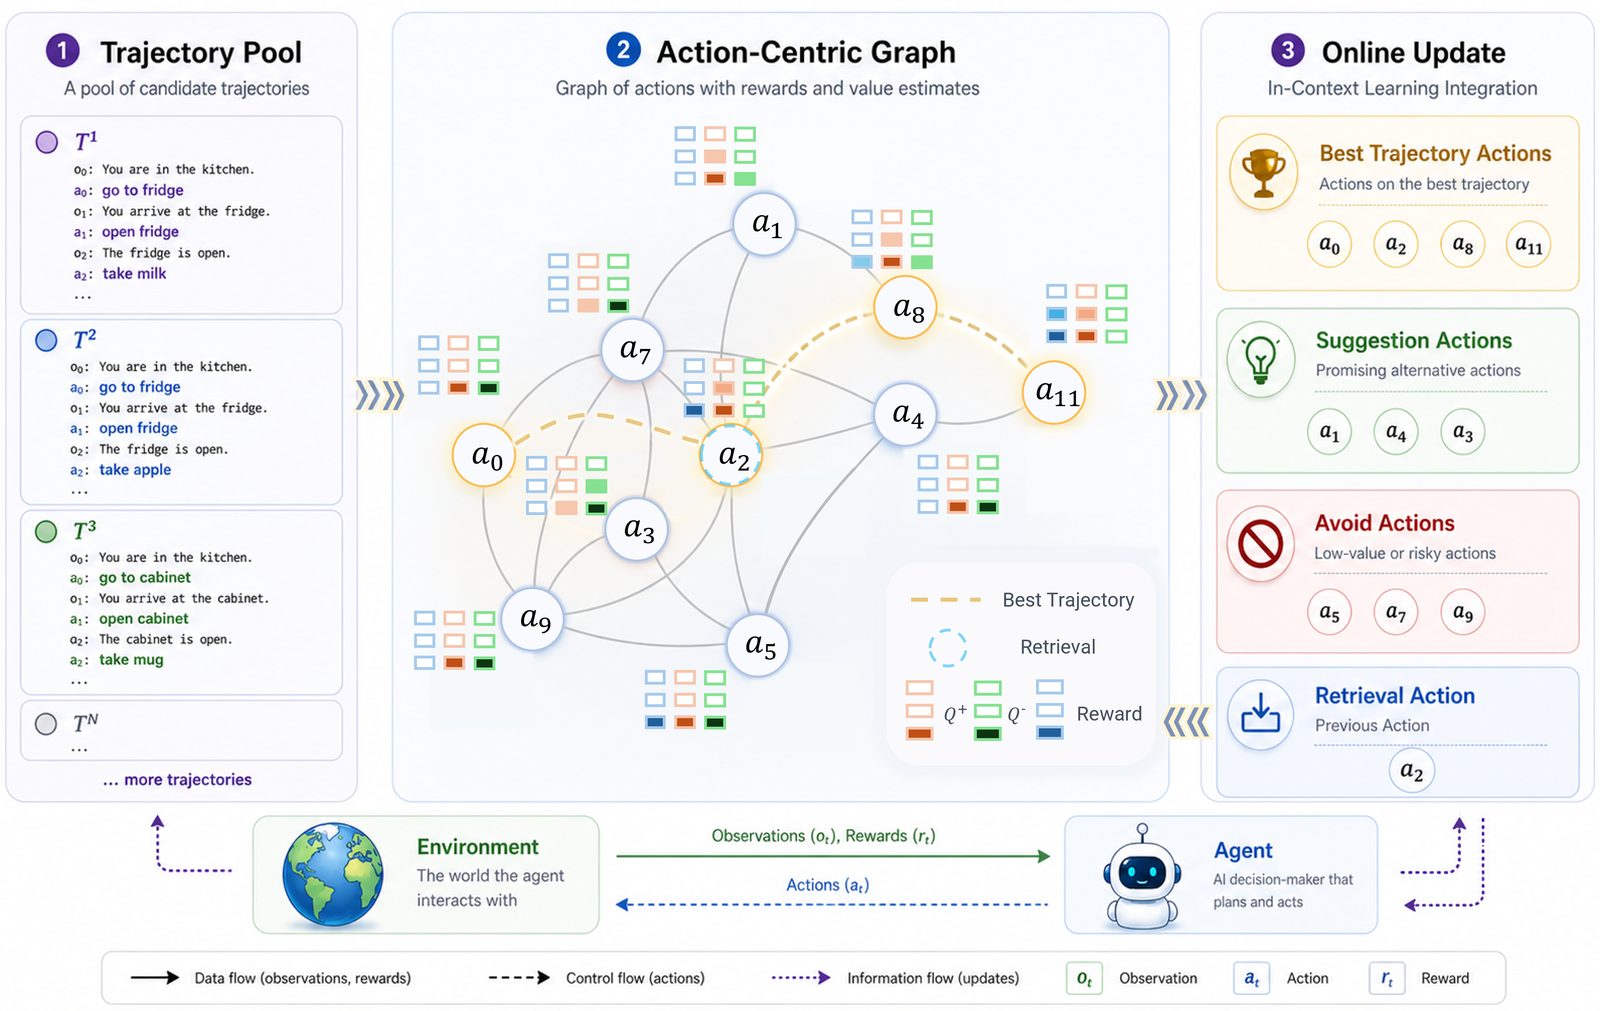
针对这一系统性困境,一项名为 GAMER(Graph-based Action-centric Memory with Episodic Reasoning)的研究提出了全然不同的解题思路。该框架将情景记忆机制从大模型的自回归生成中彻底解耦出来,把智能体的历史探索轨迹抽象为一张动态演进的以动作为中心的图(Action-Centric Graph)。更关键的是,研究者引入了强化学习中的双流时序差分(Dual-Stream Temporal Difference, TD)学习机制,分别从成功经验中提炼“推荐价值”,从失败惩罚中沉淀“避雷指标”。
在测试推理阶段,GAMER 能够以极低的 Token 成本向大模型输入双向约束:既给出高概率成功动作建议,又立起阻止踏入历史陷阱的“软屏障”。实验数据显示,在多个跨领域智能体基准上,GAMER 在推理扩展设定下相比无状态基线实现了 20.81% 的成功率提升与 6.17% 的进度率提升;在具身控制基准 AlfWorld 上,成功率更是跳升了 53.17%,展现出兼顾计算效率与决策精度的显著优势。
从“读日记”到“看路标”:记忆机制范式的代际转移
为了理解 GAMER 为何能大幅削减内耗,必须先看清现有 Agent 记忆方案与推理扩展结合时的结构性矛盾。
以往为 Agent 赋予记忆的尝试,大致可以归为两类逻辑:一类是工作流或单元抽象模式(如 AWM、ReasoningBank),试图用大模型把历史轨迹蒸馏成可复用的高阶策略;另一类是向量数据库或知识图谱检索(如 A-MEM、G-MEM),在推理前将相关的历史对话或实体关系注入到上下文中。
这两条路线虽然提高了某些单次生成的准确率,但放在推理时搜索(Inference Scaling)的场景下,缺陷被急剧放大。首先,知识提取和解析极度依赖大模型本身的深层推理,Agent 每走一步,上下文里就要塞入大量静态文本描述,导致 Token 消耗随搜索步数呈指数级膨胀。其次,传统的上下文检索只负责“提供事实”,不负责“优化拓扑”。哪怕模型检索到了类似任务的成功日志,在当前步骤的展开式搜索中,它依然不知道下一层分支哪些节点存在致命死循环,依然需要在当前状态下采样多条路径去逐一验证。换言之,现有的记忆是被动陈列的“档案日记”,Agent 依旧要在庞大的迷宫里瞎碰。
GAMER 的核心转变,是把被动文本记忆转化为主动的拓扑图谱,将“语言检索”降维为“图节点价值查询”。作者团队发现,在不同的人机交互、具身控制或代码生成任务中,虽然自然语言描述千差万别,但底层的动作转移逻辑与子目标推进序列却具有高度的结构同构性。
因此,GAMER 将整个决策空间建模为有向图 $\mathcal{G} = (\mathcal{V}, \mathcal{E})$。图中的每一个节点 $v \in \mathcal{V}$ 并不存储冗长的状态描述,而是代表一个离散的具体动作(Action);有向边 $e = (v_i, v_j) \in \mathcal{E}$ 则代表动作之间的时序继发依赖关系。当智能体不断与环境交互,新的动作序列被归并进这张大图,分支节点自然对应着历史上面临策略抉择的分叉口,而图中的环路则直观揭示了无效的震荡或递归陷阱。这种以动作为核心的图拓扑,直接切断了大模型在记忆提取环节的算力绑定,使得记忆的更新与路由可以在轻量级图结构上独立运算。
双流 TD 学习:让成功指路,让失败筑墙
仅仅把轨迹连成一张拓扑图,只能解决连通性问题,无法说明每一个动作在当前情境下的优劣。如果无差别地参考历史图谱,Agent 依然无法避开曾经走过的死胡同。为此,GAMER 借鉴了强化学习中的免模型时序差分学习(Temporal Difference Learning),设计了一套双流价值估计网络(Dual-Stream Value Estimation)。
在许多长程任务中,任务往往只有在终点才能拿到稀疏的奖励(Sparse Reward),如果等待整个任务结束再通过蒙特卡洛方式反向回传,不仅方差极大,而且在轨迹较长时难以对前期的关键动作准确定责。时序差分学习通过后继状态的估计值来更新当前状态,能够高效平滑地进行单步反传。GAMER 将这一思想拓展为正向流($Q^+$)和负向流($Q^-$)两个互不干扰的价值通道:
\[\delta_{t} = r_{t} + \gamma \cdot \mathbb{E}[Q(v_{t+1})] - Q(v_{t})\]正向价值流 $Q^+$ 聚焦于历史成功经验,目标是量化一个动作节点朝向最终成功的推进潜力。当某条轨迹最终达成目标并获得正向奖励时,正向回报信号会沿着动作拓扑逆流而上,赋予关键节点更高的正向分值。
与常规强化学习不同的是,GAMER 对失败轨迹的处理极为精细。在很多 Agent 场景中,导致任务彻底崩塌的往往不是全局策略的偏差,而是某一个非法的、破坏性的局部动作。为了把这类“灾难性节点”永久标记出来,GAMER 引入了独立的惩罚信号定义:
\[r^{-}_{t} = \begin{cases} -1 & \text{if } r_{t} < \epsilon_{r} \\ 0 & \text{otherwise} \end{cases}\]只要某一步的即时反馈跌破阈值 $\epsilon_{r}$,或者整条轨迹归于失败,负向奖励流就会被激活。系统通过独立的贝尔曼更新方程,维护负向价值网络 $Q^-$:
\[Q^{+/-}(v_{t}) \leftarrow Q^{+/-}(v_{t}) + \alpha \left[ r^{+/-}_{t} + \gamma \operatorname*{\max/\min}_{v^{\prime} \in \text{Succ}(v_{t})} Q^{+/-}(v^{\prime}) - Q^{+/-}(v_{t}) \right]\]其中 $\text{Succ}(v_{t})$ 表示当前动作节点在图中的所有后继节点集合。
这一双流设计的巧妙之处在于,它把对经验的学习变成了非对称的概率调制器。$Q^+$ 负责构建向心力,引导 Agent 顺着高置信度的骨干路径快速突进;$Q^-$ 负责构建离心力,作为一道“软性屏障”,在 Agent 即将滑向已知的死局或非法操作时及时踩下刹车。两套价值分布并行更新,使一张原本冰冷的动作转移图,演变成了一张标注着坦途与暗礁的动态航海图。
双向概率重塑:如何在推理搜索中高效引导大模型?
在大语言模型的推理引导落地层面,GAMER 并没有采用强行修改 Logits 这种对黑盒 API 极不友好的侵入式做法,而是优雅地利用大模型的上下文学习能力(In-Context Learning),将图谱中计算出的数值信号转化为精准的自然语言控制指令。
在面对全新任务时,系统首先从历史轨迹池 $\mathcal{D}_{pool}$ 中检索出一条与当前目标最为契合的高质量完整轨迹 $\tau^*$ 作为全局参考。更关键的操作发生在局部的逐步决策过程中:
在每一步推理节点 $v_t$,GAMER 在动作图上检索当前节点的所有潜在后继动作 $\text{Succ}(v_t)$,并分别根据双流价值网络提取出两份极其精简的候选集合:
\[\mathcal{A}_{suggest} = \operatorname*{TopK}_{a \in \text{Succ}(v_{t})}\left(Q^{+}(a)\right)\] \[\mathcal{A}_{avoid} = \operatorname*{TopK}_{a \in \text{Succ}(v_{t})}\left(\vert{}Q^{-}(a)\vert{}\right)\]前者是正向价值最高的 $K$ 个建议动作,后者是负向惩罚最严重的 $K$ 个高风险动作。随后,系统将这两组精简的动作短语转化为结构化 Prompt,直接拼接进当步的输入中,例如:
WARNING: Based on analysis of unsuccessful trajectories, you should avoid these actions as they typically lead to poor outcomes: {$\mathcal{A}_{avoid}$}
从计算复杂度的角度来看,这种设计的 Token 消耗几乎微不足道。相比于传统 RAG 动辄贴入几千字的历史反思长文,GAMER 注入的仅仅是数个动作动词短语。然而正是这几个短语,从数学上深刻改变了大模型的生成采样分布。
论文在理论部分对该机制的有效性给出了严格证明。在形式化定义中,记忆引导机制被视作一个概率转移算子 $T: \pi_{base} \to \pi_{mem}$。由于注入了规避集合 $\mathcal{A}{avoid}$,模型在低回报动作区间上的概率质量被强行剥离;同时,由于注入了推荐集合 $\mathcal{A}{suggest}$,这些被剥离的概率质量被单调地重新分配到了高回报动作集合中。
由此,作者在理论上推导出了一阶随机优势(First-Order Stochastic Dominance)定理:在价值估计与真实环境奖励相对一致的温和假设下,受引导的策略分布 $\pi_{mem}$ 在累积回报分布上严格一阶优于基线策略 $\pi_{base}$(即 $X_{mem} \succeq_{1} X_{base}$)。
这一理论推导直接揭示了推理扩展效率的飞跃:对于任意给定的采样预算 $N \geq 1$,GAMER 的最大期望回报始终大于等于无状态基线;而要达到相同的目标回报置信度 $1-\delta$,GAMER 所需要的采样次数(Sample Budget)显著减少。无状态搜索下的盲目并行,在动作图的双向引导下收敛成了极具针对性的高效深潜。
跨基准实测:全场景性能跃升与超额收益
为了验证这一架构在真实复杂环境中的通用性,作者依托 AgentBoard 评测基准,在四个具有完全不同动态特性的交互环境中进行了全面考察:包含具身指令执行的 AlfWorld、模拟交互式复杂科学实验的 SciWorld、考查离散逻辑与符号规划能力的 PDDL,以及考验外部接口调用的 Tool-Query。骨干模型则覆盖了 Qwen、Llama 等四款主流开源与闭源 LLM,全面测试其在 Best-of-$N$ 推理扩展设定下的最终收敛能力。
在跨模型的平均指标上,GAMER 展现出了压倒性的优势。面对纯无状态搜索的 Vanilla 基线,GAMER 取得了平均 20.81% 的成功率提升与 6.17% 的进度率提升。如果将对比标杆拉到同样具备 Best-of-$N$ 搜索能力的强基线,GAMER 依然在成功率上稳步高出 15.4%,在进度率上高出 5.47%。这表明,GAMER 带来的增益并非来自于单纯增加采样算力,而是来自于算力消耗方向的质变。
细分各个任务领域的数据尤其耐人寻味:
在符号规划与具身控制这类动作空间高度结构化、动作逻辑具备严格前置后置依赖的任务中,GAMER 的威力被释放到了极致。在 AlfWorld 这一经典的具身决策基准中,GAMER 相比原始无状态搜索实现了高达 53.17% 的惊人成功率涨幅。这是因为在家庭起居这类环境交互中,Agent 极易陷入“打开柜门-关上柜门-反复查看”的死循环,或者在寻找目标物体时漫无目的地遍历无关容器。双流 TD 学习建立的负向避雷屏障,直接在 Prompt 层封死了这些历史冗余动作的可能性,将宝贵的搜索预算全部锁死在最可能推进目标的关键路线上。
而在 SciWorld 这种长程科学实验任务中,环境状态空间极其广阔,步数动辄数十步。GAMER 不仅在最终成功率(SR)上保持领先,在衡量任务完成深度的进度率(PR)上也显著拉开差距。这证明即便在无法彻底通关的极难长程任务中,基于图的局部推荐也能如同“路标”一样,稳定护送 Agent 突破浅层阻碍,向更深层次的实验环节推进。
消融分析:参数鲁棒性与冷启动边界
一项出色的框架不仅要上限高,还要下限稳。在针对超参数敏感性的消融实验中(见图 4),作者深入剖析了推荐动作数量(Top-$K$ Suggestions)与规避动作数量(Top-$K$ Avoidances)对系统最终表现的扰动情况。
实验结果展现了极其平稳的收敛面:无论是在 Qwen 还是 Llama 架构下,系统在相当宽泛的超参数取值区间内都维持着高水准的成功率,方差表现收敛。这一现象说明,大模型本身具有极高的语境理解弹性,无需针对特定任务严苛地微调超参数 $K$ 的具体数值——只要给出了明确的局部正向指引与负向边界,模型就能够自发结合当前状态完成高质量的决策过滤。
但任何脱离边界条件的赞美都是不客观的,论文作者在总结中非常坦诚地指出了 GAMER 目前存在的核心局限:对热启动(Warm-up)知识密度的依赖性。
从图 4 对热启动轨迹数量的分析可以清晰看出,动作中心图的威力建立在“拓扑网络已经覆盖了一定广度的可行与失败路径”这一前提之下。随着初始积累轨迹的增加,Agent 的性能曲线呈现稳步向上的健康走势。
然而反过来看,如果给定的热启动轨迹池极度贫瘠,图节点连通性脆弱且价值估计尚未收敛,系统可能会提取出带有偏差的局部极值。在极端缺乏探索经验的冷启动状态下,Agent 甚至可能因为被误导而陷入次优策略,表现一度跌破 Vanilla 基线。这意味着,GAMER 更像是一个为“常驻型智能体(Persistent Agent)”量身定制的高性能引擎,它最适宜的战场是那些需要长期服役、面对同类业务流反复执行任务的生产环境,而非完全随机、毫无经验积累的单次偶发场景。
结语:让推理算力花在刀刃上
推理时计算扩展是当前大模型进化的共识路径,但“算力扩展”绝不等于“算力浪费”。如果在测试阶段投入海量 Token,仅仅是在不断重复昨天踩过的坑、反复遍历显而易见的死胡同,那么这种 Scaling Law 的边际回报必将迅速递减。
GAMER 的核心启示在于,它没有一味去卷更大的上下文窗口,也没有强行要求大模型在自回归生成中扮演全能的记忆检索数据库,而是做了一次极为漂亮的工程与理论解耦:
用轻量但精准的有向图去沉淀动作拓扑,用成熟经典的强化学习时序差分算法去量化步步为营的风险与收益,最后再用极度精简的自然语言指令,把控制权优雅地交还给擅长泛化的大模型。
这种将经典符号控制与强化学习机制作为“前置减震器”和“导航仪”嵌入大模型推理扩展流的思路,不仅有效治愈了 Agent 在长程搜索中的健忘症,更为未来低成本、高可靠的智能体规模化落地,提供了一条极具说服力的进化样本。