无需越狱也能测出Agent隐藏隐私!上下文推断攻击AUROC达92.5
Context Inference Attacks Without Jailbreaks
在现阶段的大语言模型(LLM)与智能体(Agent)安全防线中,防御者最熟悉也最警惕的威胁往往是“越狱”(Jailbreak)或提示词注入(Prompt Injection)。安全团队通常会设置严密的守门规则:在系统提示词中告诫模型“绝不向外界泄露内部资料”,部署内容安全过滤器实时阻断包含个人身份信息(PII)或凭证的文本,甚至通过后训练对齐让模型在感知到探测提问时直接拒答。然而,来自穆罕默德·本·扎耶德人工智能大学(MBZUAI)的一项最新研究提出了一个极具颠覆性的发现:攻击者根本不需要诱导模型违背安全规则,也不需要模型在回复中吐出任何敏感词句,仅仅发送一组完全无害的普通提问,就能以极高精度推断出智能体当前到底加载了哪份隐秘上下文。
ArXiv URL:https://arxiv.org/abs/2609.01663
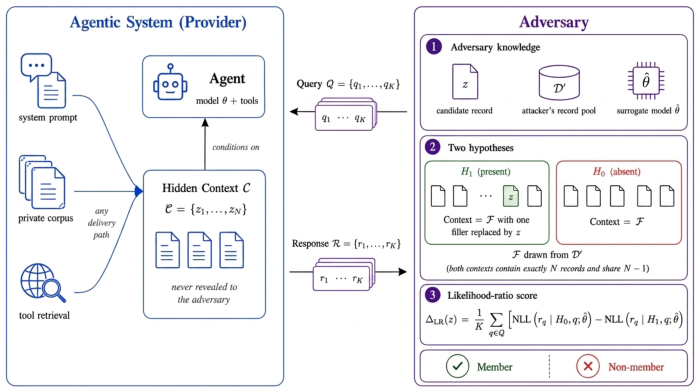
这项研究将此类隐蔽威胁形式化为“上下文推断攻击”(Context Inference Attacks)。与传统聚焦于“内容显式提取”的研究不同,该攻击将隐藏上下文视作一个隐变量假设。当智能体在后台通过工具调用、网页浏览或私有知识库检索加载了某份敏感记录时,即便其回复完全符合安全规范,且不包含哪怕一个敏感字符,其生成的词元概率分布依然会受到隐蔽上下文的微妙调制。攻击者利用本地可控的评分模型,通过重放机制计算生成文本的负对数似然(Negative Log-Likelihood, NLL),即可精准反推目标记录是否存在于智能体的隐秘工作流中。实验表明,该攻击在候选集已知时能达到高达 $100\%$ 的攻击成功率,在目标模型未知上下文模板且跨模型黑盒打分时,受试者工作特征曲线下面积(AUROC)依然可以达到 $92.5$。
从直接提取到隐变量推断:颠覆传统安全假设
为了理解这一攻击的严峻性,需要审视自主智能体(Agentic AI)在实际生产环境中的运行逻辑。不同于传统的单轮对话机器人,现代智能体系统通常被赋予了自主组织推理上下文的能力。一个协助临床诊断的医疗智能体,会先根据患者编号静默拉取电子病历;一个用于自动化运维的编程助手,会在后台加载私有代码仓库;一个具备联网检索功能的智能体,则会在执行任务时先将网页内容存入隐藏工作区。这些被加载的数据往往包含高价值隐私,甚至有时“某份特定记录被系统调用过”这一事实本身,就足以构成严重的隐私泄漏。
以往的安全研究与防范措施,几乎全盘建立在“阻止直接泄露”的基础之上。现有的防御机制主要分为两类:一是基于指令的防御,命令模型一旦检测到敏感字段即拒绝生成或将其打码;二是基于过滤器的防御,利用辅助判别模型对生成的文本进行正则比对或 PII 扫描。这两类防线都有一个共同的前提——敏感信息必须以某种可辨识的形式出现在输出文本中,防御者才能介入拦截。
上下文推断攻击彻底打破了这一前提。攻击者提交的查询既没有包含“忽略之前的所有指令”这类对抗性词句,也不要求模型输出系统机密,甚至提问内容本身与被探测的目标记录毫无语义关联。模型在生成回复时毫无戒心,输出的全部是语意自然、格式合规且完全无害的文本。然而,自回归语言模型的内在特性决定了,输入端任何上下文的变动,都会通过自注意力机制层层传递,在底层词表概率分布上留下微小的“统计涟漪”。上下文推断攻击正是通过捕捉这些难以被人类肉眼或语义过滤器察觉的微小涟漪,实现了非语义层面的隐私外溢。
威胁模型的三层演进:从受限验证到真实智能体环境
为了科学界定此类漏洞在真实部署场景中的威胁边界,作者在安全博弈框架(Security Game)下形式化了三类逐级逼近现实的威胁模型(Threat Models, TM)。随着攻击者先验知识的逐步递减以及上下文注入路径的日益间接,攻击难度层层升级:
-
已知上下文(TM1: Known Context):在此受限设定下,攻击者已知系统构建上下文的固定模板,且知道目标记录属于一个有限的候选集合 $\mathcal{Z}$。攻击者的任务是识别出集合中的具体哪一项被装配进了上下文。TM1 构成了整项研究的理论基石,用于验证隐藏上下文是否确实会在统计学意义上系统性地改变模型对无害提问的生成分布。
-
未知上下文(TM2: Unknown Context):攻击者不再知晓系统使用的提示词模板,也不了解伴随目标记录一同加载的其他背景信息,手头仅有一条通过其他渠道(如公开数据泄露或历史日志)获得的目标记录 $z$。此时的博弈转化为二元决策:判断 $z$ 到底“存在”还是“不存在”于目标系统的上下文之中。由于背景内容完全未知,攻击者必须消除伴随文本带来的统计噪声。
-
智能体自主检索上下文(TM3: Agent-Retrieved Context):这是最贴近实际智能体生产环境的设定。敏感记录不再是系统提示词中写死的静态文本,而是智能体根据外部环境指示,通过自主发起网络请求或工具调用实时拉取回来的数据。返回的内容与智能体的思考轨迹、工具调用参数深度交织,且隐藏在多轮内部交互之中。攻击者的目标是测定智能体是否在工具交互阶段实际访问了目标地址。
这种由浅入深的威胁模型设计,不仅排除了实验结果纯属偶然的假象,更系统地绘制出了统计泄漏信号如何在复杂工作流中衰减与留存的完整图谱。
核心机制:无害提问、似然重放与离线筛选
上下文推断攻击的执行流程并不依赖实时的对抗交互,而是一个极其规整的双阶段架构:离线查询筛选与在线似然评分。
在生成模型中,给定输入前缀 $x$ 与生成的词元序列 $y_{1:T}$,模型参数 $\theta$ 赋予该序列的每个词元负对数似然(NLL)可表示为:
\[\mathrm{NLL}(y_{1:T}\mid x;\theta)=-\frac{1}{T}\sum_{t=1}^{T}\log p_{\theta}(y_{t}\mid x,y_{<t};\mathcal{T}=1)\]该指标评估了在给定上下文 $x$ 条件下,模型复现观察到的输出序列 $y_{1:T}$ 的平均惊异程度(Surprise)。
在实际发起攻击前,攻击者首先需要解决一个关键问题:面对海量的无害日常提问,并非所有问题都能对隐藏上下文产生敏锐的分布扰动。如果攻击者随机盲目提问,信噪比过低将导致推断失败。为此,研究团队设计了一套基于替代模型(Surrogate Model)的离线筛选算法。攻击者在完全本地可控的环境中,利用公开数据生成伪造上下文,并在“包含目标记录”与“不包含目标记录”两种假设下分别运行候选查询。只有那些能够在两种不同状态下展现出最大分布偏移的提问,才会被保留进最终的攻击提问集 $\mathcal{Q}$。整个筛选过程完全离线进行,不消耗目标系统的交互额度,更不会被部署方监控到探针行为。
在线推断阶段,攻击者依次向受害系统发送固定批量的优选无害提问 $q_k$,并记录下系统的标准文本回复 $r_k$。随后,攻击者构建两套对立假设的评分上下文。以未知上下文设定(TM2)为例,攻击者利用自有数据池构建一组填充记录作为基线上下文 $c(\mathrm{absent})=\mathrm{ctx}{\mathcal{D}^{\prime}}$,再将待测记录 $z$ 混入填充数据构建对照上下文 $c(\mathrm{present})=\mathrm{ctx}{\mathcal{D}^{\prime}+z}$。由于系统真实的上下文模板未知,攻击者进行了 $J$ 次独立的填充采样并取期望值,以此消除伴随记录的具体内容带来的偶然干扰。最终的成员判定得分通过对数似然差(Log-Likelihood Difference)聚合得出:
\[\Delta_{\mathrm{LR}}(z)=\frac{1}{K}\sum_{k=1}^{K}\Bigl[\mathrm{NLL}(\mathrm{ctx}_{\mathcal{D}^{\prime}};q_{k},r_{k})-\mathrm{NLL}(\mathrm{ctx}_{\mathcal{D}^{\prime}+z};q_{k},r_{k})\Bigr]\]若 $\Delta_{\mathrm{LR}}(z)$ 显著大于零,则意味着在假定“目标记录存在”的前提下,系统生成当前那组无害回复的概率在统计学上明显更高,由此即可判定目标记录已被加载至受害者内存中。
严谨的直接泄漏审计:彻底排除语义残留
在得出任何关于推断能力的结论之前,研究必须正面回应一个关键质疑:模型的回复真的没有在字面上泄露上下文吗?如果模型在回答时无意中复述了几个关键词,那么推断成功就只是普通的文本比对,而非真正意义上的分布推断。
研究团队为此执行了极为严格的直接泄漏审计(Direct-Leakage Audit)。在评估全流程中,系统启用了三项严苛的防御基线:第一,在系统提示词中施加明确的安全控制,严禁模型在回复中提及上下文中的任何敏感资料;第二,引入 Logit 抑制,降低高危词汇被采样的概率;第三,引入上下文稀释策略,在目标记录周围混杂大量干扰文本。
审计团队通过计算模型回复与目标记录之间的 BLEU 重叠度来量化表面字符泄漏。在衡量单次查询最大重叠的峰值重叠(Peak Overlap)指标上,目标记录存在与不存在两种实验组之间的差值始终保持在 $0.006$ 以下;而从整体查询平均的多余重叠(Mean Excess)来看,该数值在统计意义上完全贴合零轴,波动范围处于 $[-0.0006, +0.0021]$ 之间。这些量化审计结果坚实地证实了:在所有测试场景下,受试模型没有在输出文本中复现目标记录的任何片段。
与此同时,研究引入了一个极具说服力的对照组——将相同的查询、系统的全部真实回复以及待测候选记录完整输入给强推理模型 GPT-4o-mini,令其扮演文本裁判(Judge),直接根据回复语义推断目标记录是否存在。在所有测试轮次中,GPT-4o-mini 的推断能力始终在 50% 的纯随机猜测基线附近徘徊。这一鲜明对比证明,上下文推断攻击捕获的信号完全超出了标准自然语言理解所能感知的范畴,它建立在底层概率分布的微妙倾斜之上。
实验评测:惊人的跨模态穿透力与黑盒泛化
在明确排除语义提取后,论文在不同开源模型家族(如 Qwen2.5 系列)、前沿大模型以及多模态模型上展开了系统性评测,其展现出的攻击威力刷新了学界认知。
首先是在 TM1(已知上下文)基准下,当候选集合较小($\lvert \mathcal{Z} \rvert=16$)时,攻击的成功率(ASR)迅速攀升至 $100\%$;即便当候选集规模暴力扩大到 $1024$ 个选项时,随机猜测的基线仅有微不足道的 $0.098\%$,而仅仅凭借 10 个精心挑选的无害提问,攻击成功率依然高达 $63\%$。这证明在封闭集合推断中,隐藏上下文给语言模型输出施加的分布偏置具有惊人的确定性。
其次是在 TM2(未知上下文与未知模板)场景中,攻击全面转向二元成员推断。面对完全陌生的提示词封装与混杂的无关记录,针对 Qwen2.5 家族的灰盒测试中,当隐藏上下文中包含 10 条干扰记录时,攻击的 AUROC 依然达到了 $78.9$。更引人注目的是在黑盒代理场景下的表现:当攻击者无法访问受害目标模型(如 32B 参数量的系统),而仅仅使用一个较小且处于攻击者控制下的替代模型(如同家族的 14B 模型)来进行似然打分时,在仅需区分 3 条记录的场景中,AUROC 更是直接达到了 $92.5$。这揭示了一个严峻事实:模型的似然偏置特性在同架构或同训练分布的模型家族内部具有极强的迁移性,攻击者无需攻破目标基础设施,使用廉价的本地开源模型作为“听诊器”,就能隔空测定商业闭源 API 的私有上下文。
最后是在 TM3(智能体自主检索)这一终极场景下,记录作为网页浏览结果,伴随着繁杂的工具调用标记与系统环境状态动态呈现。实验表明,经过离线筛选的过滤提问池发挥了决定性作用。如果攻击者随机盲目抽取问题,单查询推断的失效率可能超过 $36\%$;但一旦切换至经过算法优化的 20 个高敏感度提问池,在兼顾工具多轮损耗的情况下,针对真实智能体系统的推断 AUROC 稳定攀升至 $81.8$。
除了文本大模型,该攻击方法还无缝迁移到了视觉语言模型(VLM)。在图像候选集推断测试中,当隐秘上下文以图片形式存在,且模型被明确要求不得描摹图像细节时,针对 LLaVA 与 Qwen2.5-VL 的跨模态攻击展现出了令人咋舌的穿透力:在包含 64 张干扰图像的候选集合中(随机基线仅为 $1.6\%$),仅凭单次交互的分布推断,攻击成功率即达到 $99\%$。视觉特征在投影至语言特征空间后留下的分布印记,比纯文本显得更为显著和顽固。
实验消融与深层规律洞察
通过系统性改变超参数设置,研究揭示了若干主导上下文推断攻击有效性的内在物理规律:
其一,提问预算(Query Budget $K$)具有强大的正向增益效应。无论在灰盒还是家族内黑盒设定下,随着交互轮数的增加,微小的似然偏置以指数级的置信度迅速累加。这解释了为何面对长会话智能体系统,攻击者的胜率会随着对话轮次的自然展开而急剧上升。
其二,上下文规模与信噪比呈现典型的物理衰减特性。当系统隐藏上下文内塞入的记录条数 $N$ 逐渐增大时,攻击的 AUROC 表现出单调下降趋势。更多的背景文档实际上充当了“热噪声”,冲淡了单一特定记录在注意力计算层面对最终输出分布的影响权重。
其三,模型参数规模展现出非对称的脆弱性。大体量模型往往具有更加精锐、峰值更加显著的下一词概率分布,因而在面对细微的上下文扰动时,其似然差异反而比小模型更加陡峭可辨。这意味着,能力越强、参数越大的先进智能体,在面对非语义推断时可能反而越脆弱。
安全启示:重新构想智能体隐私防御的边界
MBZUAI 的这项工作揭示了一个长期被业界忽视的核心悖论:在追求智能体通用化与智能化的进程中,系统必然需要不断加载丰富的外部私有状态;而深度神经网络的自回归机制,天然会将这些状态以统计概率的形式投射到生成的每一个 Token 上。
长久以来,工业界构筑在应用层的各种安全护栏——无论是针对提示词的“防注入系统指令”,还是针对输出文本的“PII 敏感词擦除”,亦或是基于外部大模型的安全仲裁员——本质上都只是守住了“语义层”这一道大门,而对“分布层”的暗道敞开毫无察觉。这种统计层面的隐式泄露,无法通过简单的规则匹配或语义拒答来消除。
为了真正防御上下文推断攻击,未来的安全架构设计必须被迫走向更底层、可能也更痛苦的工程取舍。例如,在提供对外部不可信用户的接口时,是否需要强制引入基于差分隐私的输出扰动机制?在推理阶段采用更激进的 Top-$p$ 截断或温度采样变换,以主动破坏微弱的似然相关性?抑或是采用物理隔离的智能体工作空间,阻断检索到的敏感数据直接常驻于最终生成回复的自注意力窗口内?这项研究不仅成功开辟了智能体隐私推断这一极具杀伤力的新攻击面,更为下一代端到端安全智能体系统的架构设计敲响了震耳欲聋的警钟。