Deltoris:突破扩散VLA实时控制瓶颈,34.2倍加速背后的比特稀疏与投机计算
Deltoris: Enabling Real-time VLA Inference in Embodied AI via Bit-level Sparsity and Speculative Inference
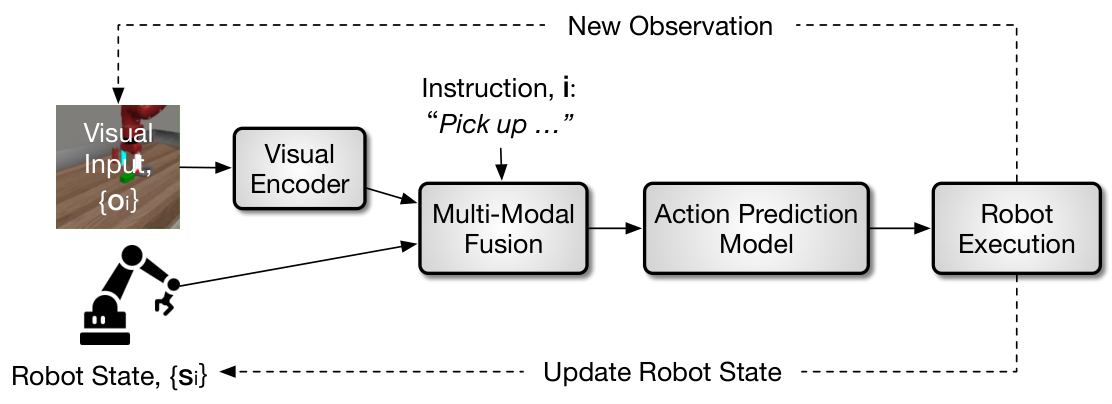
在具身智能(Embodied AI)的系统架构中,大语言模型(LLM)常被视作负责高层规划与常识推理的“大脑”,而视觉-语言-动作(Vision-Language-Action, VLA)模型则承担着类似于“小脑”的角色,直接负责运动规划并输出精准的低级控制指令。然而,与低频调用(通常仅需 1–5 Hz)的语言推理不同,机器人端侧的闭环控制系统要求极其严苛的时间确定性与响应频率,一般需要维持在 50 Hz 到 200 Hz 之间,才能确保机械臂或轮足机器人在物理世界中稳定受控。
ArXiv URL:https://arxiv.org/abs/2608.04428v1
近年来,以 Diffusion Policy 为代表的基于扩散过程的 VLA 模型,凭借出色的运动轨迹平滑度与跨场景泛化能力,逐渐在控制精度上超越了传统的自回归式策略。但这种性能提升带来了极高昂的计算代价:机器人生成单个动作就需要进行几十次迭代去噪,每次去噪都要完整调用深层神经网络。这导致计算负载远远超出了现有边缘端硬件的承受范围。以主流机器人边缘计算平台英伟达 Orin SoC 为例,运行典型扩散 VLA 模型 PAD 时的控制频率仅有 2.0 Hz,与 50 Hz 以上的实时要求相去甚远。
来自中国科学院、上海交通大学以及上海期智研究院的研究团队针对该瓶颈,提出了软硬件协同设计的专用加速框架 Deltoris。该框架敏锐地抓住了机器人高频控制场景中的物理连续性特征——相邻两帧之间的视觉和状态输入往往拥有高达 98% 的冗余。通过将这一时序相似度转化为算法层面的“比特级稀疏计算”,再辅以平摊访存带宽的“投机推理机制”,最终在定制的一维脉动位串行硬件架构上,实现了相对于移动端 GPU 最高 34.2 倍的推理加速,并将算术操作削减了约 93%,而任务成功率的平均精度损失仅为 0.2%。这项工作填补了架构界在扩散类具身控制模型硬件加速领域的空白。
从全量重算到差分消除:被忽视的高频时序冗余
现有主流神经网络加速设计多聚焦在 LLM 的量化、KV 缓存压缩或稀疏注意力机制,而针对具身控制特性的底层优化极少。如果在端侧直接分析扩散 VLA 模型的运行特征,会发现它的执行时间有 91.1% 消耗在去噪扩散循环中。更重要的是,基于 Roofline 模型的性能分析表明,现有的扩散 VLA 模型在 GPU 上属于典型的算力受限(Compute-Bound)负载,而非像大语言模型那样严重依赖内存带宽。这意味着要想拉高控制帧率,首先必须大幅削减总计算量。
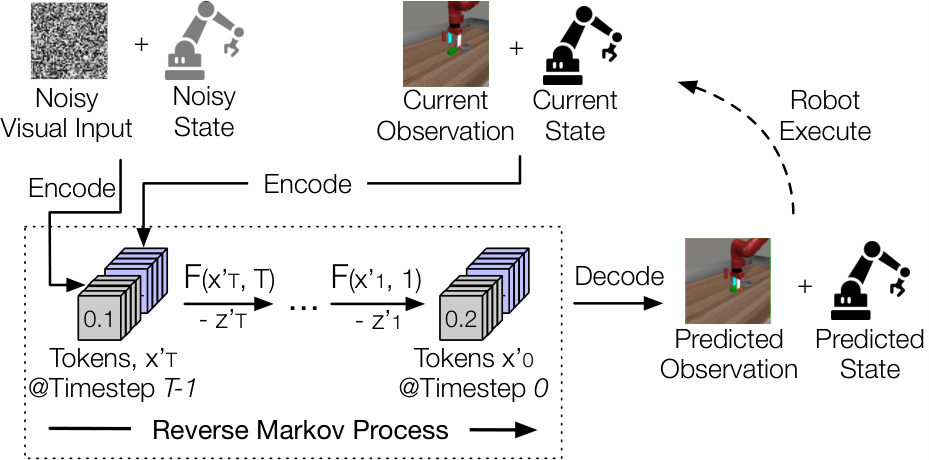
常规的加速思路往往会尝试在权重矩阵中挖掘稀疏性。然而,传统位稀疏加速器(如 Pragmatic 等)仅仅跳过了静态权重中的零比特,完全忽略了机器人控制系统特有的物理动态。在 50 Hz 到 200 Hz 的密集采样下,机械臂的物理位移极小,摄像头捕捉到的连续帧之间,超过 98% 的像素值是完全恒定的。如果每个控制步骤都让神经网络从头对图像和机械状态做一次全量特征抽取与去噪计算,本质上是在反复进行毫无意义的相同运算。
Deltoris 的核心思想正是将这种连续时间步的强相似性转化为计算减免。在数学表达上,假定上一时刻的特征输入为 $\mathbf{x}_{t-1}$,当前时刻为 $\mathbf{x}_t$,线性变换权重为 $\mathbf{W}$。传统方案计算当前输出为 $\mathbf{y}_t = \mathbf{W}\mathbf{x}_t$;而 Deltoris 则将其改写为差分更新形式:
\[\mathbf{y}_t = \mathbf{y}_{t-1} + \mathbf{W}\Delta\mathbf{x}_t,\quad\text{其中}\quad\Delta\mathbf{x}_t = \mathbf{x}_t - \mathbf{x}_{t-1}\]这种形式看似简单,但要在真实神经网络中取得显著效果,必须深入到比特表示层面。由于大部分连续输入相差微弱,差分值 $\Delta\mathbf{x}_t$ 的幅度极小,在定点二进制补码或符号量化表示中,不仅会出现大量的数值全零,即使是非零残差,其高位也基本全是无效冗余位。Deltoris 通过将差分激活值解耦为符号位和按位(Bit-level)表示向量,仅针对激活差分中实际有效的非零比特“1”去触发与权重的点积并进行移位累加。这样一来,不仅省去了常规结构中的零元素计算,还将原本多比特的乘加运算简化成了位串行的高效移位累加,直接从底层剥离掉了高达 92.9% 的冗余算术计算。
消除副作用:用投机推理扭转访存倒挂
然而,在体系结构设计中,单一算法层面的优化往往会引发意料之外的系统瓶颈。当算法团队直接把上述“时序感知比特稀疏”套用在现有硬件上时,意外地发现系统的离线访存流量激增了 1.8 倍。
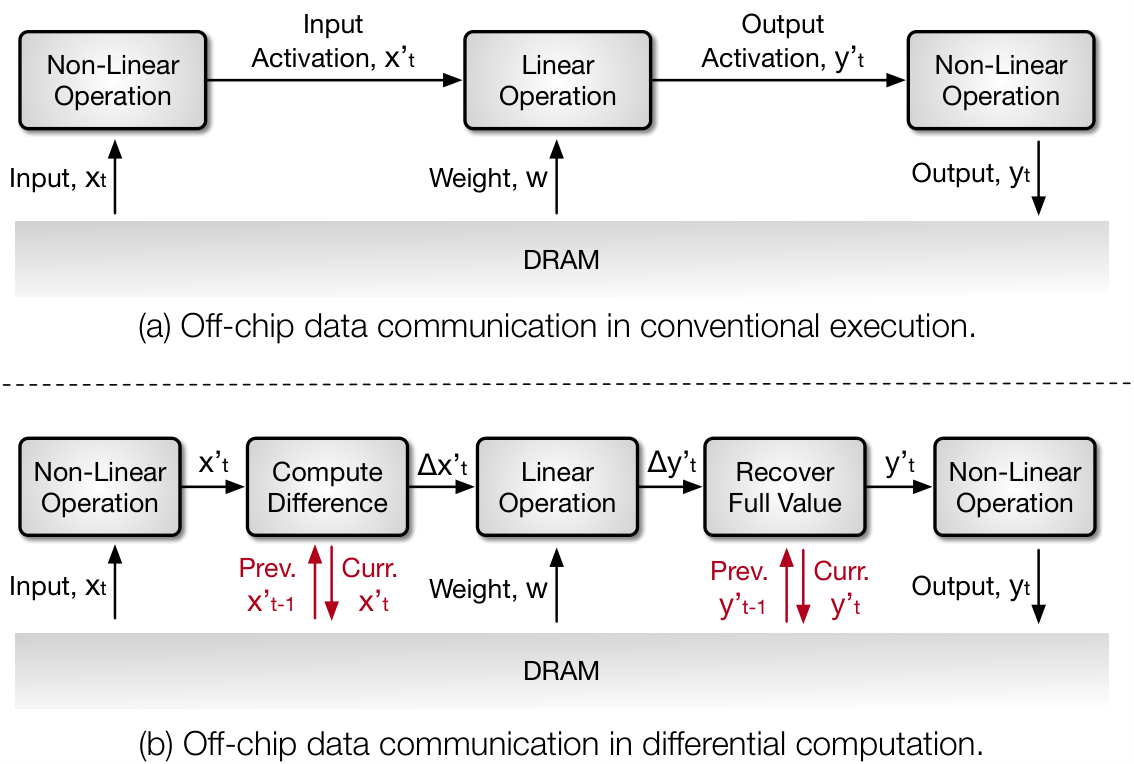
造成这一现象的根源在于深度网络中的非线性算子。差分计算在全连接层或卷积层等线性操作中可以完美保持累加性质,但一旦遇到非线性激活函数(如 GELU、SiLU 等),$\text{Act}(\mathbf{y}{t-1} + \Delta\mathbf{y}_t)$ 便不再等于 $\text{Act}(\mathbf{y}{t-1}) + \text{Act}(\Delta\mathbf{y}_t)$。为了维持精度,硬件必须在每个非线性层之前先将上一帧保存的完整中间激活值加载回来,恢复出真实值,完成非线性变换后,再计算出新的差分值写回。这种反复加载和写回中间激活值的操作,使得模型负载瞬间从原本的“算力受限”倒挂成了极端的“访存受限(Memory-Bound)”。
为了解决这一难题,作者团队借鉴了 LLM 领域的投机采样思路,在机器人连续控制中开创性地提出了“动作投机推理(Speculative Inference)”机制。系统被解耦为一大一小两个 VLA 模型:
-
轻量小模型(Draft Model):在本地极速生成未来连续 $k$ 步的预测候选状态序列,由于模型体积小,其访存和计算成本极低,但单步累积误差较大;
-
高精度大模型(Target Model):负责一次性对小模型给出的 $k$ 个候选动作进行批量验证。只有当大模型验证候选动作与基准去噪结果的残差低于预设阈值 $\theta_{th}$ 时,该步动作才会被正式采纳并下发给执行器。
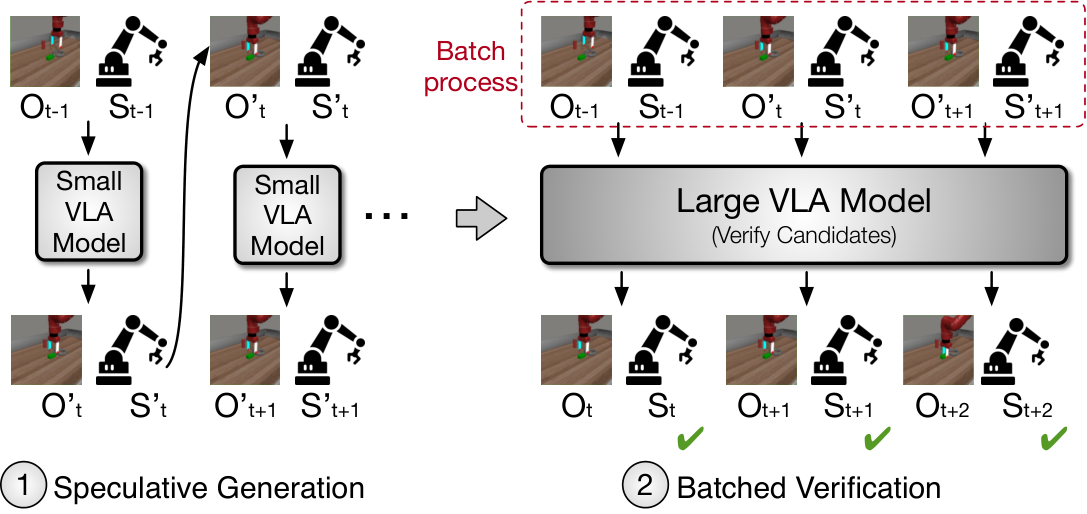
这一机制的关键价值在于对 DRAM 访存的“平摊(Amortization)”。通过让大模型在单次激活中一口气并行校验多个控制步的预测结果,大模型的参数权重以及非线性层所需的基准中间特征只需要从片外内存读取一次,就可以服务于未来多个时刻的去噪校验。原本因为单步差分计算所被迫频繁读取的片外流量,被摊薄到了多个时间步长中。与此同时,为了彻底消除数据搬运开销,Deltoris 还在片上集成了轻量级编码与解码模块:首帧通过矢量量化压缩,后续帧则利用压缩稀疏行(CSR)格式对极度稀疏的差分激活进行流水线无损压缩,使得整体访存开销回落到了甚至低于原始模型的水平。
软硬件协同:消解位串行阵列的负载失衡
有了高效的稀疏算子和投机调度策略,还需要与之完美匹配的硬件底盘。在传统的位串行(Bit-Serial)加速器设计中,最大的工程痛点在于“计算负载失衡(Workload Imbalance)”。因为不同神经元所对应的有效“1”比特数量各不相同,如果让多个处理单元(PE)并行处理不同权重的位串行输入,往往会导致某些早已算完的 PE 陷入长时间的空等,使得理论加速比大打折扣,控制逻辑也极其繁琐。
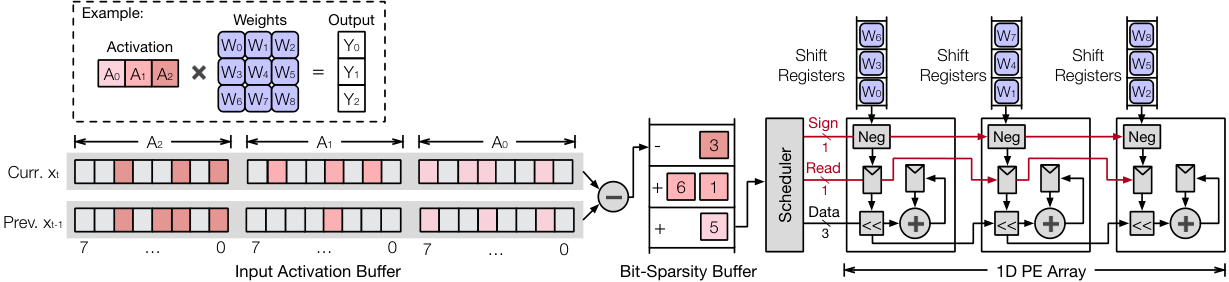
Deltoris 在微架构层面提出了一套新颖的 1D 脉动位串行 PE 阵列,并引入了专门的“输出驻留(Output-Stationary)”数据流设计:
-
控制信号全局广播:不同于以往让每个 PE 自行解算并跟踪激活比特流的做法,Deltoris 将输入差分激活的非零比特事件交由行调度器集中管理。同一行 PE 共同消费相同的输入差分比特流,所有的读取使能和符号移位控制信号(如图中红线标示)完全同步广播给整行所有 PE。这在物理上直接消除了同行之间因比特稀疏度不同而产生的负载不均。
-
局部权重脉动移位:对应的权重矩阵则通过各 PE 局部的移位寄存器横向传递。当这一批差分非零比特处理完毕后,PE 内部的累加器已经驻留了该通道的部分和,阵列只需发出时钟触发下一组权重的滑动加载。
-
跨行权重复用共享:为了降低对片上 SRAM 的高频读取压力,架构将 16 行一维 PE 阵列编为一组。单次从 SRAM 中抓取的一批权重会被同步广播到这 16 行阵列中进行计算复用,从而极大地减少了 SRAM 端口争用与内部数据搬迁的功耗。
整个 Deltoris 加速器集成了 128 个这样的一维 PE 阵列,总计拥有 8192 个运行在 1 GHz 频率下的位串行 PE,搭配 16 通道的非线性向量单元以及 2 MB 的分块片上 SRAM。经 RTL 级硬件综合验证,在等效于常规 32×32 8-bit MAC 算力的同等配置与相同工艺节点(8 nm)下,该芯片面积和能耗控制都表现得极其优异。
性能跃升与物理鲁棒性验证
在涵盖 PushT、LIBERO 以及实际机械臂控制基准的多个主流扩散 VLA 模型(包括 PAD、UVA、VPP 等)上,研究团队对 Deltoris 的全系统原型进行了严格评估。
在精度与任务完成率方面,纯粹的时序感知比特稀疏(Temporal)在数学上完全等同于定点基准,实现了 100% 的严格精度对齐(Bit-accurate)。而当引入投机推理机制后,由于大模型设置了严格的动作阈值验证门禁,模型展现出了强大的纠偏能力。实验数据表明,Deltoris 整体的平均任务成功率降幅仅有 0.2%,而相比之下,如果直接使用小模型控制,机械臂的任务成功率会暴跌 7.7% 以上,证明了投机验证机制在保障安全与精度上的不可替代性。
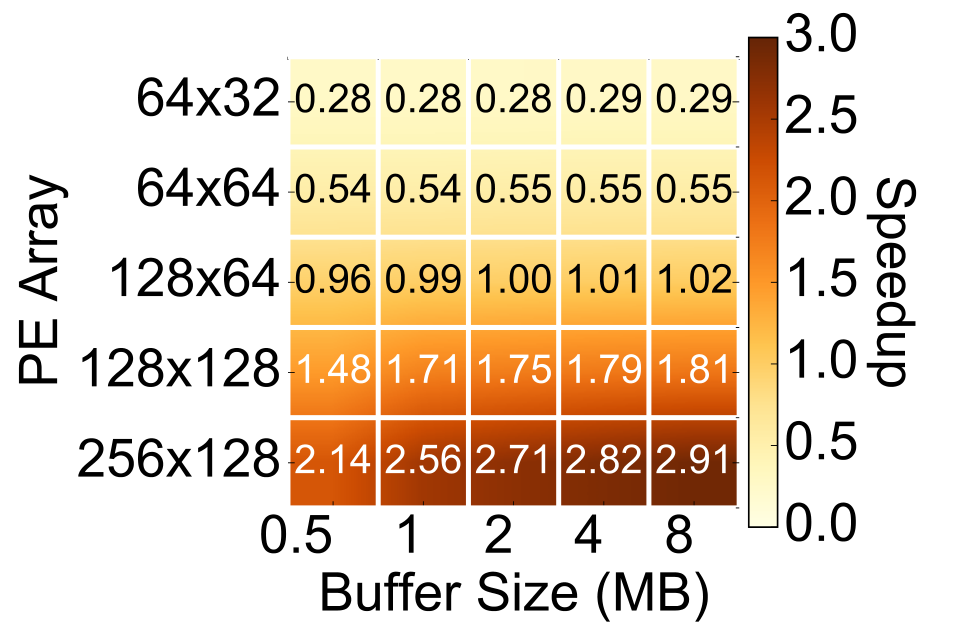
在执行效率方面,得益于近 93% 的冗余操作消除和高效的片外带宽控制,Deltoris 展现出了压倒性的吞吐与能效优势:
-
相对于现有的端侧移动 GPU,Deltoris 实现了最高 34.8 倍、平均超过 30 倍的端到端推理加速,彻底越过了 50 Hz 这一实时性门槛,让曾经无法落地的复杂扩散策略具备了毫秒级连续闭环响应能力。
-
相对于针对位稀疏设计的专用加速器(如 Pragmatic、BBS)以及针对扩散图像生成的专用加速器(如 Ditto),Deltoris 依然取得了 3.1 到 6.1 倍的性能领先。消融实验清晰地表明,这种飞跃主要来自于 Deltoris 首次利用了控制回路特有的“跨帧物理相似性”,而非局限于静态权重稀疏或单次生成的去噪步相似性。
-
在能效表现上,得益于位串行加法替代乘法、输出驻留以及压缩传输,Deltoris 相对移动 GPU 取得了最高 822.0 倍的能耗削减,这对依靠电池供电的移动具身机器人而言是决定性的优化。
针对外界可能提出的质疑——“如果机器人遇到快速运动场景,时序相似度破坏,该方案是否会失效?”,作者进一步通过跳帧和加快执行动作的方式构造了高动态快速运动数据集。压力测试显示,即使在物理环境剧烈变化、帧间变化率大幅上升的极端工况下,Deltoris 依旧保持了稳定的任务执行成功率,且由于依然存在局部与背景冗余,其加速比依然显著优于传统加速结构。
对具身智能端侧落地的启示
Deltoris 的设计思路为机器人控制与大模型硬件设计的结合提供了一个极具价值的范本。以往的端侧 AI 加速往往沿着大语言模型的足迹,将精力主要放在通用权重量化或 KV 缓存压缩上。然而,具身智能系统最大的特殊性在于它与物理世界之间的高频连续交互。
连续的控制信号不仅意味着沉重的低延迟计算压力,但从反方向看,物理惯性也天然赋予了系统在时间维度上的极高信息冗余。Deltoris 证明了:不需要对扩散模型结构伤筋动骨,通过在算法层建立微小的差分位级抽象,并在微架构上解决位串行的控制均衡与访存平摊,就能将看似不可企及的扩散控制延迟压至实时线以内。随着通用具身智能对多模态端到端控制要求的不断提高,这种结合了物理动力学先验与体系结构创新的软硬件协同方案,正成为打破大模型“上机”瓶颈的最优路径之一。