DreamTraj:直读未渲染扩散隐层,单图预测6-DoF轨迹提速4.6倍
DreamTraj: Generating 6-DoF Object Trajectories by Reading Unrendered Video Diffusion Latents
在具身智能与机器人操纵领域,预测被操作物体的未来三维运动是闭合“感知-决策-控制”回路的核心一环。如果机器人能在动作执行之前,准确预判目标物体在空间中完整的六自由度(6-DoF,包含平移与旋转)轨迹序列,后续的抓取规划、避障以及工具使用便能解耦为成熟轨迹跟踪控制问题。然而,获取高质量的三维空间运动轨迹代价极高,物理世界中的轨迹标注往往依赖昂贵的多视角相机阵列、高精度深度计或精确的 CAD 几何模型。
ArXiv URL:https://arxiv.org/abs/2608.00486
为了摆脱对专用硬件和特权输入的依赖,近期的研究分化成了两条路线。一条路线试图直接从交互数据中回归 6-DoF 轨迹,但现有基准往往使用粗糙的动词-名词标签,且在推理时往往苛求多帧连续视频、物体网格甚至初始真实位姿等特权输入;另一条路线则借助大规模视频生成模型,即“先生成视频、再提取轨迹”(Generate-then-Extract),先用文本和首帧提示扩散模型生成一段完整的未来视频,再挂接目标分割、点追踪、深度估计与位姿拟合等多模型感知流水线。这种层层串联的重型方案不仅带来了显著的计算延迟,还会导致误差在流水线中层层放大。
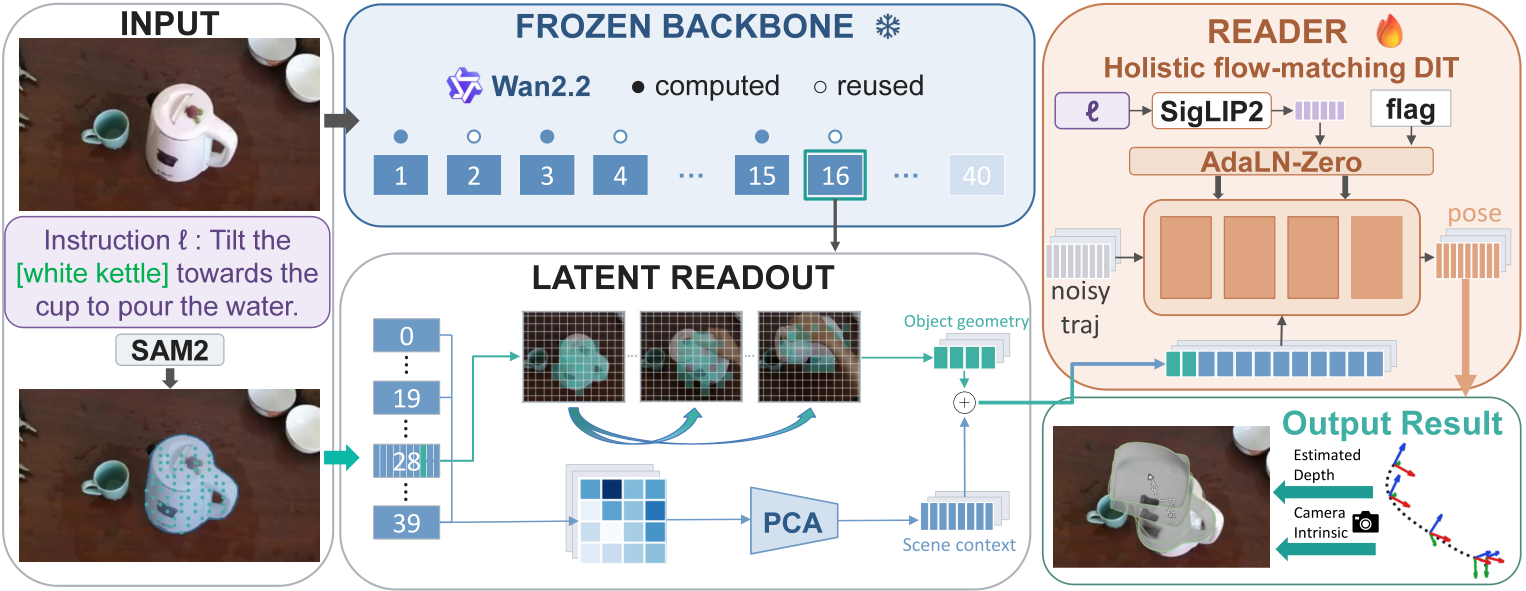
面对上述两难,DreamTraj 提出了一种截然不同的范式:它不仅将推理接口极限压缩到仅需“单张 RGB 图像 + 一句自然语言任务指令”,而且彻底颠覆了依赖像素渲染的传统思路。研究人员发现,在大规模视频扩散模型的去噪早期阶段,其内部特征就已经形成了关于物体未来运动的高度结构化表征。DreamTraj 完全冻结底座视频扩散模型,无需跑完降噪全程,更无需通过 VAE 将潜变量解码成视频像素,仅依靠一个参数量仅 7.1M 的轻量化流动匹配(Flow-Matching)解码器,在去噪第 16 步直接“读取”未渲染的扩散隐层表征,便能高精度重构出未来 6-DoF 物体轨迹。相比于传统的生成后提取流水线,DreamTraj 实现了 4.6 倍的端到端推理提速,并在平移与旋转预测精度上显著超越了依赖特权几何信息的强基线。
视频扩散模型里的未渲染运动潜能
要理解 DreamTraj 的新颖之处,首先要看清传统视频扩散模型作为运动先验时的固有痛点。视频扩散模型在互联网级大规模视频上训练,确实内化了极强的物理动态与时空因果常识。然而,传统方案为了提取这种常识,必须完整走完数十步的反向去噪循环,再调用计算密集型的 VAE 解码器将潜变量恢复为由数百万像素组成的视频帧序列。接着,下游任务还要在像素空间中依次调用分割模型、光流追踪器、单目深度估计网络以及位姿对准算法。这个过程不仅极其耗时,且一旦生成的像素稍有几何畸变或光影闪烁,后续的感知模块就会彻底失效。
但实际上,视频扩散模型在形成高频像素细节之前,早早就在特征空间内确定了物体的宏观运动轨迹与相对几何位移。图像与视频扩散模型的深层注意力图本身就具备极强的语义对应性。既然运动意图已经在内部潜变量中达成一致,为什么还要大费周折地渲染出整段视频,再去像素世界中逆向拟合轨迹?
DreamTraj 的核心洞见正在于此:跳过像素生成,将轨迹预测视为对预训练扩散表征的直接逆向读取。系统选用完全冻结的 Wan2.2 图像生成视频(Image-to-Video)模型作为骨干。给定一张单目 RGB 初始帧图像 $I_0$ 和任务指令 $\ell$,Wan2.2 启动去噪过程以“想象”未来的交互发展。在整个 40 步的降噪时间表中,DreamTraj 并不让它走完全程,而是在第 16 步(对应潜变量低噪专家的初始临界状态)果断截断前向传播,直接从模型中间层抽取两路互补特征。
第一路特征是物体局部的细粒度追踪线索。利用在初始帧上通过 GroundingDINO 与 SAM 2 获得的目标边界框与分割掩码,研究团队在物体区域采样查询点,并在骨干网络第 28 层的第 32 个注意力头中提取查询-键(Query-Key)注意力相关性图。这一特定的注意力头能够在未渲染的潜变量中跨时间追踪目标物体点,形成粗糙的二维运动轨迹与逐帧深度/旋转变化线索。第二路特征是全局场景上下文。模型从骨干网络的第 0、19、39 层隐状态中进行网格池化,提取出 128 维的场景几何与环境特征。将这二者拼接,便构成了一个包含 13 个时间步、每步 132 维的紧凑序列,浓缩了未来动作中物体与环境的全部几何交互信息。
极轻量流动匹配解码器与尺度自适应解耦
从扩散模型深层截取的 132 维特征虽然富含运动信号,但它依然是隐式且无量纲的,无法直接驱动机械臂。为了将这些抽象表征映射到三维刚体运动流形中,DreamTraj 引入了一个参数量仅为 7.1M 的轻量级流动匹配(Flow-Matching)Reader 解码器。该解码器基于 Diffusion Transformer(DiT)架构构建,其参数规模比冻结的底座大模型低了整整三个数量级,其定位非常明确:不需要重新学习物理动力学,只需解码骨干网络早已确定的运动倾向。
为了避免误差随时间递增,Reader 采用整体化(holistic)去噪策略,一次性联合生成未来时序中全部 13 个相对位姿 Token,使得总位移与全程运动趋势能够在全局约束下协同决定。针对每个时间步 $t$,预测的目标状态定义为一个无尺度的相对 9 维位姿表示:
\[\mathbf{y}_{t} = \big[ \underbrace{\delta u_{t},\ \delta v_{t}}_{\text{方位偏移}},\; \underbrace{s_{t}}_{\text{对数深度比}},\; \underbrace{\mathbf{r}_{t}\in\mathbb{R}^{6}}_{\text{连续旋转表征}} \big]\]其中,$(\delta u_t, \delta v_t)$ 代表物体相对于首帧归一化图像平面的坐标偏移;$s_t = \log(z_t / z_0)$ 为当前时刻相对首帧的对数深度比率;$\mathbf{r}_t$ 采用连续 6 维正交向量表示法描述刚体相对三维旋转矩阵 $R_0^{\top} R_t$。这种设计的精妙之处在于完全摆脱了绝对公制尺度的束缚——解码器在输出端永远只处理比例和方向,因此不会受到相机绝对距离或物体真实尺度的扰动。
公制尺度的恢复被严格后置到了推理的最末端。在得到 13 个无尺度位姿 Token 并重采样至 49 帧的时间分辨率后,系统仅对输入的单张 RGB 图像调用一次单目深度估计模型(或在有真实深度计可用时直接读取)获取初始深度 $z_0$。结合已知的单目相机内参矩阵 $K$,利用透视投影几何关系:
\[X_t = \frac{(u_0 + \delta u_t - c_x) \cdot z_0 e^{s_t}}{f_x}, \quad Y_t = \frac{(v_0 + \delta v_t - c_y) \cdot z_0 e^{s_t}}{f_y}, \quad Z_t = z_0 e^{s_t}\]便能轻巧地将相对位姿提升至具备真实米级物理尺度的完整 6-DoF 刚体轨迹。此外,为了进一步压缩骨干网络的计算开销,系统在去噪推断中采用了步长为 2 的流缓存(Stride-2 Flow Caching)机制,每隔一步复用无分类器引导的流方向计算,将底座大模型的有效前向传播次数压缩了一半。
数据荒原下的破局:Move 数据集与双域联合训练
轻量级 Reader 的解码效果高度仰赖监督信号的质量。在当前的具身操纵领域,开源数据集面临着结构性困境:像 Ego4D、EPIC-KITCHENS 这样的超大规模第一视角视频,标注仅仅停留在粗糙的动词-名词组合,缺乏连续的 6-DoF 物体位姿;而高精度位姿数据集往往依赖实验室动作捕捉系统或 Aria 智能眼镜,规模十分有限;近期的自动化挖掘方案虽能在海量无标注视频中合成轨迹,但不可避免地引入了大量伪标签噪声。
为此,研究团队构建了 Move 数据集,涵盖 5,038 条以物体为中心、且经过严格人工复核的 6-DoF 操纵轨迹。首先,团队从 HOI4D、HOT3D、OakInk2、TACO 等 6 个具有刚体真值位姿的开源交互库中筛选出 7,246 个片段,通过严格的过滤标准——操作必须有明确目的、非静态怠速、且动作在时间窗口内具备完整起止闭环——最终清洗出 2,975 条高质量的真实物理轨迹。随后,利用多模态大模型对每一段交互进行物体级重新描述,并经人工校验修正动作边界,将以往笼统的“拿取(pick up)”细化为明确目标物体、动作方式与运动轨迹的细粒度自然语言指令。
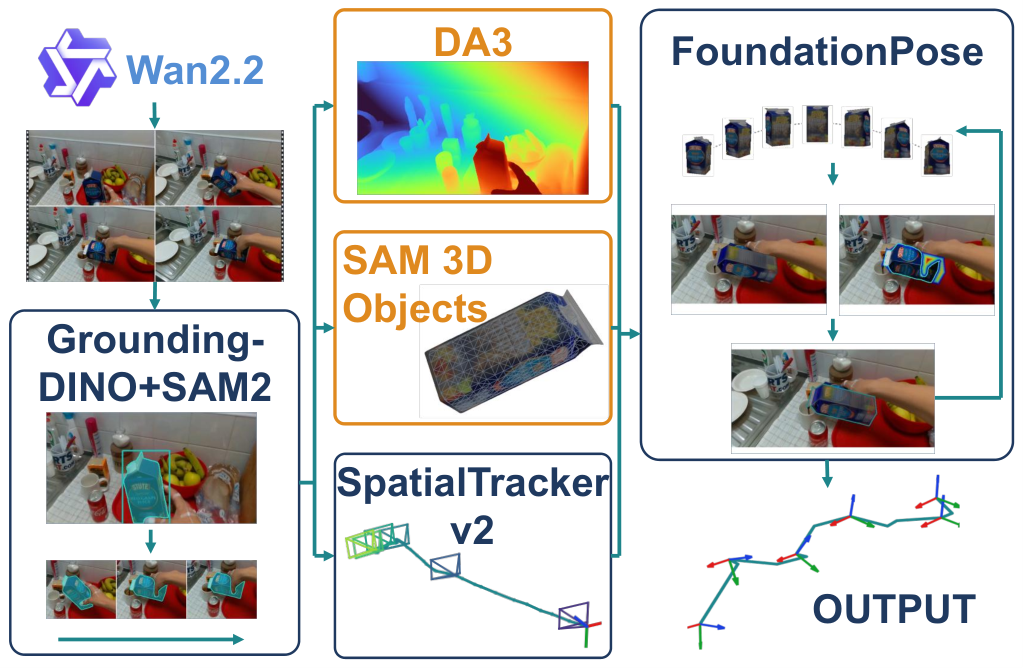
然而,单纯依靠真实视频训练会面临严重的“域漂移”(Distribution Gap):在真实部署场景中,Reader 输入的特征来自视频扩散模型对未来的“幻觉想象”,其潜变量表征分布不同于对真实视频加噪得到的潜变量;但若全部使用生成视频,人工标注的真实 6-DoF 真值又无法自然获得。针对这一矛盾,团队引入了生成式数据增强与双域对齐训练机制:
-
生成域轨迹提取:使用 Wan2.2 对保留的真实视频首帧与文本指令进行条件生成,利用包含 DA3 绝对度量深度估计与 SAM 3D Objects 几何重建的离线感知流水线提取 2,063 条轨迹,经人工复验后作为生成域扩充样本。
-
Domain A(真实域):将真实录制的视频加噪至截断步数(Step 16),运行单次骨干前向提取中间特征,直接由动捕系统或刚体拟合得到的真实 6-DoF 轨迹提供高精度强监督。
-
Domain B(生成域):输入单帧与指令,由 Wan2.2 自行去噪展开生成特征,监督信号采用由离线提取流水线从该生成视频自身提取的轨迹,而非源真实视频的轨迹,以确保生成特征与运动标签在物理逻辑上严格自洽。
在训练时,Reader 的 DiT 条件输入中增加了一个显式的域标识向量 $E_{\text{dom}}(d)$。两域共享同一套解码器权重,先在生成域进行预热,再混合真实域联合训练,并适当降低生成域中高噪声旋转通道的损失权重。这种策略使得小巧的 Reader 既学到了真实物体的精确刚体运动学,又充分适应了生成模型内部潜变量的特征分布。
实验评测:不仅跑得快,更在无特权下全面超越
评测采用了严格的 5 折交叉验证,折的划分严格按源视频片段隔离,防止任何衍生样本发生数据泄露。在评价指标上,平移误差通过全轨迹平均位移误差(ADE)与最终位移误差(FDE)衡量,旋转误差则计算三维旋转测地线距离(Rot 及 Rot-final)。所有对比均以相对锚点帧的相对变化计算,消除了绝对坐标系带来的基准漂移。
研究选取了当前具身轨迹预测领域的代表性前沿方法进行对比,包括 ObjectForesight 与 EgoScaler。值得注意的是,这些对比基线在推理时均享受了显著的“特权输入”:ObjectForesight 必须依赖多帧视觉上下文序列、物体的预先扫描 CAD 网格以及前 3 帧的真实位姿;EgoScaler 则依赖输入深度图以及物体的初始精确 6-DoF 位姿。相比之下,DreamTraj 仅输入单帧 RGB 与文本指令,其余几何参数均来自模型自带的自洽推导。
即使在输入信息显著处于劣势的前提下,DreamTraj 的精度依然展现出断层式的领先优势。在针对不同基准时间范围的严谨对齐测试中,DreamTraj 在几乎所有指标上刷新了最佳表现:
| 对比基线 | 输入条件限制 | 评估样本量 | ADE (cm) $\downarrow$ | FDE (cm) $\downarrow$ | Rot ($^\circ$) $\downarrow$ | Rot-final ($^\circ$) $\downarrow$ |
|---|---|---|---|---|---|---|
| ObjectForesight | 依赖多帧上下文 + CAD网格 + 真实位姿 | $n=537$ | 7.52 | 10.71 | 28.6 | 45.6 |
| DreamTraj(本文) | 单张RGB + 文本指令 | $n=537$ | 3.04 | 4.71 | 7.9 | 12.9 |
| EgoScaler | 依赖连续帧 + 深度图 + 初始位姿 | $n=594$ | 10.29 | 12.74 | 29.8 | 30.2 |
| DreamTraj(本文) | 单张RGB + 文本指令 | $n=594$ | 6.76 | 8.39 | 18.2 | 20.4 |
数据显示,在与 ObjectForesight 相同的预测窗口下,DreamTraj 将最终位移误差(FDE)从 10.71 cm 大幅压缩至 4.71 cm,最终旋转误差从 45.6° 骤降至 12.9°;在应对 EgoScaler 的长程评测区间中,DreamTraj 亦将末端位移误差从 12.74 cm 降低到 8.39 cm。实验表明,依赖 CAD 模型或历史位姿的传统前向回归模型极易因为误差累积而在长时段发生漂移,而内嵌于大规模视频扩散模型中的时空动力学表征能够提供更稳固的全局物理约束。
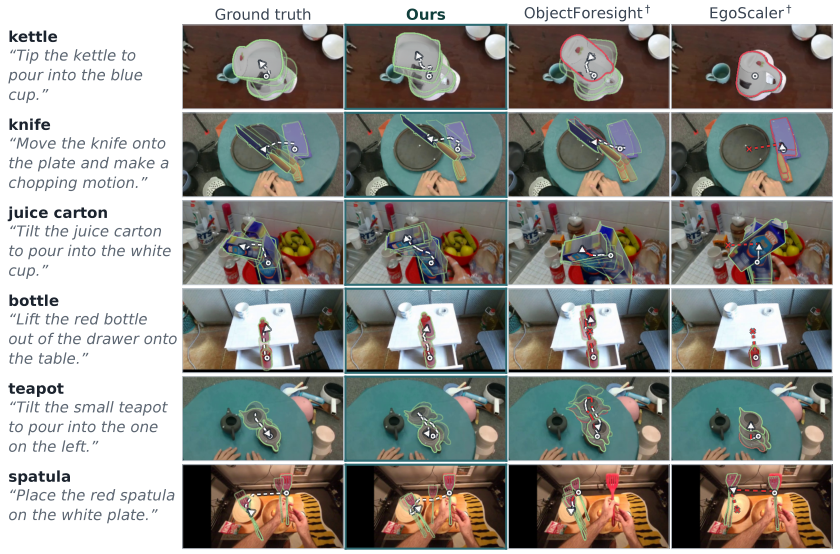
定性可视化直观展现了这种差距。将预测的 6-DoF 位姿还原为网格轮廓投影到原始视场中,可以看到现有方法在预测抓取旋转或远距离放置时,轨迹往往在中后期发生畸变或穿模,甚至在旋转角度上发生剧烈晃动;而 DreamTraj 解码出的轨迹在平移曲率与旋转姿态的变化上极为平滑,与真实物理操纵展示出高度的动力学一致性。
为什么在第 16 步?深挖扩散机制的表征突变
在整个设计中,最引人入胜的科学问题莫过于:从视频模型的哪一个注意力头读取?又应当在第几步读取?
为了避免选出的特征仅仅捕捉了某种平凡的统计偏置(例如所有的操作大多都是朝向画面中心移动),研究团队设计了一种基于置换检验的“净相关裕度”(Permutation-Controlled Margin)度量 $m$:
\[m = \big\vert{}\rho(a_i, g_i)\big\vert{} - \mathbb{E}_{j\neq i}\,\big\vert{}\rho(a_i, g_j)\big\vert{}\]该指标计算某个注意力中心与本视频真实二维轨迹相关性绝对值,并强行扣除其与数据集内其他无关视频轨迹的相关性均值。由于日常操作在时域轮廓上存在天然共性(即使读取无意义特征,与无关样本的虚假相关系数也能高达 0.43),只有当 $m > 0$ 时,才能确证所提取的特征真正反映了特定样本特异性的动态轨迹。
在对 Wan2.2 全部 40 层、每层 40 个注意力头进行遍历筛选后,第 28 层的第 32 个头(Block 28, Head 32)脱颖而出,其 $m$ 裕度达到了 0.191。
更深刻的现象发生在去噪步数(Step)的演进上。当固定在 Block 28 Head 32 观察去噪步数 $k$ 从 12 步向 20 步推进时,表征质量发生了一次戏剧性的“相变”:
-
在 $k=12$ 时,裕度仅为 0.123,ADE 误差为 8.05 cm;
-
在 $k=14$ 时,裕度为 0.129,ADE 误差为 8.52 cm;
-
推进到 $k=16$ 时,裕度瞬间跃升 48% 至 0.191(配对检验 $t=12.6$),ADE 误差同步降至全局最优的 7.89 cm;
-
而在 $k=18$ 和 $k=20$ 时,裕度分别为 0.196 和 0.197,表征质量几乎完全走平,增幅不足 3%。
这一跃升并非巧合,它精准对应了 Wan2.2 架构内部从高噪声专家(High-noise Expert)向低噪声专家(Low-noise Expert)的切换点(调度时间戳 $t=900$,恰好位于第 14 步与第 16 步之间)。这一发现有力地证实:视频扩散模型在高噪声阶段主要负责建立画面的全局低频结构与语义对齐,一旦迈入低噪声专家的第一步(即 Step 16),系统在宏观物体的运动轨迹与几何走向上已经完成决策并完全饱和,后续的 24 步迭代仅仅是在精细化局部纹理与高频像素细节。因此,在第 16 步直接截断并解码,在数学机理与特征表征上都找到了最优平衡点。
在推理效率对比上,这种截断机制展现出了惊人的工程价值。对比同样采用 Wan2.2 底座的 RIGVid 风格“生成后提取”流水线:
-
生成后提取流水线:必须执行全部 40 步去噪迭代(无分类器引导需 80 次前向传播),再加上 VAE 逐帧像素解码,单片段视频生成耗时 280 秒;后续运行包括分割、光流点追踪、单目深度、位姿对准在内的四阶段感知流水线,耗时 68 秒;单条轨迹累计耗时长达 348 秒。
-
DreamTraj 流水线:仅需前向推算至第 16 步,配合步长为 2 的流缓存,底座模型仅需执行 18 次前向计算;无需像素渲染与 VAE 解码,7.1M 的 Reader 解码器前向耗时可忽略不计,端到端总延迟仅为 76 秒,带来了 4.6 倍 的绝对提速。
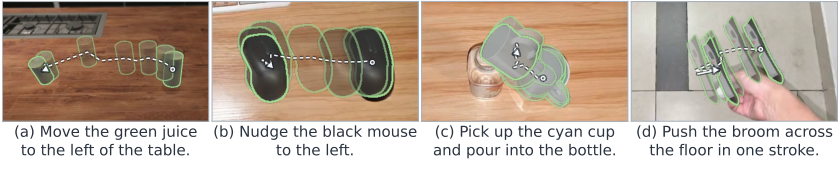
为了检验模型的泛化边界,研究人员收集了 50 个训练集中从未出现过的未知场景,其中包括 40 个真实拍摄的手机视角与 10 个商业 3D 游戏画面,涵盖各类未见过的异形物体与新颖指令。在 10 名标注人员盲测评估下,DreamTraj 预测出的 6-DoF 刚体轨迹与自然语言指令意图在 80% 的极端未知场景中保持了高度契合。这表明,依靠冻结的十亿级视频大模型底座,DreamTraj 真正继承了互联网级视觉常识的泛化红利,而没有被下游少量的操纵数据带偏分布。
结语与具身落地的新范式
长期以来,在具身智能中应用世界模型(World Model)一直受制于高昂的像素渲染开销与误差累积。很多研究者习惯于将视频生成模型当成一个黑盒像素播放器,却忽视了潜变量空间本身就是一种高度紧凑、具备时空几何连续性的物理状态流形。
DreamTraj 的成功证明了一条极具启发性的技术路线:未来的具身规划器或许根本不需要渲染未来,只需要看懂扩散模型的内在思考。 通过将表征截取点锁定在模型运动意图初现的相变阶段,并用轻量流匹配网络实现无尺度相对位姿的直接读出,机器人不仅能以前所未有的速度生成高精度 6-DoF 轨迹,更能将感知接口缩减至单目 RGB 与指令的最简形式。这种从“像素外显生成”向“潜变量隐式解码”的思维转变,为大模型先验在物理控制系统中的低延迟落地提供了极具价值的设计模板。