EMBL AI Librarian:告别外置向量库,引文F1提升超16分
EMBL AI Librarian: Life-Sciences Knowledge Layer for AI Agents
在生命科学领域,由大语言模型(LLM)驱动的自主智能体(AI Agent)正在以前所未有的速度渗透到科研全流程。从跨文献总结实验证据、编写生信代码,到预测生物标志物乃至自主提出可检验的科研假说,智能体早已脱离简单的聊天机器人形态,成为科学研究中的实质协作者。然而,这些高阶推理任务无一例外依赖着同一个底层支柱:公开发表的科学文献。面对生命科学文献呈指数级爆炸的现状,如何让智能体精准、高效地获取文献证据,成为了阻碍 AI 成为“真正科学家”的致命瓶颈。
ArXiv URL:https://arxiv.org/abs/2607.28229
传统的文献服务基础设施,例如由欧洲生物信息研究所(EMBL-EBI)托管的 Europe PMC,索引了超过 4000 万篇 PubMed 摘要、近 1200 万篇全文文献和 120 多万篇预印本,在医药与生命科学领域的文献覆盖度甚至超越了 PubMed。但这套沉淀了数十年的海量宝库完全是为“人类阅读”量身定做的:它要求使用者在搜索框中敲入布尔逻辑、专业字段语法与受控词汇,返回的则是包含动辄数万 Token 的整篇论文。当 AI Agent 接管检索时,模型不仅要在上下文窗口里承受巨大而冗余的全文 Token 消耗,还极易迷失在繁琐的语法与同义词泥潭中。
为了解决这一人机界面错配问题,来自欧洲分子生物学实验室(EMBL)等机构的研究团队推出了 EMBL AI Librarian。与业界此前耗费巨资将全网文献切片、嵌入(Embedding)并搭建数百吉字节(GB)稠密向量数据库的做法截然不同,该方案没有自建任何离线向量索引,而是通过一个通用的 LLM 作为中央控制器,直接与 Europe PMC 的原生实时搜索引擎对话。它接收智能体提交的自然语言问题,并在底层完成多角度布尔检索规划、正文段落解析与句子级证据定位,最终向上层智能体返回紧凑、高精度且附带元数据引文的“证据级”文本片段。
在四个横跨文献综合、科学断言验证、开放域事实问答和真实生物学工作流的权威基准测试中,装配了 Librarian 知识层的智能体均展现出显著的性能跃迁。在多篇文献综合任务 ScholarQA-Bench 上,其引用 F1 分数(Citation F1)相较此前最强的学术基准暴涨超过 16 个百分点;在正文事实问答 LitQA2 上,它帮助前沿模型 GPT-5.4 的准确率提升了近 9 个点;在涉及序列操作等真实生物学基础任务(LAB-Bench)上,精度提升最高达到 11.3 个百分点。该工作不仅开源了全部架构与评估流程,更标志着生命科学领域的文献获取正从“让每个 Agent 独立啃全文”向“通用的即插即用知识层”演进。
人用检索与稠密向量库的双重困境
要理解 EMBL AI Librarian 的构思,首先必须看清当前科研智能体在文献交互上面临的两难处境。
第一种路径是让 Agent 直接对接现有的学术检索数据库。生命科学的概念表达高度复杂多样,同一种生物实体在文献中往往以截然不同的形态存在。例如,一个抑癌基因既可能写作基因符号 $TP53$,也可能被称为蛋白质 $p53$;肌萎缩侧索硬化症在文献中可能写作 ALS,也可能对应 MeSH 受控词表中的完整术语。人类科研人员早已习惯在搜索界面里借助布尔逻辑运算符(AND/OR/NOT)与限定字段(如作者、期刊、方法段落、物种或化合物注释)组合检索式。但对于 LLM Agent 而言,单次自然语言提问很难自动映射为涵盖全部同义词的结构化语法,一旦检索词出现偏差,召回率就会断崖式下跌。更严峻的是,传统数据库返回的结果单元是“整篇论文”。在固定的上下文窗口预算内,强行让 Agent 阅读整篇论文极其昂贵,其中真正支撑结论的往往只是讨论或结果段落里的寥寥几句话,海量不相关上下文还会大幅诱发模型的“大海捞针”失真与幻觉。
第二种路径则是近年来检索增强生成(RAG)领域推崇的稠密向量数据库(Dense Vector Index)。近期诸如 OpenScholar 等前沿学术检索系统,将数千万篇文献切碎成段落,利用专门的 Embedding 模型编码为高维向量,再通过余弦相似度检索最近邻片段。然而,这一方案的代价正变得难以承受。首先是惊人的基建与维护成本,仅 OpenScholar 的向量库就占用约 744 GB 存储,且生命科学文献每天都在海量更新,离线重嵌入和同步极其沉重。其次,向量嵌入的黑盒机制强行将结构化的学术元数据(如物种标签、化学物质注释、研究年份、期刊范围)“拍扁”为连续数值,使得用户与 Agent 无法再利用 Europe PMC 数十年积累的精细分类字段进行硬过滤。此外,最新检索领域的研究表明,随着基础模型推理能力的跃升,一个由强模型驱动的多轮结构化 BM25 传统检索引擎,其效果不仅能够匹敌甚至已经超越了昂贵的稠密检索。
面对两端的不平衡,EMBL AI Librarian 提出了一个根本性的架构转向:不再耗资自建专有向量库,而是把文献数据库本身视作受控的实时外部工具,由一个通用的大语言模型来充当“AI 图书管理员”,在自然语言问题与传统复杂检索接口之间架设一层精细的知识代理层。
架构拆解:单一控制器驱动的精密三阶段流程
在 Librarian 的设计哲学中,智能体下游任务关心的从来不是“哪几篇论文被检索到了”,而是“哪几句具体陈述直接回答了问题”。因此,系统将输出单元定义为包含精准句子切片、可引证元数据以及原始检索语法的“证据项”(Evidence Item)。整个流程由单一 LLM 控制器主导,按照“先最大化召回,再多级精准提纯”的逻辑推进。
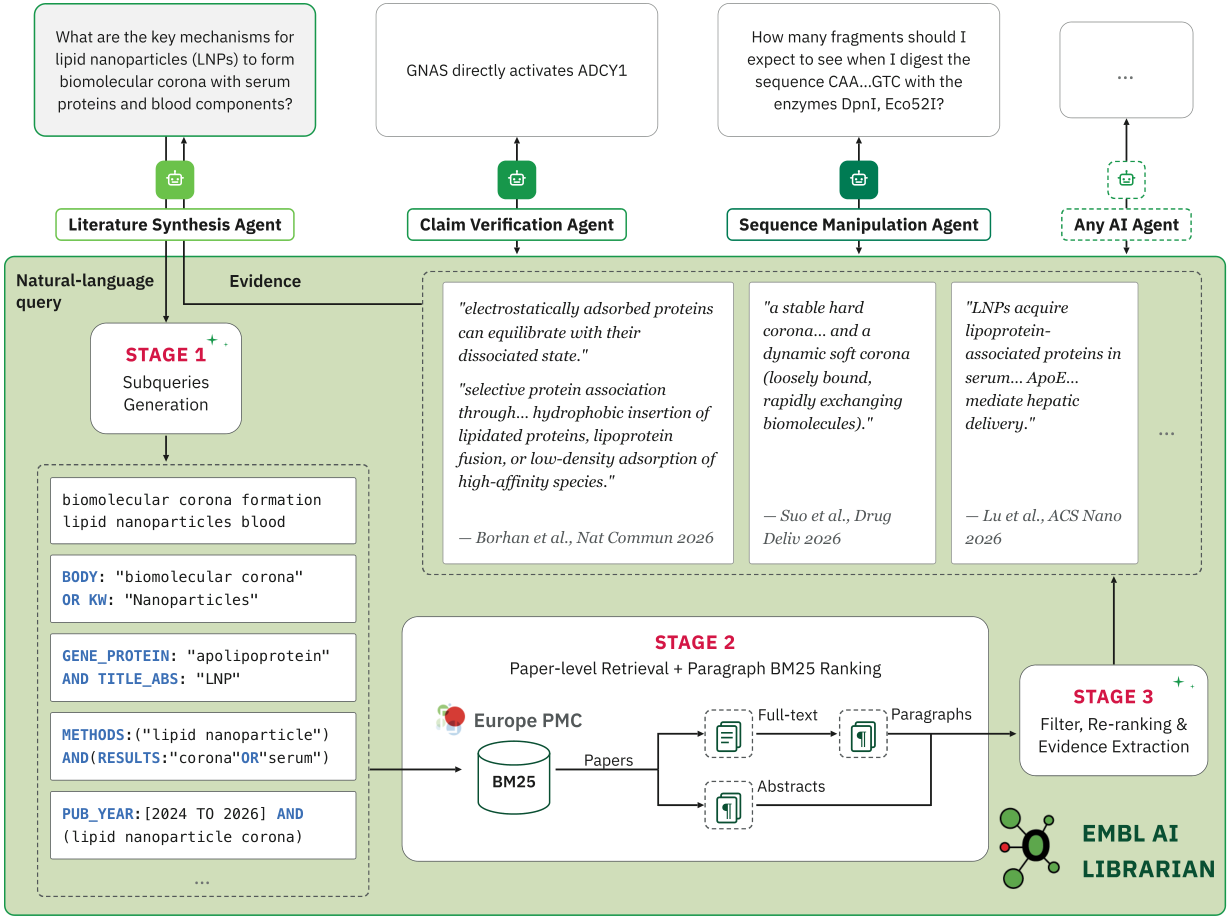
如上图所示,当外部 Agent 输入一个自然语言问题时,Librarian 在内部将其分解为三个环环相扣的阶段:
第一阶段:互补性子查询规划与校验
为了克服生命科学领域实体别名多、专有名词零散的困难,Librarian 并不会直接拿自然语言提问去硬套关键词。控制器模型会针对原始问题生成 $N$ 个(默认配置为 7 个)互补的高级检索子查询。这些子查询充分利用了 Europe PMC 独有的高级语法体系,涵盖基因/蛋白别称展开、疾病同义词扩展,以及针对特定字段(如方法部分、化学物质实体注释)的布尔限定。为了避免大模型生成幻觉语法导致 API 崩溃,所有生成的子查询在提交执行前,都会经过内置的语法验证器,确保其严格符合检索端语法规范。
第二阶段:实时召回与全文段落级初排
经过验证的子查询被并发发送至 Europe PMC 的实时搜索引擎。每个子查询至多返回 $P=50$ 篇候选文献,系统随后合并去重。对于命中的全文开放获取文献,Librarian 直接拉取其结构化全文,并切分成独立的自然段落;对于受版权保护仅能获取摘要的文献,则以摘要段落为单元处理。此时候选池规模庞大,Librarian 利用轻量高效的词法打分器对段落进行第一道打分,选出与查询最相关的候选段落集合(默认保留 $k=16$ 个段落进入下一阶段)。
第三阶段:句子级交叉评估与证据抽取
这是整个系统实现高精度的核心所在。如果将筛选出的所有段落全文再次扔给下游 Agent,依然会严重浪费计算资源。Librarian 在这一阶段利用句子切分工具 pySBD 将候选段落精准切分成单句,并在 Prompt 中为每一个句子打上唯一的数字索引(如 [S1], [S2])。
随后,中央 LLM 进行单次端到端评估调用。在这一步中,模型执行的是交叉编码(Cross-Encoding)逻辑:它同时对原始问题和包含全部候选句子的上下文进行双向注意力机制计算,直接输出一个按相关度排序的句子 ID 列表。这种设计兼具了三项功能:剔除假阳性无关段落、重排核心论据,并精准定位具体支持句。更精妙的是工程效率上的权衡:模型仅需解码几个简短的数字编号,而无需重复生成冗长的文字,这使得第三阶段的推理延迟和 Token 开销被压缩到极低水平。最终,系统将排名靠前的证据句子按照源文献聚类,连同文献 DOI、作者等完整元数据和最初命中的检索查询一同打包,以紧凑的数据结构递交回上层智能体。
整个流程对底层驱动模型没有任何特定微调绑定,属于完全的“模型无关(Model-Agnostic)”设计。在论文的基准实验中,作者团队选用了自建的高性能算力节点,基于 vLLM 部署的开源大模型 GLM-5 充当这一过程的中央控制器。
实验全景:四大基准上的系统性性能验证
为了验证这一非侵入式“知识层”的真实威力,研究团队在四个极具挑战性且各具侧重的基准测试集上展开了严格对照。这些测试涵盖了从宽泛的综述写作到严苛的湿实验协议排错,全方位压榨检索模块的能力边界。
1. ScholarQA-Bench:跨文献广域综合任务
ScholarQA-Bench 汇集了由博士级专家撰写的复杂开放式问题,解答这些问题需要智能体综合阅读多篇文献并输出带有准确引文的论述。测试聚焦在生物医药(Bio)、神经科学(Neu)及跨学科子集上。
实验结果表明,文献综合 Agent 在挂载 Librarian 后实现了跨越式提升。即便是使用相同的底层检索语料库,仅仅由于检索组织机制的进化,Librarian 在 Bio 分割集上的引用 F1 分数(Citation F1)相较于前沿文献智能体基线 OpenScholar-70B 提升了超 16 个百分点;在神经科学分支上也有着显著跃升。更关键的对比在于消融实验:当保持综合生成 Agent 的模型参数一致,仅仅将底层检索从原本基于 BM25 的离线数据存储切换为 Librarian 时,Bio 领域的引文 F1 依然直接跳升了 6.8 个点,Neu 领域更是暴增 10.9 个点。而在多学科交叉问题(Multi)中,单纯扩大大模型参数量并未带来收益,但接入 Librarian 知识层后,大模型综合评分获得了 20% 的硬性增长。这充分说明,跨文献综合的短板不在于生成模型“能不能写”,而在于前端检索是否送来了“真凭实据”。
2. ProClaim-eval:科学假设与共识裁决
科研场景中的另一大刚需是科学断言验证(Claim Verification),即判断现有文献共识究竟是“支持(Support)”、“反驳(Refute)”还是“证据不足(Uncertain)”。ProClaim-eval 包含了 419 项源自真实生物学数据库(如涉及蛋白质互作的 SIGNOR 和受体-配体互作的 ConnectomeDB)并经由专家标注真实结论的断言。
在该测试中,评测体系给出了极其鲜明的数据反馈:一个仅使用简单单步 Prompt 的基准验证智能体(Verifier Agent),在接入 Librarian 之后,与专家共识的平均一致性(Average Agreement)跃升了 15 个百分点,达到 0.66,远超检索 PubMed 和 Semantic Scholar 的传统组合。当进一步将既有的前沿验证系统 ProClaim 内部原生的检索模块整体替换为 Librarian 后,其与专家共识的吻合率从 0.75 进一步拉升至 0.80。相比之下,传统的 OpenScholar 基线仅录得 0.43 的一致性。这证明 Librarian 输出的证据句子具备极高的信噪比,几乎直接代劳了最繁重的“排查文献证据”阶段,使得下游判别模型只需专注于逻辑判定即可得出可靠结论。
3. Open-form LitQA2:穿透摘要的硬核事实检索
许多学术基准往往只需要读摘要就能答对题目,而 LitQA2 的设计初衷则是专门刁难大模型的“正文事实题”——所有题目的答案都深埋在论文的实验细节或方法正文深处,仅看 Abstract 必然答错。作者团队将其改造成了更为严格的开放问答形式(必须自主检索生成答案,而非多选题蒙猜),并筛选出 Europe PMC 具备全文记录的 91 道难题,测试目前顶尖的前沿商业模型 GPT-5.4。
评测显示了一个戏剧性的对比:在没有任何检索辅助的情况下,GPT-5.4 凭借自身参数记忆强行作答(覆盖率 Coverage 达到 100%),但因为深层知识遗忘与幻觉,其准确率与精度骤跌至 17.6%。在引入标准网络搜索(Web Search)后,模型准确率被拉升至 70.3%,证明了 RAG 的必要性。然而,当把通用的通用网页搜索替换为专门针对生命科学优化的 EMBL AI Librarian 之后,GPT-5.4 的回答精度提升了 6.4 个百分点(达到 82.6%),端到端准确率进一步提升 8.6 个百分点(升至 78.9%),同时有效回答覆盖率提升至 95.6%。这一组对比极其干净地剥离了模型底座的干扰,确证了针对垂直领域的专用文献知识层在应对深水区科研提问时的不可替代性。
4. LAB-Bench:基础生物学工作流与行为分化机制
在涵盖生物数据库检索(DbQA)、实验方案排错(ProtocolQA)、生物序列操纵(SeqQA)和分子克隆场景分析(Cloning Scenarios)的 LAB-Bench 评测中,研究人员观察到了一个极具启发性的现象:面对不同的基座模型,Librarian 展现出了完全不同的赋能机制。
对于推理能力稍弱一档的 GPT-4o,挂载 Librarian 带来的是一种“校准机制”(Calibration)。它的宏观准确率基本维持平盘(从 35.2% 微调至 35.3%),但其背后的精度(Precision)从 49.0% 显著提升至 54.0%,代价是回答覆盖率从 70.2% 下降到 64.8%。换言之,Librarian 紧凑严密的文献证据极大地遏制了 GPT-4o 依靠自身参数“胡思乱想”的倾向,当文献缺乏足够直接证据时,模型被促使选择“弃权”而非盲目编造。在要求严谨性的科研场景中,这种用少量覆盖率换取高置信度精度的交易极具实用价值。
而面对更强阶梯的 GPT-5.4,Librarian 则展现出了“覆盖跃升”(Coverage Expansion)的特征。其在回答精度保持高位稳定的同时,宏观覆盖率净增 6.8 个百分点。最典型的例证发生在处理生物分子序列的 SeqQA 任务中:GPT-5.4 的准确率从 52.5% 跃升至 63.8%,有效作答覆盖率从 85.0% 扩大至 98.8%。此时,模型本身具备极强的代码与逻辑分析能力,此前无法作答纯粹是因为“巧妇难为无米之炊”——它缺少特定的实验背景参数与序列上下游注释,而 Librarian 精准地为其输送了这块拼图。
值得注意的是,在纯粹考查数据库结构化查询的 DbQA 任务中,引入文献检索反而让两个模型的表现微降了 1 到 2 个百分点。这一负结果非常诚实地揭示了工具边界:纯粹的结构化数据库检索,理应由 SQL 或专用 API 接口来完成,强行通过非结构化学术文献绕路检索,不仅无益,反而会引入额外的噪声干扰。
关键认知与技术路线思考
EMBL AI Librarian 的成功,本质上是对当前大模型领域“一味做大预训练数据”以及“无脑堆砌向量数据库”两种工程惯性的反思。从这篇工作中,可以提炼出三个极具价值的行业判断:
其一,知识检索层与基座模型的解耦,是生命科学 AI 演进的必然趋势。 传统的学术 RAG 系统动辄要求为整个学科训练专门的嵌入模型、维护近 TB 级的向量索引,每次文献库更新都是一次运维灾难。Librarian 证明,底座模型负责逻辑推理与查询规划,成熟的公开文献库负责底层倒排索引与布尔召回,二者之间只需要一层轻量、透明且可校验的 Agent 交互逻辑即可打通。由于 Librarian 本身不依赖特化权重,当后方开源或闭源基座模型性能提升时,整个检索链路无需重构即可同步享受红利。
其二,“返回证据”远比“返回论文”更适合智能体生态。 过去的搜索工具服务于人类眼球,人类擅长扫读排版、跳读图表;但 Agent 的工作模式依赖线性的 Token 吞吐。Librarian 将检索单元打碎重组为携带源头溯源 URL 与查询语法的句子级证据包,既保留了科学研究不可或缺的“可证伪性与透明度”,又把下游 Agent 的上下文窗口从“垃圾信息载荷”中彻底解放出来。
当然,该系统依然存在现实局限。当前 Librarian 的知识边界仍严格受限于 Europe PMC 本身的开放获取范围,大量处于传统付费商业出版墙内的文献正文尚无法直接解析;此外,目前的检索属于单轮多查询扩展,尚未形成面对极其复杂反事实推演时的多轮自主追问(Multi-hop Routing)能力;更为关键的是,生命科学文献中包含大量承载关键实验数据的图表、凝胶电泳图与补充材料表格,而 Librarian 目前对图表信息的解析依然缺位。
但毫无疑问,将 Europe PMC 这座拥有数千万文献沉淀的生命科学殿堂“原生 Agent 化”,已经迈出了至关重要的一步。随着开源社区代码与评估框架的完整释放,这套不需要沉重向量数据库维护负担、即插即用的 AI 图书馆,正在为下一代真正能自主思考、自主验证假设的数字生物学家构筑起坚实可靠的证据地基。