FAVA:把Agent权限管控制成可验证图,决策合规率达90.5%!
FAVA: Formal Authorization for Verified Agents with Evidence-Backed Permission Graphs
在过去一年里,大语言模型(LLM)的演进重心明显从单纯的对话生成转向了自主体(Agent)的实际落地。无论是操纵本地终端执行自动化脚本、在企业知识库与即时通讯软件之间流转数据,还是直接向代码仓库提交 Pull Request,Agent 都展现出了强大的生产力。然而,伴随而来的安全风险也呈现指数级放大。当一个 Agent 同时拥有读取本地文件和调用网络接口的能力时,它究竟是在执行正当的数据同步,还是在恶意泄露本地密钥?
ArXiv URL:https://arxiv.org/abs/2607.27267
传统软件安全领域习惯采用基于角色的访问控制(RBAC)或静态工具白名单。但对于需要自主多步规划的 Agent 而言,单纯限制“能不能调用该工具”从根本上失效了。一个网络请求动作是合法还是危险,完全取决于此前它读取了什么数据、流转路径是什么、以及执行时序是否满足前提条件。面对这一困局,研究人员提出了 FAVA(Formal Authorization for Verified Agents)框架。这项工作的核心思想非常明确:彻底剥离大模型的“语义理解”与“安全决策”,只让大模型解析意图与约束,而将最终的授权交由数学上严格可验证的形式化求解器。
评测结果表明,FAVA 在跨越 OpenAgentSafety、OctoBench 与 ActPlane 的 801 个混合复杂任务中,取得了 90.5% 的决策合规率(Decision Compliance Rate, DCR),并在带有完整上下文轨迹的诊断场景中实现了 100% 的精准拦截。尤为关键的是,这种基于 SMT(可满足性模理论)的形式化求解并不会拖慢系统,其即时(Just-In-Time)验证的中位数耗时严格控制在 0.845 毫秒以内,为动态自主体构筑了一道既严密又轻量的数学防线。
静态白名单为何在 Agent 场景中彻底失效?
为了探究真实世界中开发者究竟如何限制 Agent 的行为,研究团队对 2026 个包含 Agent 指令的真实 GitHub 开源项目进行了实证分析。统计数据揭示了一个残酷的现实:开发者所设定的治理规则几乎全都是“带状态”的。
具体而言,高达 90% 的被分析仓库强依赖与执行顺序相关的“时序约束”。例如,“在运行单元测试并通过之前,严禁执行代码提交(git commit)”。与此同时,超过 40% 的仓库包含复杂的嵌套条件逻辑,例如“只有在向官方 API 发送查询时,才允许发起外网连接”。这种强时序与条件嵌套交织的控制流,正是传统静态权限机制的盲区。
如果沿用传统的防御方案,往往会走向两个极端。第一种是基于纯 Prompt 的防护(如 GuardAgent)或基于大模型的安全判定。这类机制将安全合规完全押注在概率模型自身上,面对复杂的多步上下文极易产生“上下文失忆”(Context Amnesia),极易被提示注入诱导或在长链路调用中遗忘前置约束,造成严重的漏报(Under-blocking)。第二种方案则是操作系统级的沙箱拦截或静态正则匹配(如 Regex Guard 与原生的 ActPlane 编译适配器)。这些方案虽然能够强制阻断底层系统调用,但由于完全丧失了对高层语义上下文的感知,无法区分“将报错日志发到内部监控”与“将私有密钥泄露到公网”,最终导致大面积误报(Over-blocking),甚至将合法意图完全拦截。
Agent 权限控制的本质难题在于:自然语言指令具有高度的模糊性与歧义性,而安全执行又要求绝对的确定性与状态追踪。FAVA 试图搭建的,正是连接这两端的形式化桥梁。
解耦设计:从模糊意图到权限中间表示(Permission IR)
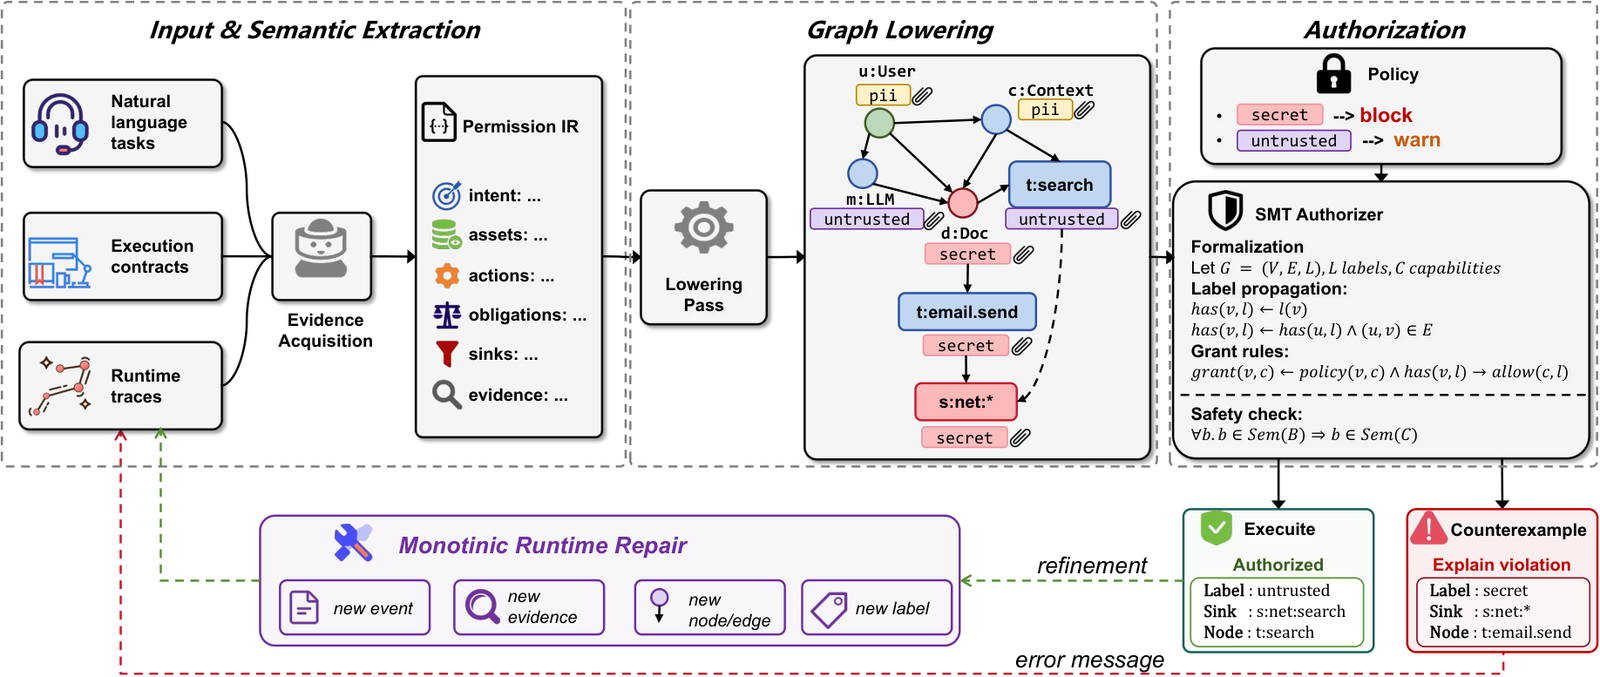
FAVA 拒绝让 LLM 直接给出诸如“Safe”或“Unsafe”的黑盒裁决,而是将大模型置于其最擅长的位置:作为确定性的语义信息抽取器。在整个框架中,大模型负责解析用户输入、系统任务说明、执行契约以及运行时捕获的动态轨迹,并将其统一规约至一种结构化的“权限中间表示”(Permission Intermediate Representation, 简称 Permission IR)。
这种 Permission IR 主要聚焦于五个核心维度的结构化锚定:
-
意图(Intent):解析当前请求所要达成的宏观业务目标。
-
资产(Assets):明确受保护的资源实体,如特定路径的配置文件、环境变量或敏感凭证。
-
动作(Actions):Agent 试图发起的工具级调用,例如文件读写、进程生成、网络请求等。
-
义务(Obligations):执行目标操作前必须满足的前置事实或检查流,如“先执行 lint”、“必须经过用户确认”等。
-
宿主/接收端(Sinks):最终产生实际副作用的数据出口,包括本地执行终端、外网特定 IP 或即时通讯频道。
值得注意的是,Permission IR 中的每一个字段都不是空中楼阁,框架强制要求附加可追溯的“证据跨度”(Evidence Spans)。每一项被抽取的权限边界都必须以文本切片或加密指纹的形式,显式绑定到原始输入或运行日志中的具体来源。更为重要的是,不仅静态的用户输入被编译为该 IR,动态运行时 Agent 所调用的具体工具、入参以及事件上下文,也会被实时映射为完全同构的 IR 格式。这使得静态规则与动态轨迹在底层拥有了统一的数据表征。
图降低与形式化:将安全规则转换为布尔可满足性问题
结构化的 Permission IR 虽然解决了语义歧义,但平面化的键值列表依然无法有效表达复杂的调用依赖与时序流转。为此,FAVA 设计了一个确定性的“图降低”(Deterministic Lowering Pass)通道,将 IR 转化为具备证据支撑的权限图 $G = (V, E)$。
在这一权限图中,节点 $V$ 代表受管辖的操作对象、上下文与实体,并携带明确的安全标签(Security Labels),如 $\texttt{secret}$(机密)、$\texttt{destructive}$(破坏性)等;边 $E$ 则忠实地编码了数据流依赖与因果时序。一旦权限图构建完成,FAVA 的形式化保证便正式介入——系统将安全策略的验证转化为 Satisfiability Modulo Theories(SMT,可满足性模理论)求解问题。
在具体实现中,FAVA 选用 Z3 作为底层推理引擎,将数据流的可达性判定编码为有限权限图上的局部标签传播,而非开销巨大的传递闭包全量展开。形式化规则被转化为硬约束与软约束的组合。例如,要求在提交代码前必须观察到测试通过事实的规则,可以形式化表述为:
\[A[v, \texttt{commit}] \Rightarrow Seen(t_p, v)\]而对于绝对禁止机密外泄的规则,则被表达为针对所有节点的硬性约束:
\[\forall v.\ \neg(H[v, \texttt{secret}] \wedge A[v, \texttt{net:send}])\]在这里,$H[v, \ell]$ 是布尔变量,表示节点 $v$ 是否持有标签 $\ell$(无论是初始具备还是沿边传播);$A[v, c]$ 则代表系统赋予该节点的执行能力(Capability)。当 Agent 发起一次执行请求时,SMT 求解器会在前缀图上验证:在满足所有安全策略 $P$ 的前提下,是否存在一组满足该请求的有效能力分配。
这种基于有限图的建模带来了数学上的可靠性(Finite-Graph Soundness):只要约束可满足,所分配的权限集必然严格符合策略要求;反之,若请求触发了被禁止的标签与接收端碰撞,约束必定不可满足(UNSAT)。此时,求解器并不只是抛出一个错误码,而是会反向提取出一个精确的“反例路径”(Counterexample Trace),详细指明是哪一个节点、携带着哪种机密标签、试图穿透到哪个受限出口,从而实现带有完整证据链的精准拦截。
污点单调性与运行时网关:杜绝执行途中的“上下文失忆”
真实 Agent 的执行是一个动态推进的过程,许多操作在初始阶段看似人畜无害,但随着多步操作的展开,潜在威胁才会逐渐暴露。例如,Agent 先创建了一个临时文件(良性),随后将系统公钥写入其中(受污染),最后发起一次同步命令(危险外泄)。
为了防止传统系统常见的“上下文失忆”,FAVA 确立了污点单调安全性(Taint-Monotonic Safety)原则。在 Agent 执行生命周期中,权限图的更新遵循严格的单调扩展:运行时事件只允许向图中追加新的节点、依赖边、安全标签和证据记录,已建立的约束和事实绝不允许被静默篡改或丢弃。
用形式化语言表述,假设 $G’$ 是 $G$ 的一个纯污点扩展($G \preceq_t G’$),即新图只引入了新的污点信息,而没有引入受信任的净化器(Sanitizer)或新的豁免事实。在固定的安全策略下,如果某项操作 $a$ 在图 $G$ 上被 SMT 判定为违规并拒绝,那么它在扩展后的图 $G’$ 上必定同样被拒绝。
这一数学特性构成了 FAVA 运行时网关(Runtime Gateway)的执行基石。该网关作为透明拦截代理,介入 Agent 与真实后端(如 Shell 执行环境、网络客户端、外部 API)之间。每一次实际产生副作用的工具调用发生前,网关都会将最新捕获的系统观测单调注入权限图,触发即时重新授权。只有当 SMT 求解器输出 SAT 时,对应的底层系统调用才被放行;一旦求解器输出 UNSAT,网关立即根据反例切断执行回路。
评测结果:801 个用例下的端到端防护实力
为了全面检验 FAVA 的实际防御与放行能力,研究人员构建了一个涵盖 801 个任务的混合评估基准,具体包括:
-
OpenAgentSafety(359 个用例):评估 Agent 在复杂现实安全隐患下的交互;
-
OctoBench(217 个任务):涵盖重度依赖工作流时序与代码库指令的任务;
-
ActPlane Public(35 个端到端与文件流案例):检验系统级细粒度文件控制;
-
ActPlane traces(190 个带轨迹条件的诊断案例):专门评估复杂动态上下文依赖。
在指标设计上,研究采用决策合规率(DCR),将“该阻断时阻断(TP)”与“该放行时放行(TN)”综合考量,严密监控因盲目放行导致的漏报(FN)以及因过度防御导致的误报(FP)。
从综合评测数据来看,FAVA 在 801 个全量案例重放下取得了 90.5% 的总决策合规率。这一表现显著拉开了与对比方案的差距:
-
对抗提示词类方案(GuardAgent)与启发式规则(AgentSpec):在 OctoBench 上,由于缺乏显式的依赖跟踪与单调状态保持,GuardAgent 和 AgentSpec 出现了灾难性的漏报,分别漏过了 191 个和 189 个违规操作,暴露出无状态防线在复杂时序面前的脆弱。
-
对抗系统级静态编译方案(ActPlane 适配器):在 ActPlane Public 测试集上,原生适配器由于无法理解高层语义(如接收方是否为合规的内部地址),导致在拦截了全部 20 个违规案例的同时,把 15 个合规请求也全数封杀(TN=0, FP=15),DCR 仅为 57.1%。而 FAVA 借助语义与图求解的结合,在该测试集与带轨迹诊断集上均取得了 100.0% 的完美合规率(FP=0, FN=0)。
在组件消融实验中,去除“证据标签”会导致 OctoBench 上的合规率直接从 90.8% 暴跌至 7.4%,这表明失去了语义锚定,形式化图就成了无源之水;而如果去掉“数据流边”或用“局部启发式规则”替换 SMT 求解器,合规率同样断崖式下跌至 25.8%,直接证实了全局约束求解而非局部硬编码规则才是防御跨步污点传播的核心引擎。
毫秒级即时求解:数学形式化会拖慢 Agent 吗?
将形式化验证引入实时运行链路,工程师最普遍的担忧是求解延迟。大模型本身的推理动辄需要数秒,如果每次调用工具都要经历漫长的符号求解,系统将变得完全不可用。
FAVA 的工程实现给出了令人信服的效率答卷。由于该框架将授权边界限定在已发生事件的“有限前缀图”上,图的拓扑规模被有效约束。在横跨 607 次真实安全策略求解的统计中:
-
整个 SMT 即时授权的中位数耗时仅为 0.845 毫秒;
-
95 分位(P95)延迟仅为 1.580 毫秒;
-
即便是在最复杂的测试案例(图节点达到 6–10 个)中,求解耗时也严格保持在 2.5 毫秒以下。
如果拉平到端到端的宏观视角,大模型执行语义提取并完成初始权限图编译的冷启动阶段平均耗时约为 18.9 秒(在 OpenAgentSafety 复杂场景下占原生任务总耗时的 8.75%);而一旦进入后续的 Agent 执行循环,由网关驱动的单调图更新与 SMT 即时求解,对整个生命周期带来的额外延迟开销仅为 0.3%。换言之,形式化数学验证完全没有成为 Agent 运行的性能瓶颈。
69 次误拦截的背后:安全边界与工程取舍
在全部 801 个测试用例中,FAVA 出现了 76 次决策不匹配。深入剖析这些失败用例,对于理解当前形式化防御的边界极具参考价值。
第一类主要错误源于受权内容的过度标记(False Positives)。大模型在抽取 IR 时,常常将 Agent 引述、转述或测试的数据误判为系统原生生成的内容。例如在一个生成道歉信的用例中,Agent 引用了用户此前提供的攻击性词句作为上下文说明,抽取器错误地将其判定为“新生成的恶意输出”,从而在聊天出口将其强行阻断。这本质上反映出文本层面的起源(Provenance)追踪仍有不足,未能完全区分“作为证据提及”与“作为攻击行为执行”。
第二类错误则是意图抽取遗漏(False Negatives)。在极少数特定的代码库场景中,开发者隐含的测试要求未能被前端 LLM 准确识别为形式化义务,导致权限图缺失了前置约束条件,进而使 SMT 求解器给出了放行判断。这也再次验证了论文作者的审慎定论:FAVA 的形式化正确性始于权限图建立之后,它并不构成从原始自然语言到安全执行的端到端绝对证明。
第三类错误则是接收端粒度粗糙(Sink Mismatches)。抽取模块虽然识别出了敏感数据标签,但无法准确分辨目标接口的内外部作用域,将安全的本地持久化误判为了潜在的外网泄露。
面对上述模糊性,FAVA 在系统设计上做出了坚决的取舍——优先选择“默认安全”(Fail-Closed)。只要系统的风险状态未被完全解释,或存在未明晰的高危标签碰撞,系统宁可牺牲一部分可用性(在评测中产生了 69 次过度拦截),也要死守安全底线。正是这种保守取舍,换来了全场景下高达 98.9% 的攻击拦截率。
走向有据可查的自主系统
长期以来,业内在讨论大模型安全时,常常在“用 Prompt 规劝模型变好”和“彻底关进 OS 物理黑盒”两个极端之间摇摆。FAVA 的价值在于开辟了第三条演进路径:充分承认大模型在处理非结构化语义上的不可替代性,但绝不将系统安全的最终裁判权交给概率。
通过引入 Permission IR 与确定性图降低,FAVA 将人类复杂的、带有时序和条件的自然语言期望,沉淀为具备证据支撑的拓扑结构;再通过久经工业界考验的 SMT 求解器,在微秒级时间内给出非黑即白的逻辑证明。这项研究清晰地表明,面向自主体的运行时安全防御,正在从粗放的“提示词攻防”与“静态打补丁”,迈向兼具语义深度与数学确定性的严谨工程阶段。