CAPA:用跨会话记忆消除反复追问,首轮可执行成功率提升15.6个百分点!
Fewer Clarifications, Better Code: Benchmarking Cross-Session Personalized Ambiguity Adaptation in Coding Assistants
程序员在使用 AI 编程助手时,常常陷入一种恼人的循环:每次新开一个对话窗口,只要描述稍有模糊,模型要么做出一套看似合理却完全偏离习惯的代码,要么机械地抛出好几个澄清问题。即便开发者在过去几十个会话里反复确认过“对,数据归一化我一律默认用 Z-score,别再用 Min-Max 搞错了”,一旦上下文被清空,AI 就会重置为最平庸的“出厂设置”。
ArXiv URL:https://arxiv.org/abs/2607.26611v1
以往的研究通常把这拆解为两个孤立命题:做“歧义消除”的学者倾向于把每次对话当作独立事件,研究模型怎么提问最有效;而做“长期记忆”与“个性化”的研究,大多停留在事实检索层面(比如记住用户的操作系统或偏好语言),很少触及代码逻辑层面的习惯推断。来自东南大学与香港科技大学的研究团队在最新工作中直指这一盲区:用户的模糊表达并非随机噪声,而是具有高度个性化且跨任务稳定复现的“歧义模式”。
为此,他们形式化定义了“个性化歧义自适应”(Personalized Ambiguity Adaptation)任务,并构建了首个基准数据集 CAPA(Cross-Session Adaptation to Personalized Ambiguity)。实验覆盖 12 款主流前沿大模型,结果显示:引入同用户的历史会话后,模型的可执行成功率平均提升 6.8 个百分点,而首轮直接可执行成功率(FT-ES)平均提升了 15.6 个百分点,平均交互轮数明显减少。这表明,AI 编程助手完全有潜力借助过往历史在首轮就“心领神会”,而非一次次向用户打断追问。
为什么长期编程助手不能总把澄清挂在嘴边?
现有的交互式代码基准测试大多关注功能实现的正确性,比如经典的 HumanEval、MBPP,或者考验多轮交互排错的 SWE-bench。但真实人机协作的成本并不只由最终代码跑不跑得通决定,更由交互效率决定。
如果开发者抛出一句“写个数据归一化函数”,AI 面临着分歧路径。理想的长期助手应当像熟稔的搭档一样,调取该用户过往会话中形成的稳定默契,在第一轮直接给出预期实现;只有当历史会话毫无依据时,才主动发起澄清。
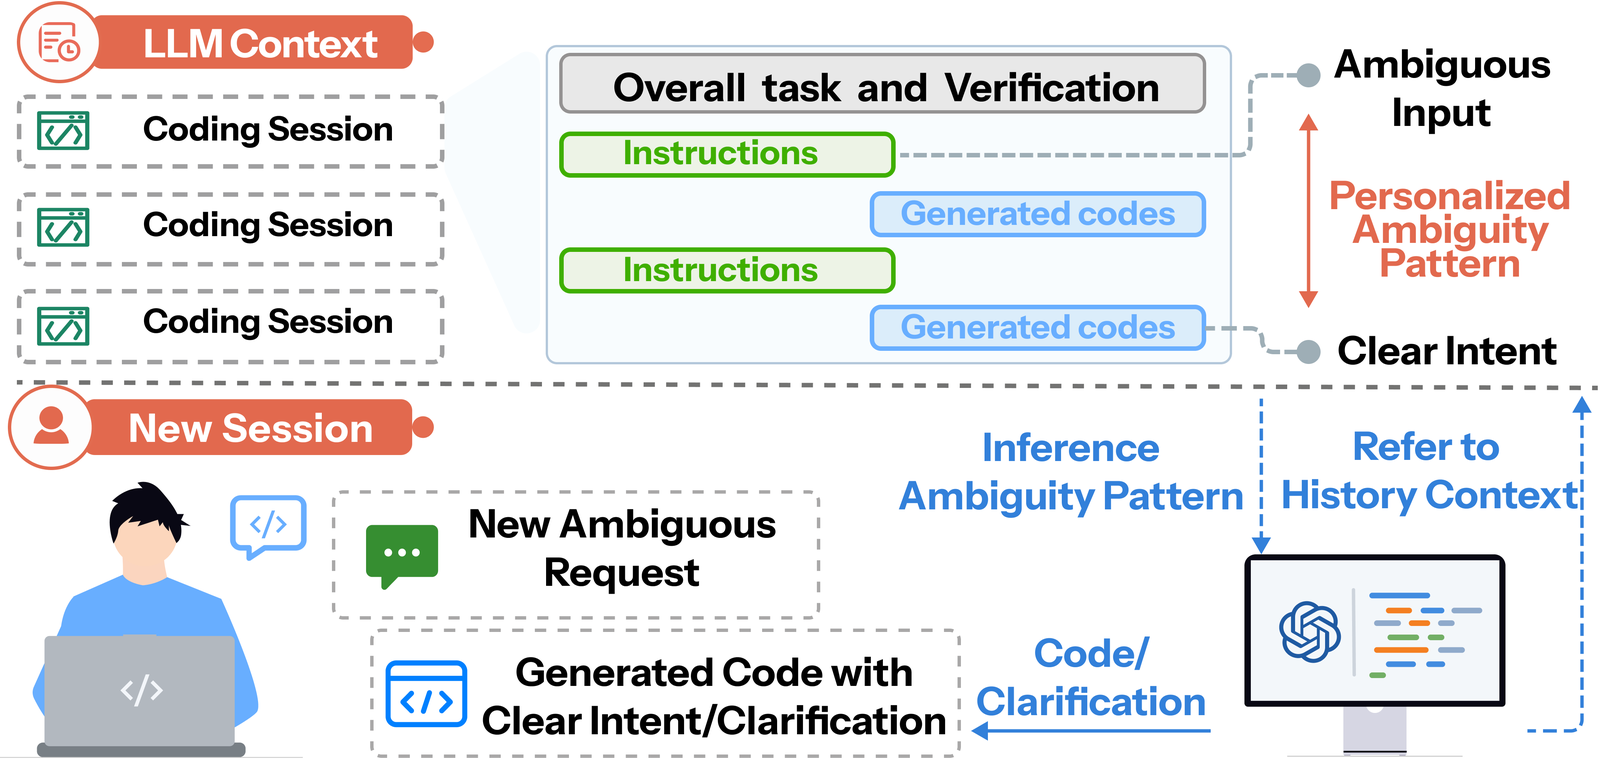
为了把这种默契程度量化,研究团队设定了任务结构:给定同一个用户过往已经解决的 $n$ 个完整代码会话历史 $H_i^{(n)}$,当该用户在全新的保留会话(Held-out Session)中提出一个暗含模糊意图的初始需求 $u_{i,k}^{(0)}$ 时,AI 需要完成自适应推理。
评估的核心指标不再只有“任务最终是否完成”,而是由三维标尺构成:
-
可执行成功率(Executable Success, ES):在限定轮数(8 轮)内代码能否通过隐藏测试集。
-
首轮可执行成功率(First-Turn Executable Success, FT-ES):模型在没有额外追问澄清、第一轮直接生成代码的前提下,能否一把通过测试。
-
完成所需轮数(Turns-to-Completion, TTC):反映交互成本,越低代表模型越懂用户。
六大代码歧义机制与 CAPA 的生成管线
要评估模型是否真的“理解了用户特定的模糊习惯”,最大的难点在于如何规模化构建既保留严格测试集、又包含真实跨会话歧义模式的评估集。
研究者借鉴了语言学中的歧义分类,并结合真实人类与 LLM 编程对话(WildChat)的观察,重构成针对编程场景的六大个性化歧义机制:
-
领域认知多义(Domain-cognitive polysemy):专业术语存在多种数学或工程实现,用户默认使用某一特定范式。
-
结构逻辑错位(Structural logic misalignment):业务处理流程的拓扑顺序在用户脑中被省略。
-
习惯性上下文缺失(Habitual context omission):开发者习惯性认为助手“理所当然知道输入数据的特定格式或前置环境”。
-
系统边界误解(System-boundary misconception):对底层调用边界、库依赖或异常处理假设存在固定偏见。
-
对话语境错位(Conversational context misalignment):使用代词或抽象指代指代前序步骤,但缺少显式关联。
-
隐式约束欠定义(Implicit constraint under-specification):对时间复杂度、空间消耗或特定极值行为未加说明,但实际有严格期待。
人工标注实验验证了这套机制的可辨识度,20 名标注者的 Fleiss’ $\kappa$ 达到 0.66,证明这套分类具备坚实的经验支撑。
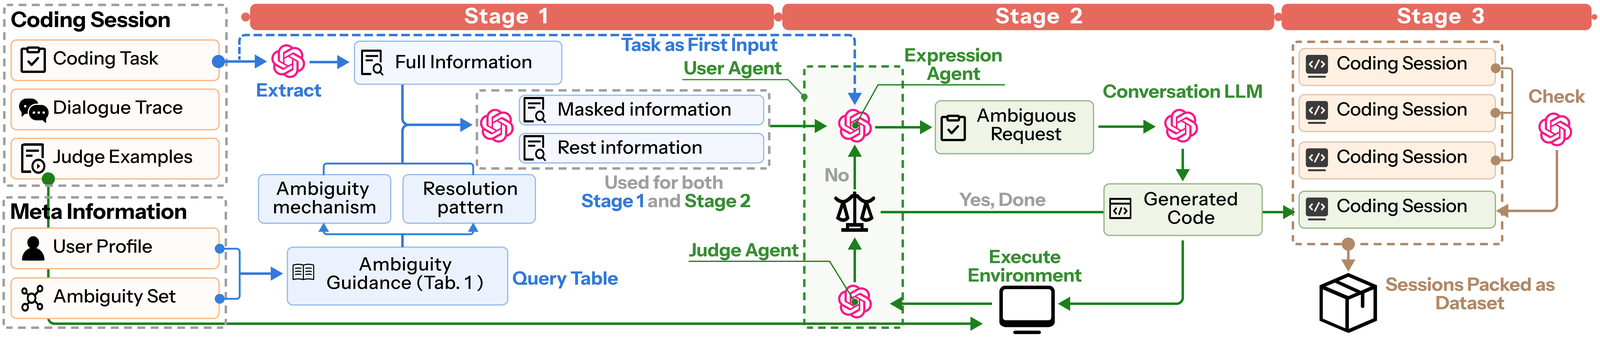
在此基础上,CAPA 搭建了一套受控的三阶段生成管线:
-
第一阶段(注入歧义):选取 HumanEval 中无歧义的明确任务,结合设定的用户画像与特定歧义机制,精准剔除或隐匿关键实现信息,生成模糊初始需求。
-
第二阶段(多轮推演):利用模拟环境展开多轮交互,直至代码通过执行判题,记录完整对话轨迹。
-
第三阶段(跨会话一致性校验):这是保证评估有效性的关键步。新生成的任务轨迹必须与该用户既有的模糊解法模式进行对齐比对,只有确保用户在跨任务时保持行为一致性,才会被收录入轨迹集合。
最终的 CAPA 数据集包含 600 个编码会话,划分为 60 个均衡的“用户—歧义对”单元,其中 300 个会话充当历史上下文,另外 300 个保留会话用于端到端评估。
历史不仅带来代码正确性,更显著重塑交互效率
研究团队对 12 款主流大语言模型进行了全面测试,涵盖闭源前沿模型(GPT-5.5、GPT-5.6-Sol、Claude Opus 4.8、Claude Sonnet 4.6、Gemini 3.5 Flash)、前沿开放模型(DeepSeek V4 Pro、Kimi K2.6、GLM-5.2、Qwen3.7-Max)以及开源轻量级模型(Llama-3.3-70B-Instruct、Qwen3-8B、Qwen3.5-27B)。
实验揭示出一个极其鲜明的核心现象:跨会话历史对于代码最终是否可执行的提升是温和的,但对于交互效率的提升却是颠覆性的。
在全部 12 款模型中,注入同用户历史使得 ES 平均提高了 6.8 个百分点,而首轮成功率 FT-ES 却平均飙升了 15.6 个百分点,平均完成轮数 TTC 降低了 0.81 轮。以表现最为突出的 GPT-5.5 为例,其整体任务成功率从基线的较高水平进一步提高了 10.0 个百分点,但首轮成功率直接大幅跃升了 28.7 个百分点,TTC 减少了近 1.45 轮。
这说明在无历史时,先进模型虽然也能通过多轮试错或向用户发问把问题搞懂并解决,但体验是极其割裂的;而一旦拥有历史,模型几乎可以在首次回答时就押中用户的核心诉求,直接省去了反复拉扯。
深入剖析:任务难度、用户身份与记忆系统的失效
为了厘清这些收益背后的深层动力,作者围绕三个关键问题展开了对照实验:
其一,任务本身变难时,自适应能力还能保持吗?
根据无历史基线下的解决轮数,保留评估集被严格划分为简单(1-2 轮)、中等(3-4 轮)和复杂任务(5-8 轮)。在 GPT-5.5、DeepSeek V4 Pro 与 GLM-5.2 上的测试表明:在复杂任务上,即便提供了同用户历史,模型的 FT-ES 依然出现明显下跌,ES 相对简单任务滑落了 20.7 到 26.4 个百分点。这意味着当代码本身的算法拓扑复杂化时,模型很难一边在脑中推演庞大逻辑,一边平稳检索利用跨会话的微弱先验。
其二,模型真的认得出是“这个人”,还是单纯占了 Few-shot 的便宜?
如果往 Context 塞进别人解决问题的会话,模型是否也能获得同等提升?作者设置了混淆历史(Shuffled History)实验:用其他用户的历史会话等量替换当前用户的真实历史。
结果十分微妙:由于混淆历史中依然包含高质量的人机代码对话模式,模型的 ES 比零历史 baseline 确实有所改善(提升最高达 10.67 个百分点);但在衡量真正“懂你”的 FT-ES 指标上,正确匹配的同用户历史展现出了无可替代的优势——在各个模型上均比混淆历史额外高出 2.0 到 12.0 个百分点。这决定性地证明,模型所利用的确实是跨任务复现的特定用户解题偏好,而非通用的交互惯性。
其三,现有的长程记忆管理框架(如 Mem0、A-mem)能直接套用吗?
直觉上,把会话总结成记忆笔记再进行 RAG 应该比硬塞原始完整历史更高效。然而对照实验给出了令人警惕的结论:现成的通用记忆组件在 DeepSeek V4 Pro 和 GLM-5.2 上的表现全面溃败于直接拼接原始会话上下文(Raw History),在 GPT-5.5 上也仅仅互有胜负。
原因在于目标错位。现存记忆库大多聚焦于“实体与事实抽取”(如:用户叫什么名字、用什么配置),而代码个性化歧义需要识别的是“程序语义映射规则”(即:当他说 A 时,代码应该写成 B 还是 C)。通用记忆在抽取时,轻而易举地把这些最关键的代码实现分歧当作细枝末节过滤掉了。
轻量化门控机制:让 AI 学会何时该猜测,何时该追问
既然通用记忆系统水土不服,直接塞历史又会受制于上下文窗口与注意力稀释,应该如何优雅地激活跨会话历史?
作者提出了一种无需微调的轻量化推断方案:同用户历史门控(Same-User History Gating)。
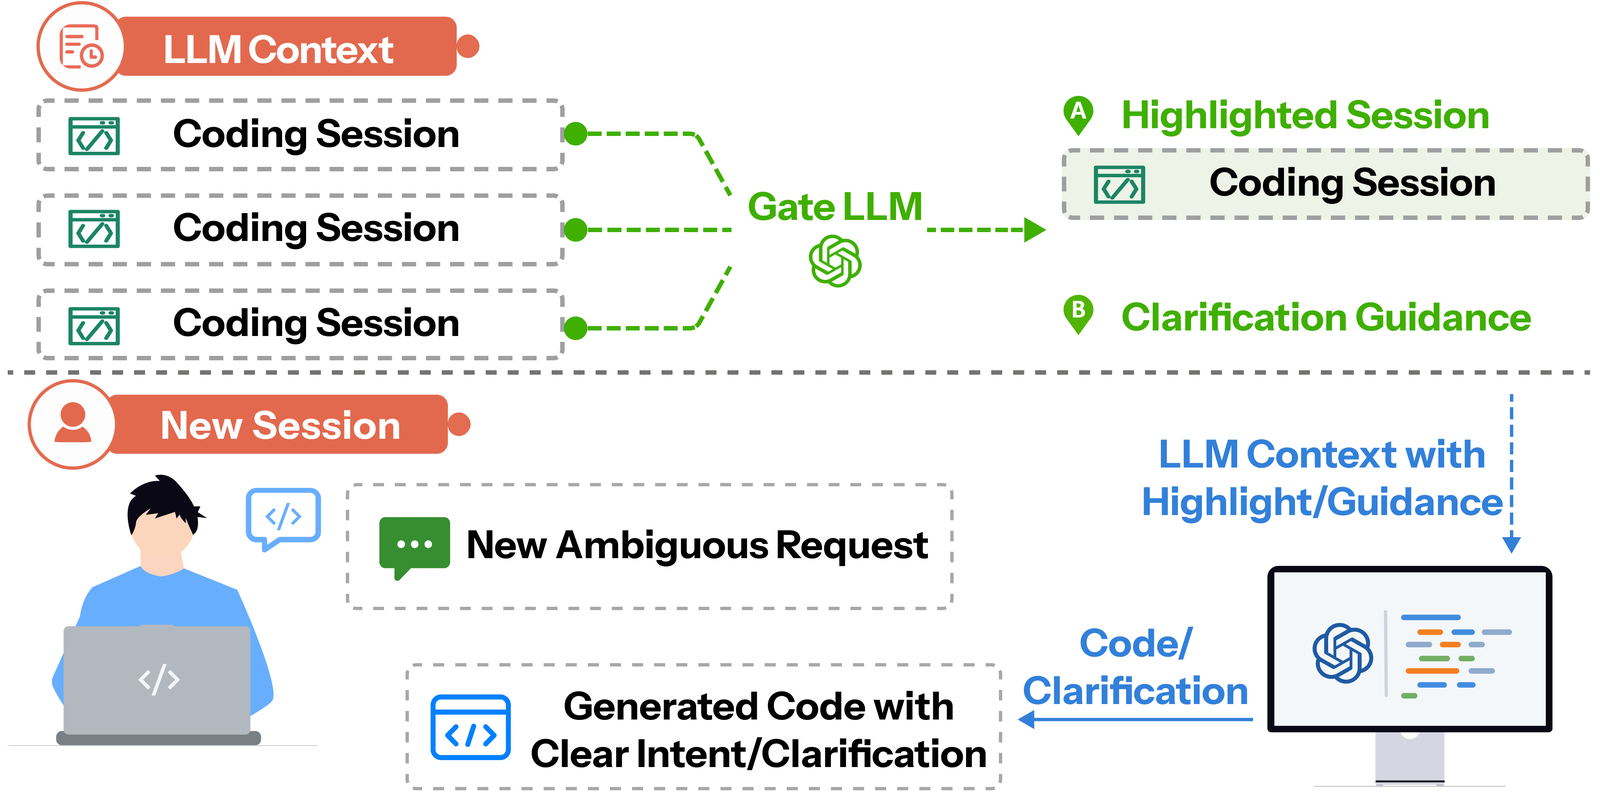
该方案引入了一个微型的 Gate LLM 角色,位于交互的最前端:
-
在收到新模糊需求后,门控首先审视已归档的历史会话,判断历史中是否存在足够且一致的歧义消解证据。
-
若证据充分,门控并不把所有历史倾泻给主模型,而是高亮指出最具有参考价值的那一个关键历史片段,为主模型直接生成代码提供高信度背书;
-
若证据不足或相互冲突,门控则生成澄清引导(Clarification Guidance),提示主模型在哪些维度确实无法断定,从而向用户发起针对性的精准追问。
在 GPT-5.5、DeepSeek V4 Pro 以及 GLM-5.2 的验证中,这种纯推断时的门控机制全面击败了 Mem0 和 A-mem,不仅在首轮可执行成功率上创下新高,还进一步压低了全流程的完成轮数。
走向更自然的开发者副驾
长期以来,AI 编程工具的发展重心高度集中在模型单次输出的代码能力上,但在软件工程中,大部分摩擦往往出现在人与 AI 的“对齐与沟通成本”中。频繁弹出的澄清询问会击碎开发者的心流,而盲目的胡乱猜测则会导致后期极高排错代价。
CAPA 这一工作的启发在于,它正式将“人机协作中的默契”从玄学讨论拉入了严谨的可评测科学之中。实验证明,大语言模型已经具备了相当程度的潜能,能够从过去的足迹中解读出某个特定工程师独特的隐式思维模式。未来的编程助手要想从好用走向不可或缺,关键不仅在于刷高单元测试的基准分,更在于能否像一位长年并肩作战的资深搭档那样:少一些无效的反复追问,在第一轮对话里,就把最贴合你心意的那行代码直接写出来。