LedgerMind:给多模态推理立结构化账本,破解虚假锚定与过度思考
LEDGERMIND: Provenance-Constrained Multimodal Agentic Reasoning with a Structured Evidence Ledger
在多模态大模型的基准测试榜单上,我们常常看到极具迷惑性的高分。一个负责视觉问答的智能体(Agent)可能调用了四五次图像缩放工具,检索了外部网页,洋洋洒洒输出了一长段包含大量公式与引用的推理轨迹,最后给出了正确答案。然而,一旦将这段推理链条拆开审计,就会发现令人不安的事实:模型给出的最终答案,往往并非基于它调用的工具观测,而是源于预训练语言先验的猜测,抑或是多处推理错误偶然相互抵消的巧合。更普遍的现象是,模型在文本中煞有介事地标注了引用标记,引述的内容却包含了工具输出中根本不存在的实体与数值。
ArXiv URL:https://arxiv.org/abs/2607.28374
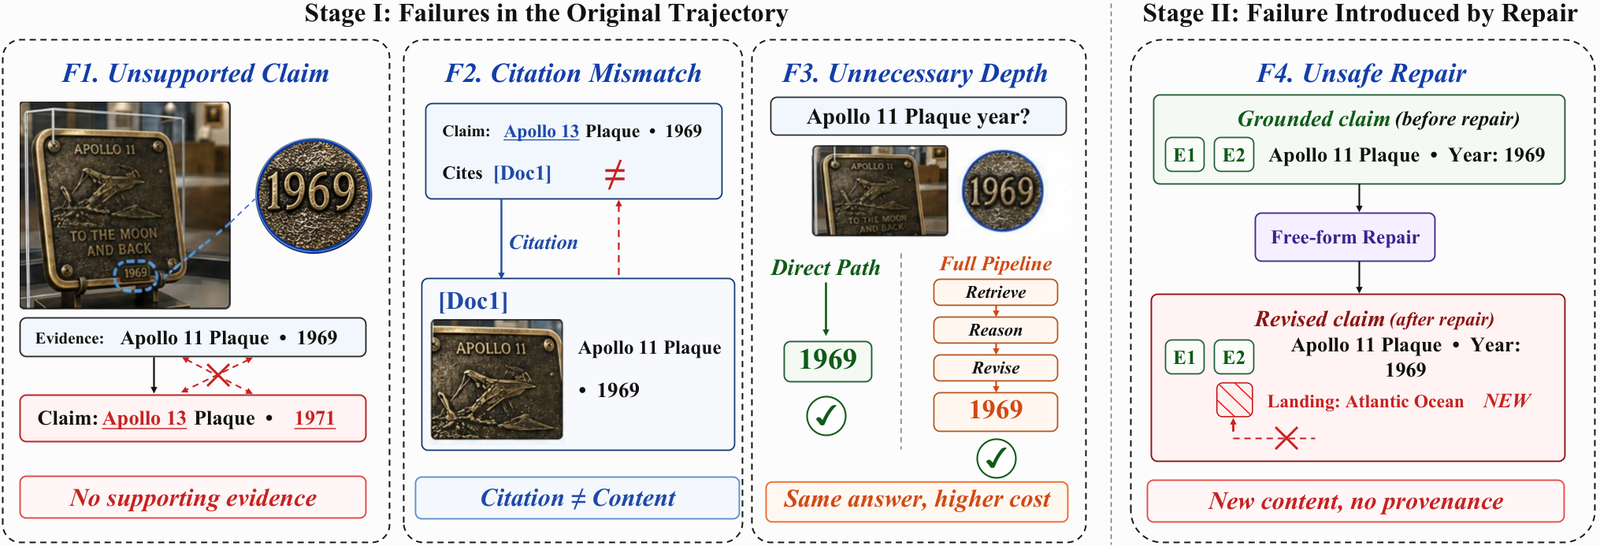
这种现象被称为“虚假锚定”(Phantom Grounding)——推理看似有据可查,实则纯属幻觉。造成这种现象的根源在于,当前几乎所有主流多模态智能体框架,都把推理轨迹实现为一个非结构化的自由文本缓存区(Free-form Text Buffer)。工具返回值、模型臆想的事实、自我纠错的文本全部混杂在上下文窗口中,模型很容易在下一步推理中凭空制造无源信息。针对这一痛点,最新研究提出了 LedgerMind,其核心理念是将多模态智能体的交互轨迹形式化为一个“带溯源约束的状态机”(Provenance-Constrained State Machine)。
LedgerMind 不依赖任何微调或参数训练,而是通过运行时机制对多模态推理全流程建立严格的证据审计。它在多模态基准 VTC-Bench 上取得了 $58.9\%$ 的准确率刷新业界纪录,使 GPT-4o 提升达 $+23.3$ 分;在兼具严苛视觉理解的 Hard-200 压力测试集上,全面提升了覆盖四个厂商的六大多模态模型基准性能。这项工作揭示了一个关键趋势:评估多模态智能体的标准,正从单一维度的最终答案准确率,走向全链路可审计的轨迹忠实度(Trajectory Faithfulness)。
为什么自由文本推理必然导致幻觉放大?
现有多模态推理框架普遍依赖“思维链”(Chain-of-Thought, CoT)及其衍生变体(如 ReAct、Reflexion)。这类方法假设,只要给予模型多步思考和自我修正的空间,复杂问题就能迎刃而解。但在严密的工业级或专业级场景下,自由文本推理暴露了四个系统性缺陷:
其一是无依据推理(Unsupported Intermediate Reasoning)。在多步推演中,模型推导出的命题往往直接脱离了感知事实,依靠语言模型的联想能力滑向虚构推断。
其二是具有欺骗性的虚假锚定(Phantom Grounding)。模型学会了在生成内容时附带引用编号(例如“根据观测 [1]”),但实际上引用的字段中并未出现该实体,甚至数值被篡改。
其三是过度思考悖论(Over-Reasoning Paradox)。并非所有问题都需要调用多轮工具进行深度推理。在面对简单视觉问答时,盲目执行深层工具调用反而会引入环境噪声,稀释关键线索,导致简单题目答错。
其四是自纠错放大错误(Repair-Time Amplification)。学界已有诸多证据表明,在缺乏强确定性外部信号时,语言模型的自由文本自我反思(Self-Reflection)并不可靠。模型在反思阶段极易编造新的未经证实的前提,反而导致错误级联扩大。
LedgerMind 的切入点正是彻底抛弃非结构化文本缓存,为整个轨迹建立确定性的“证据账本”。
核心机制:结构化证据账本与状态约束
在 LedgerMind 中,智能体每一次与物理世界或工具交互产生的原始数据,都不能以未清洗的文本形式直接倾倒进推理上下文,而是必须被规整为一条条具名且带有元数据的“结构化证据账本”(Structured Evidence Ledger)条目。
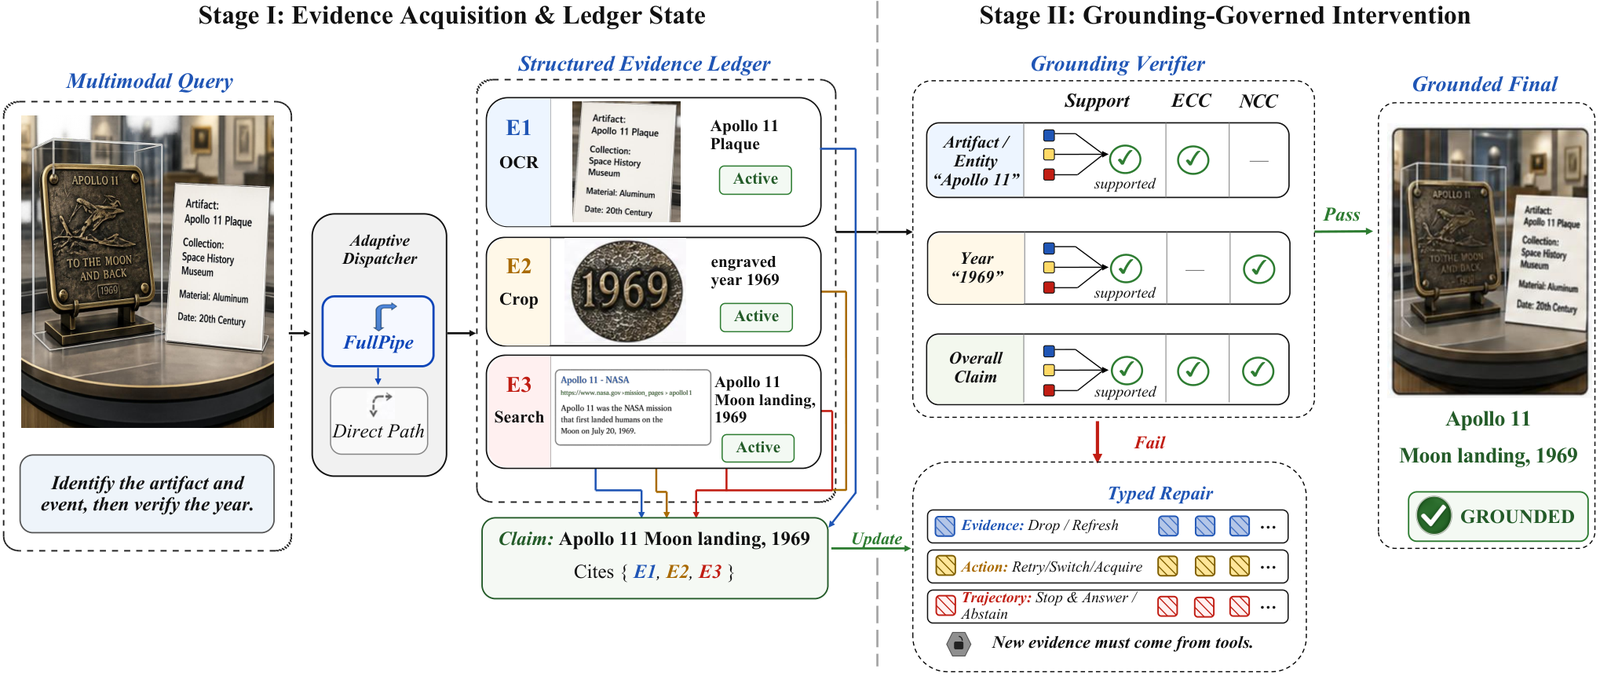
账本条目具有明确的类型划分。原始感知与检索操作生成基础的叶节点条目,而模型在推理过程中做出的推断则被划分为三类断言(Claims):
-
观测断言(Observation Claims, OC):对工具输出的原生直录,严禁包含推断性内容;
-
状态断言(State Claims, SC):基于已有证据条目的归纳、聚合与跨步推演;
-
决策断言(Decision Claims, DC):直接决定最终答案 $\hat{y}$ 的终局命题。
这种分层断言体系带来了一个革命性的转变:断言必须带有显式的溯源引用,且下游推断只能引用账本中当前处于激活状态(Active)的有效条目。如果一个断言引用了推导类条目,系统在校验时会递归解开其依赖树,一直追溯至底层的感知(Perception)或检索(Retrieval)叶节点池 $\mathcal{P}_{c}$:
\[\mathcal{P}_{c}=\{f_{e}:e\in S_{\mathrm{leaf}}(c),\;\kappa(e)\in\{\textsc{Perception},\textsc{Retrieval}\}\}\]这意味着,模型在后续推理中提出的任何中间结论,都无法通过套娃式的自我引用来“洗白”虚假事实。
实体与数值级双重死锁:阻断虚假锚定
拥有引用池还不够,模型完全可能在引用真实条目的同时,在句中加入幻觉实体或捏造数据。为了实现不可篡改的锚定审计,LedgerMind 部署了三层锚定协议(Three-Layer Grounding Protocol),对断言与证据池的匹配程度进行细粒度数学检验。
第一层是词元级别的支持覆盖率 $\rho(c)$,用于计算断言在被引用证据内容中的语义重叠度:
\[\rho(c)=\frac{\lvert \mathrm{Tok}(c)\cap\bigcup_{e\in S(c)}\mathrm{Tok}(f_{e}) \rvert}{\lvert \mathrm{Tok}(c) \rvert}\]更为致命和关键的是后两层:实体包含检查(Entity Containment Check, ECC)与数值相容检查(Numeric Compatibility Check, NCC)。很多时候,模型偷换一个实体名或更改一个数值,就能彻底颠覆结论。ECC 强行要求断言中所出现的所有实体,必须严格落在引用证据实体集或其合规别名库内:
\[\mathrm{ECC}(c)=\mathbf{1}\!\left[\mathrm{Ent}(c)\subseteq\mathrm{Ent}(\mathcal{P}_{c})\cup\mathrm{Alias}(\mathcal{P}_{c})\right]\]而在 NCC 中,针对年份、计数、日期、选项编号等离散数值,公差严格设为零($\Delta_u = 0$);仅对视觉度量等连续数值开放一个极小的相对允许容差:
\[\mathrm{NCC}(c)=\mathbf{1}\!\left[\forall v_{c}\in\mathrm{Num}(c),\;\exists v_{e}\in\mathrm{Num}(\mathcal{P}_{c}):\ \vert{}v_{c}-v_{e}\vert{}\leq\Delta_{u(v_{c})}(v_{e})\right]\]一旦某条推导未能通过 ECC 或 NCC 检查,系统会直接将其判定为“结论-证据不匹配”,瞬间将该断言的置信度剥夺至阈值以下,直接拦截假锚定的下游传递。
自适应双路径分发:治愈过度思考
面对不同难度的输入,统一使用多步重型推理框架不仅成本高昂,更极易引发过度思考。LedgerMind 内置了一个确定性的复杂度分类器 $\phi(q)$,构建自适应双路径分发器(Adaptive Dual-Path Dispatcher):
\[\hat{y}=\begin{cases}\textsc{Direct}(q,\mathcal{I})&\phi(q)=\texttt{simple}\\[2.0pt] \textsc{FullPipe}(q,\mathcal{I})&\phi(q)=\texttt{complex}\end{cases}\]对于单步视觉确认或浅层事实检索类问题,系统直接走浅层直连路径(Direct Path),限制工具调用预算,避免生成亢长的推导链;对于涉及多图、长程推导或跨模态对齐的问题,则激活完整链路(FullPipe Path),调动任务规划、双重读取验证(Dual-Read Verification)与局部裁剪放大。
无论走哪条路径,所有输出都受制于同一个证据账本接口。这一设计的精妙之处在于,它不是粗暴地截断上下文,而是从控制流源头根据问题属性匹配推理深度,既守住了简单样本的高准确率,又避免了无关感知噪声污染长程链条。
类型化修复与溯源非放大保证
当断言被拦截、工具调用异常或证据出现冲突时,智能体该如何自愈?以往系统往往直接让大模型基于错误信息进行无约束的语言自我反思,这往往造成二次幻觉。LedgerMind 彻底抛弃了自由反思机制,将修复动作严格收敛为三层共七个“类型化状态转移算子”(Typed Operators):
-
证据层修复:丢弃非法条目(Drop)、重新获取证据(Refresh);
-
动作层修复:工具重试(Retry)、工具切换(Switch)、追加证据采集(Acquire);
-
轨迹层修复:终止并作答(StopAndAnswer)、合规放弃回答(Abstain)。
这一设计带来了重要的理论安全性——溯源非放大命题(Proposition 1: Provenance Non-Amplification)。在数学上可以严格证明:对于任意类型化修复算子 $r \in \mathcal{R}$,修复后账本生成的所有新条目,要么是工具的原生观测输出,要么是经过确定性模版映射生成的推导,绝对无法凭空引入未经验证的全新外部内容。
换句话说,模型在自愈过程中被彻底剥夺了“用文字糊弄文字”的权力。即使工具返回了错误的信息,错误也会被锁定在具名条目上,保持百分之百的可追溯性,杜绝了无源自发性幻觉的滋生。
实验评测:不仅是提分,更是推理过程的重塑
为了验证这种严格账本约束对智能体究竟意味着什么,研究团队在六大公开多模态评测集(VTC-Bench、MMStar、MMMU、MMMU-Pro、EMMA、MC-Search)以及自主构建的极端复杂视觉基准 Hard-200 上展开了系统评估。
评测基座涵盖了业内最具代表性的前沿模型,包括 GPT-4o / GPT-5.5、Gemini-3-Flash / 3.1-Pro、Claude-Sonnet-4.6 / Opus-4.7 以及 Kimi-K2.6。所有对比均在相同的工具预算与思维预算下完成,消除了单纯由于算力堆叠带来的表现差异。
在以工具交互为主的多模态基准 VTC-Bench 上,搭载 Gemini-3-Flash 的 LedgerMind 取得了 $58.9\%$ 的整体准确率,刷新了专有工具及多模态通用基线的最高纪录。尤为惊人的是,原本在长链条工具调用中频现幻觉的 GPT-4o,在接入 LedgerMind 运行时后准确率狂飙了 $+23.3$ 分;Gemini-3.1-Pro 与 Gemini-3-Flash 也分别取得了 $+11.8$ 和 $+12.4$ 分的坚实跃升。这种大幅提升不仅存在于顶级模型中,基座越弱的模型提升幅度反而越显著,有力证明了结构化控制机制的普适价值。
在考验高阶多模态综合推理的 EMMA 基准中,LedgerMind 总体提升了 $+9.58$ 个百分点。深入学科分布可以看到,数学(Math)与物理(Physics)子项的提升幅度分别高达 $+16.15$ 与 $+16.02$ 百分点。这类学科的典型特征在于高度依赖精确的几何图形读取、图表数值核对与多步符号推导,正是虚假锚定与自纠错误差放大的重灾区,ECC 与 NCC 的数值硬约束在此展现出极强的防御力。
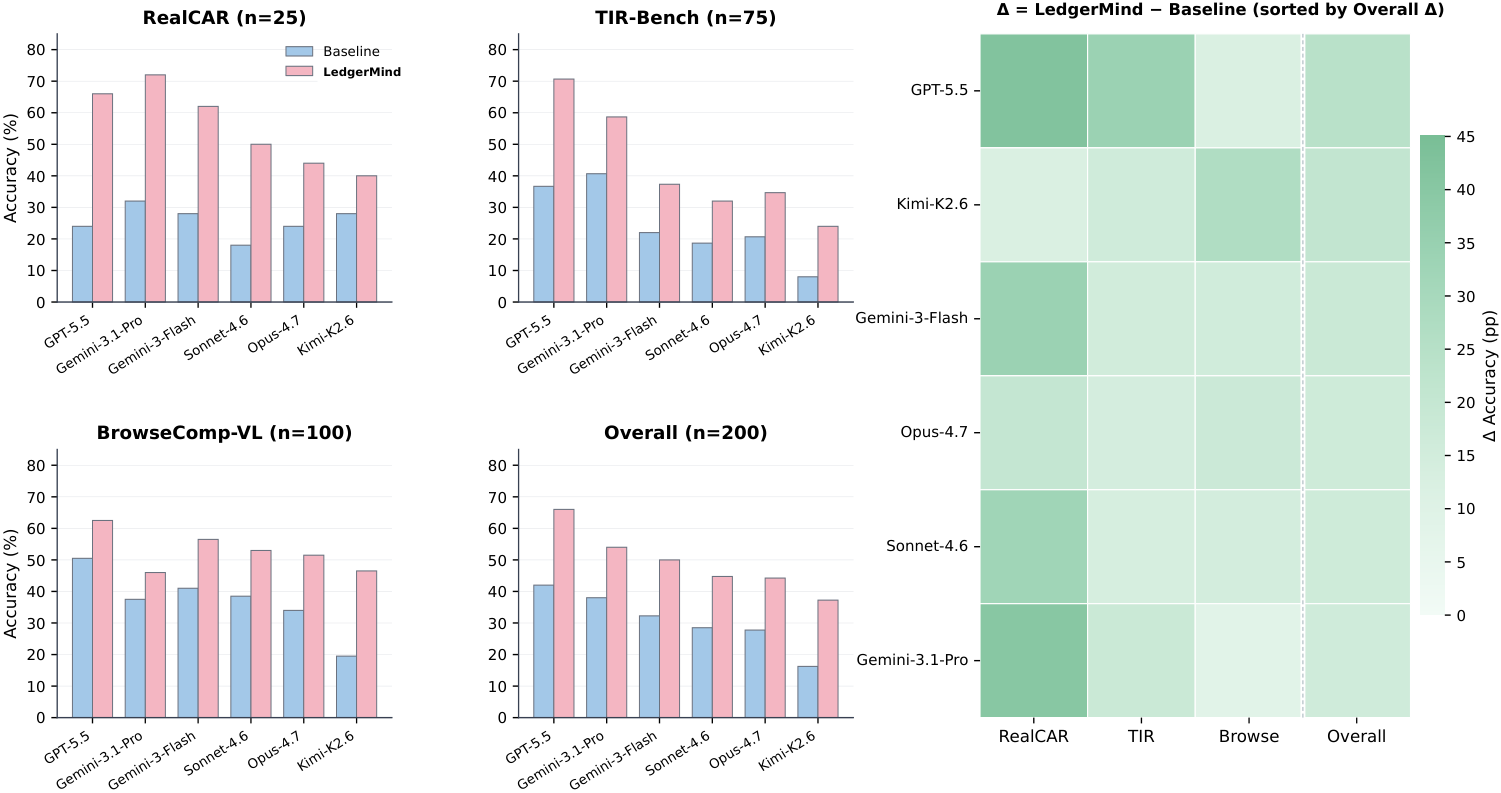
在专为极限压力设计的 Hard-200 评测集上,LedgerMind 对六大主流基座实现了全域正向提升(整体提分在 $+11.2$ 至 $+19.7$ 之间)。从差异热力图中可以看到,没有任何一个模型的任何一个子维度出现负收益。在极考验真实网页细粒度图文定位的 BrowseComp-VL 子集上,Kimi-K2.6 原生得分仅为 $19.5\%$,在接入账本状态机后直接跃升至 $46.0\%$(净增 $+26.5$ 分),实体级校验彻底斩断了虚假生成的退路。
而在强调长程搜索链条对齐的 MC-Search 上,研究人员引入了黄金步骤命中率(HPS)与步骤偏差绝对值(RD)作为核心指标。结果表明,LedgerMind 让 Claude-Opus-4.7 和 GPT-5.5 的 F1 分数突破至 $60\%$ 以上,同时将中间检索链条的步骤偏差(RD)直接砍半(从 $0.89$ 降至 $0.54$)。检索链条对齐度的改善幅度甚至超过了最终答案准确率的提升幅度,这直接证实了一个关键假设:性能的提升不是因为模型碰巧猜中了答案,而是整条推理链路的结构发生了质变。
轨迹忠实度审计:剥除“碰巧答对”的假象
为了从机理上量化这一改变,研究团队提出了一种“对称推理忠实度审计”(Symmetric Reasoning Faithfulness Audit, S-RFA)。通过引入外部判官将推理轨迹拆解为原子断言,针对两个关键的隐蔽失效场景进行度量:一是基于充分证据的正确(Reason-for-Right, R4R);二是看似有证据却答错的假锚定(Wrong with Decision Grounding, WDG)。
审计诊断结果呈现出惊人的一致性:在多款模型的雷达图诊断中,LedgerMind 的闭包完全包裹住了原生基线。伴随决策锚定率(GDR)和 R4R 显著攀升的是,无证据推理率($\mathrm{UCR}_{\mathrm{reason}}$)和虚假锚定率(WDG)均大幅下跌。过去模型常常在答错时煞有介事地引用一堆伪实体(高 WDG),而在 LedgerMind 的约束下,这一顽疾被彻底遏制。
在 MMMU-Pro 上的消融实验更进一步厘清了每个组件的不可替代性:
-
剔除“结构化证据账本”后,模型性能直接暴跌 $15.39$ 分,说明单纯依靠 Prompt 提示模型“引用来源”,根本无法抵御注意力机制的语义漂移;
-
将“类型化修复”替换为传统的“自由文本反思”,整体表现重挫 $8.49$ 分,坐实了自由反思会二次放大错误的结论;
-
剥离实体级 ECC 与数值级 NCC 检查,高难度测试集的得分受损最为严重;
-
若取消双路径分发器、强制所有题目执行深度重型流水线,简单题目的准确率立即出现显著滑坡,直接印证了“过度思考悖论”的破坏力。
总结与启示
长久以来,多模态智能体研究深陷于“黑盒思考”与“终局准确率”的单一度量衡中。只要答案命中标准答案,中间逻辑链条哪怕错漏百出、指鹿为马,也会被掩盖在榜单数字的繁荣之下。
LedgerMind 的价值不仅在于刷新了若干评测集的榜单高点,更在于它向技术社区阐明了一个更具工程严肃性的方向:多模态推理不能完全寄托于大模型的统计自律,必须为智能体外加确定性的状态机框架与不可篡改的证据审计系统。
通过将自由文本降维归一为结构化账本,以实体和数值为死锁阈值,并以类型化算子封死错误的自发生长路径,多模态智能体终于具备了生产级系统所不可或缺的属性——可解释、可归因、可审计。随着多模态大模型加速进入工业巡检、医疗辅助与自动化科研等高风险场景,类似 LedgerMind 这样兼顾灵活性与强确定性状态约束的架构,将成为智能体底层运行时的标准范式。