MiniWorld:单机8卡从零训出流式世界模型,轨迹精度提升249%
MiniWorld: Democratizing the Training of Video World Models from Scratch
在具身智能(Embodied AI)与物理世界模拟的浪潮下,视频世界模型(Video World Model)已经成为大模型前沿最具想象力的赛道之一。不同于只关注像素质感与运镜美感的通用视频生成模型,世界模型的核心任务是在智能体动作、相机位姿等控制信号驱动下,自回归地预测环境的未来演化。它需要理解重力、碰撞、遮挡、透视与因果关联,从而充当智能体训练的数字孪生沙盒。
ArXiv URL:https://arxiv.org/abs/2608.01127
然而,近一段时间的世界模型研究逐渐走向了一条“军备竞赛”式的技术路线:研究者普遍依赖大规模双向视频生成底座(如 Wan 等开源大模型),再通过微调、因果蒸馏(Distillation)或强化学习硬生生将其改造为因果流式预测器。这种后期修补的方案不仅优化流程极其繁复、算力消耗惊人,更关键的是,双向预训练的全向注意力与自回归流式推理的因果性存在底层的结构性失配(Structural Mismatch)。
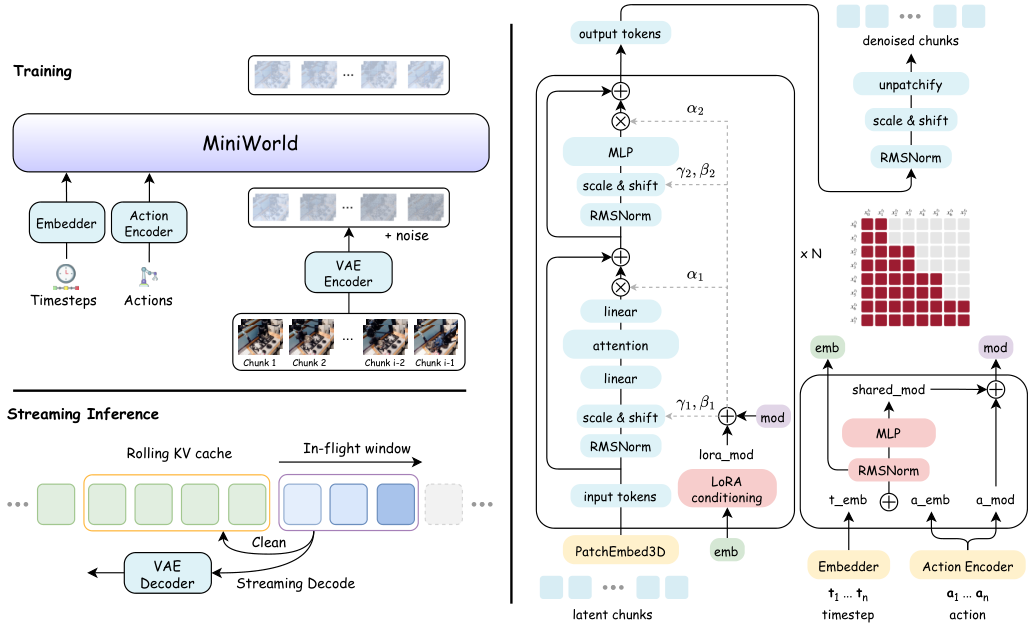
最新开源的 MiniWorld 框架直面这一痛点。它证明了一条被很多人忽视的路径:从零开始(From Scratch)端到端训练流式因果视频世界模型,不仅在理论上更自洽,在算力上也是完全可行的。在单台配备 8 块 GPU 的服务器上,仅需几天时间,MiniWorld 就能从零训练出一个具备极强物理一致性的流式世界模型。在 DROID 机器人控制基准测试中,其轨迹精度相比滑动窗口基线大幅提升 249%,深度精度提升 238%。这套方案为算力受限的研究团队推开了一扇低门槛、全开源的世界模型研究大门。
为什么微调大底模不再是唯一解?
理解 MiniWorld 的出发点,首先要厘清当前世界模型研究面临的范式困境。
现存的主流工作通常选择先拿数以千万计的通用视频去预训练一个扩散模型。这些模型在训练时是双向的(Bidirectional),即第 10 帧的生成可以同时参考第 1 帧和第 20 帧。但在真实的交互式世界模型中,时间轴具有不可逆的因果箭头,环境永远只能基于过去的交互观测 $x_{1:h}$ 与未来的控制动作 $c_{h+1:T}$,去一步步推演未来的状态 $x_{h+1:T}$。
当人们试图将双向扩散模型强行改成因果流式输出时,往往不得不引入复杂的掩码策略或自蒸馏技术。即便如此,模型在面对超长时序自回归推演时,依然极易出现误差累积、物理状态漂移、画面结构崩塌等现象。为了掩盖这些缺陷,团队往往需要投入上百张甚至数千张高端 GPU,构建多阶段后训练管线。这种重资产玩法将绝大多数学术团队与中小型开发者挡在了门外。
MiniWorld 的核心逻辑在于回归本质:与其在双向底座上修修补补,不如从第一天起就以动作条件驱动的下一个状态预测(Action-Conditioned Next-State Prediction)为优化目标,在因果约束下从零训练。
核心机制:块因果 DiT 与扩散强制的巧妙结合
从零训练因果视频生成,最大的挑战在于训练稳定性和时间连贯性。MiniWorld 在系统架构与算法设计上做出了几项关键抉择。
在表示层,模型基于预训练的 Wan2.2 Video VAE 将连续视频投影到潜在空间(Latent Space)。该 VAE 具有 4 倍时间压缩、16 倍空间压缩以及 48 个潜通道。这意味着原始高分辨率视频被压缩成了紧凑的潜在张量,显著减轻了后续骨干网络的显存与计算压力。
在骨干网络上,MiniWorld 采用基于 Flow Matching 的单流块因果视频扩散 Transformer(Block-Causal Video DiT)。Flow Matching(具体采用 Rectified Flow 公式)在潜空间构建样本 $x$ 与高斯噪声 $\epsilon$ 之间的线性插值轨迹:
\[z_{\tau} = (1 - \tau)x + \tau\epsilon, \qquad \tau \in [0, 1]\]模型的预测目标直接拟合速度场 $v_{\theta}(z_{\tau}, \tau, c)$。为了将机器人末端位姿、机械臂动作或连续相机轨迹 $a_t$ 注入系统,MiniWorld 设计了轻量级的调制网络(Modulation):
\[(e_{t}^{a}, m_{t}^{a}) = E_{\mathrm{act}}(a_{t})\] \[M_{\ell}(e) = M_{\mathrm{shared}}(e) + W^{\ell}_{\mathrm{up}} \, \sigma\!\left(W^{\ell}_{\mathrm{down}} e\right)\]通过共享基座网络与每层专有投影层的组合,动作表征以极低的参数增量精确调节 Transformer 各层的注意力机制与自适应归一化层。
而在时序生成机制上,单纯的自回归自注意力容易面临显存爆炸与训练推理不一致。MiniWorld 借鉴了 Diffusion Forcing 的思想,摒弃了传统 Teacher Forcing 必须依赖“完全去噪的上一个块”的严苛假设,为训练序列中的各个时间块分配独立的扩散时间步。
更关键的是,MiniWorld 提出了块级非递减加噪调度(Chunk-wise Non-Decreasing Noise Schedule):
\[\tau_{1} \leq \tau_{2} \leq \cdots \leq \tau_{M}\]在一个由 $M$ 个时间块组成的序列中,越靠近未来的时间块,被赋予的噪声水平 $\tau$ 越高;历史块的噪声水平则更低甚至完全去噪。这种加噪分布天然契合了流式推演的因果规律——历史总是比未来更确定。模型在单次前向传播中,就能学会基于不同确定程度的上下文去预测未来的速度场,从而支持后续推理时的异步多步流水线去噪。
从短到长:两阶段持续训练与时间步偏移
直接在大尺度长时序上训练扩散模型,不仅显存开销难以承受,初期由于随机初始化,长程因果注意力的收敛也会极其缓慢。MiniWorld 采用了一种优雅的两阶段持续训练(Two-stage Continued Training)策略:
第一阶段为预训练,视频长度限制在 21 或 46 帧。该阶段让模型在极低的算力开销下,快速掌握局部的几何结构、物理规律以及动作与像素运动之间的局部对应关系。
第二阶段为长时序持续训练,将视频序列扩展到 125 甚至 253 帧。在这一阶段,模型架构与优化目标保持不变,仅仅是输入的时间跨度和动作轨迹更长。为了匹配长程建模中更复杂的潜空间概率分布,MiniWorld 引入了时间步偏移(Timestep Shifting):
\[\tilde{\tau} = \frac{s\tau}{1 + (s - 1)\tau}\]其中 $s$ 为偏移因子。这一操作重塑了扩散时间步的采样密度,迫使模型在长序列优化中将计算重心放在信噪比较低的关键去噪区间。这种两阶段渐进式设计,正是 MiniWorld 能够在单台 8 卡服务器上几天内完成端到端收敛的关键工程诀窍。
推理引擎:有界显存下的滚动 KV 缓存与异步流水线
在实际部署中,世界模型不仅要推演得准,还要推演得久、推演得快。无限增长的时序推理通常会瞬间击穿显存,而传统的逐步串行去噪又会导致难以接受的交互延迟。MiniWorld 在推理引擎设计上提出了两项关键优化:
-
滚动 KV 缓存(Rolling KV Cache):将生成序列明确划分为“已固化的历史流”与“活跃的去噪窗口”。当某个未来时间块完全去噪收敛后,立即作为永久历史写入 KV Cache;而超出预设时间视野的更早历史,则从活跃注意力池中滚动移出或进行紧凑压缩。这使得自回归推理过程中的显存占用被严格锁死在一个常数上限内。
-
流水线异步去噪(Pipelined Asynchronous Denoising):得益于训练时采用的非递减扩散加噪策略,不同时间块的去噪进度允许存在错位。推理引擎可以在对第 $m$ 块进行最后微调去噪的同时,提前启动对第 $m+1$ 块的大步长去噪。这种并行管线允许用户在生成吞吐量(FPS)与去噪保真度之间自由滑动,在固定算力预算下榨干硬件并发能力。
实验评测:动作交互与场景漫游的双重验证
为了验证这套轻量级从零训练框架的成色,作者在两个具有代表性且控制模态截然不同的基准上进行了深度评测:机器人操控基准 DROID(输入为高维底层机械臂动作)以及大规模室内场景基准 RealEstate10K (RE10K)(输入为连续相机位姿轨迹)。所有评估均以单一观测帧为起点,自回归推演 253 帧的超长长程视频。
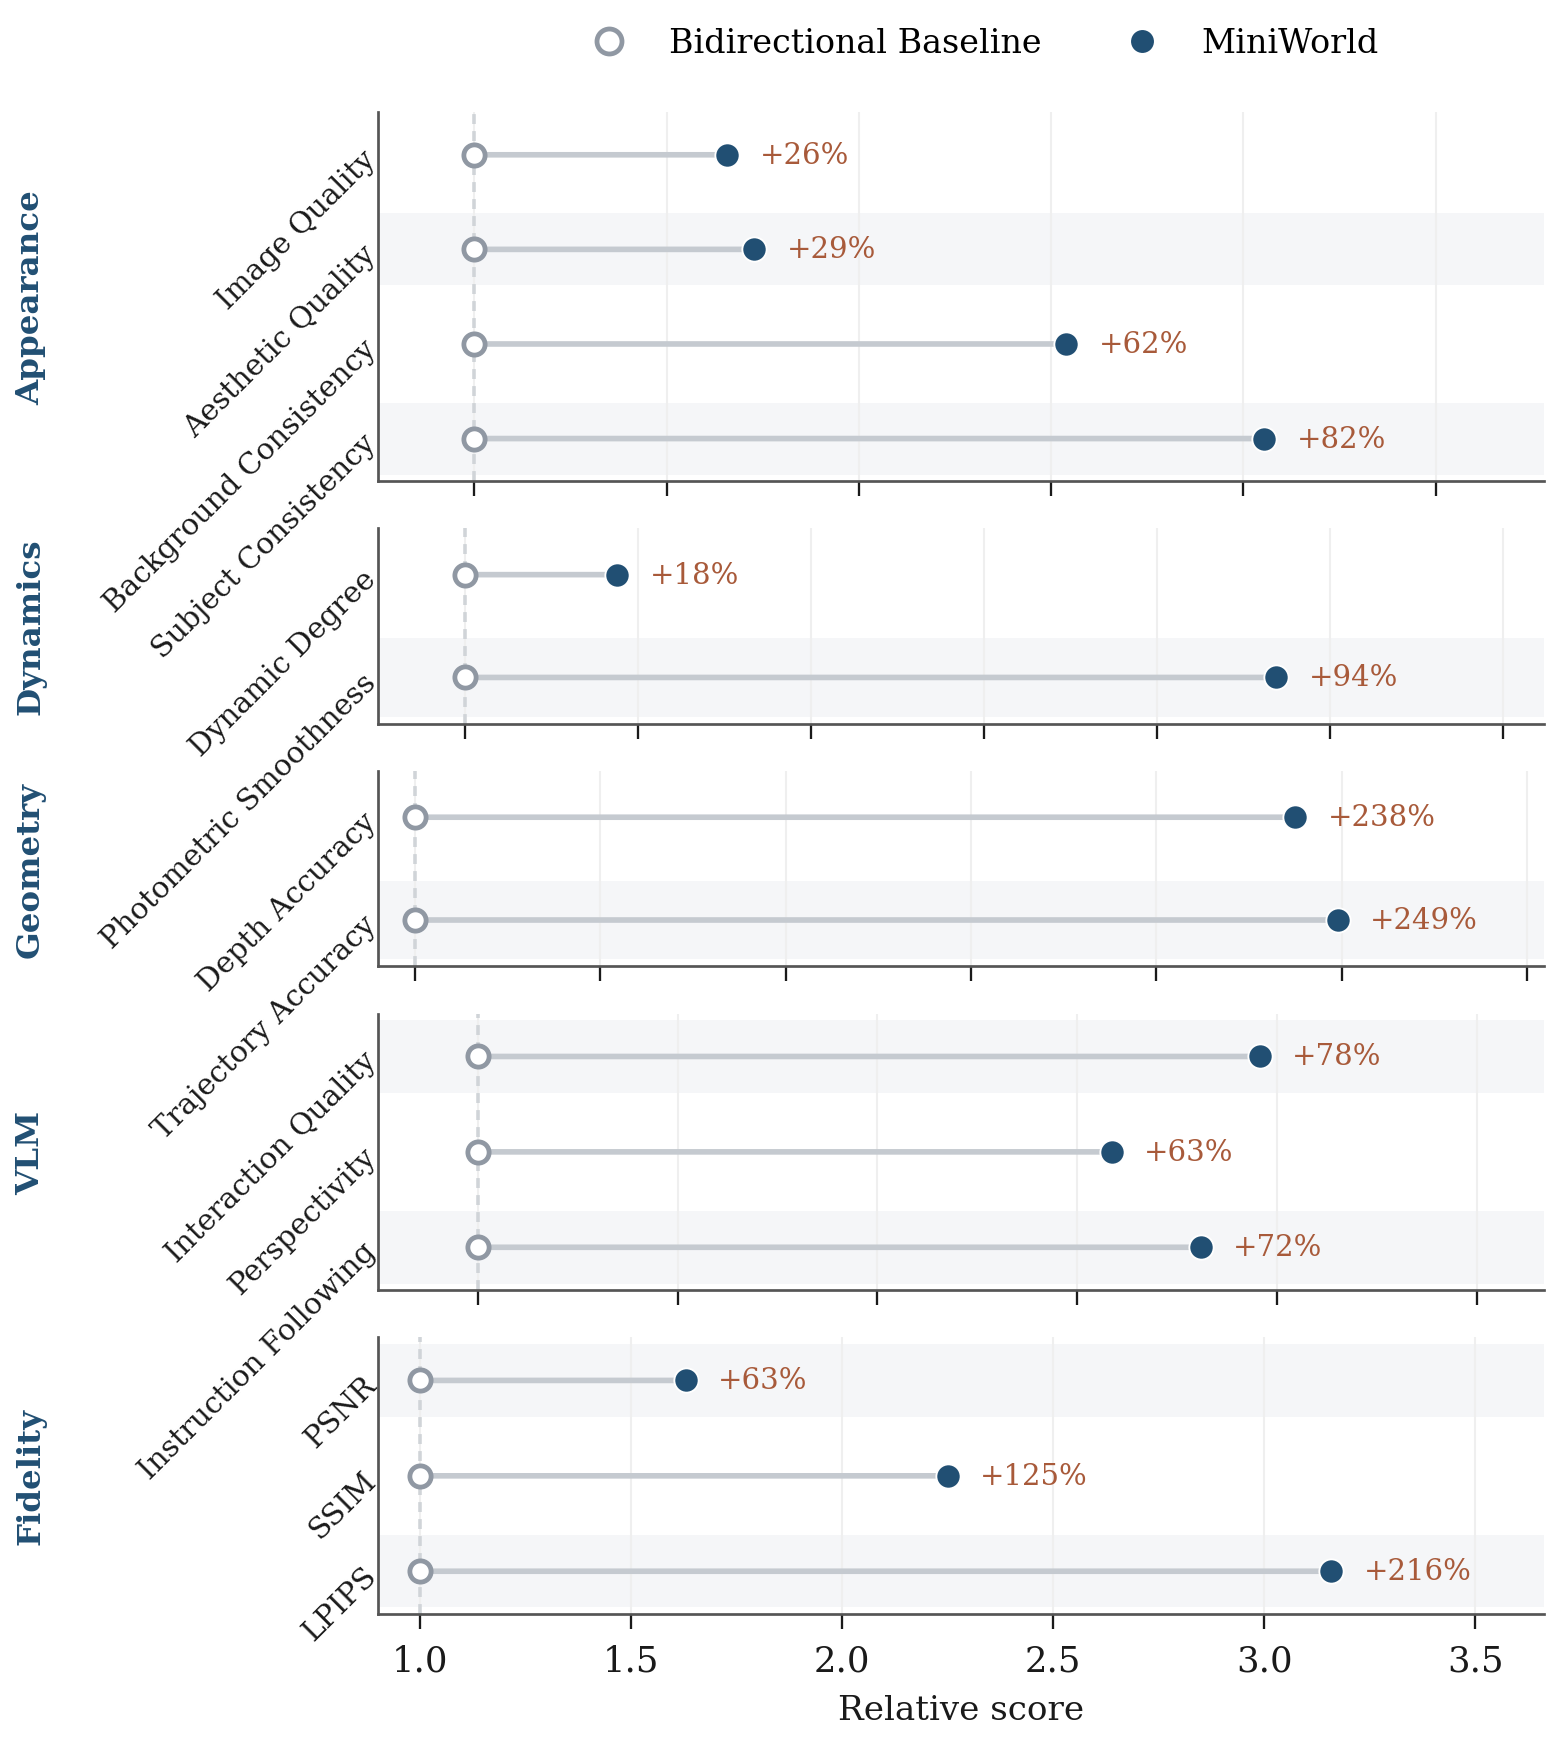
在以机器人机械臂控制为核心的 DROID 基准上,MiniWorld 与滑动窗口双向基线相比展现出了压倒性的优势。上图清晰展示了各维度的相对增益:
-
几何与物理指标呈现质的飞跃:轨迹精度(Trajectory Accuracy)提升高达 249%,深度精度(Depth Accuracy)提升 238%。在传统短窗口方案中,机械臂在自回归执行复杂抓取时经常出现肢体形变、关节断裂或轨迹偏离目标的问题,而 MiniWorld 牢牢锁住了机械臂的几何刚体运动规律。
-
时序与感知质量全面胜出:LPIPS 改善 216%,SSIM 提高 125%,动态保真度指标全面上涨 26% 至 82%。由多模态大模型担任的 VLM Judge 评估打分也提升了 63% 到 78%,表明生成的交互过程在常识逻辑上高度合理。
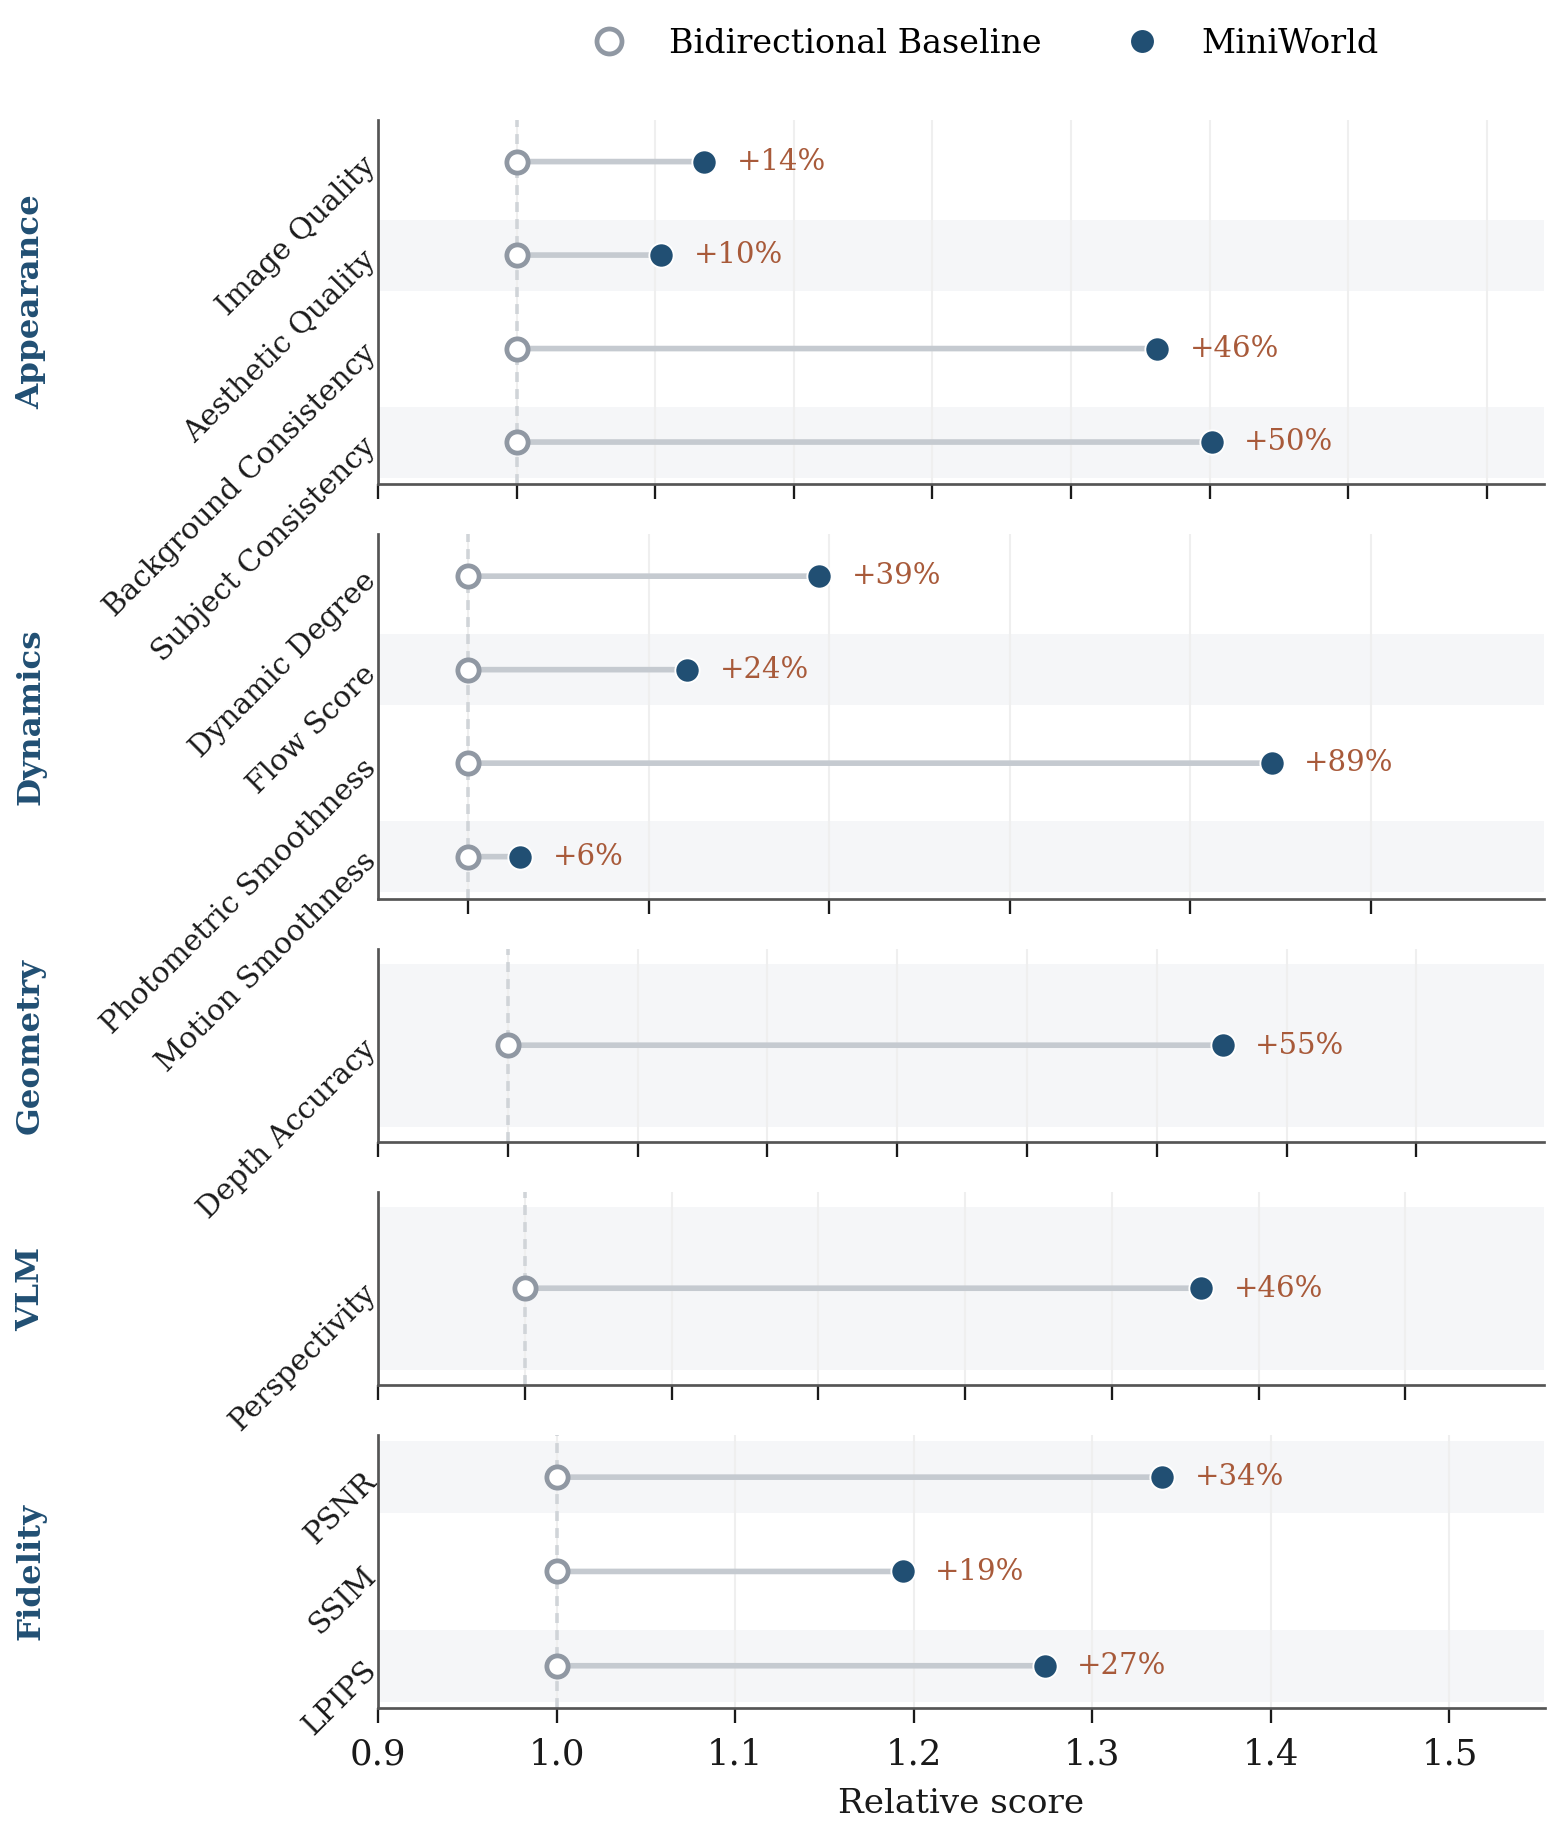
如果说 DROID 验证了局部动作交互的物理因果,RE10K 则检验了宏观 3D 几何与透视一致性。在 RE10K 上,虽然提升幅度相比机械臂操纵更为平缓,但依然体现了全方位的领先:光度平滑度(Photometric Smoothness)提升 89%,深度精度提升 55%,主体与背景一致性分别提升 50% 和 46%,透视感(Perspectivity)提升 46%。
这一跨领域评测极具说服力。它证明了这套基于块因果与 Flow Matching 的架构并不依赖特定数据集的统计捷径,无论是操控交互还是大视场相机飞掠,它都能稳定捕捉底层的 3D 空间结构与动态规律。
模型缩放与消融细节:确定性收益来自何处?
在模型规模上,团队构建了统一参数体系,涵盖 0.5B、1B 到 3B。测试表明,该架构展现出了极佳的模型缩放定律(Scaling Law)。
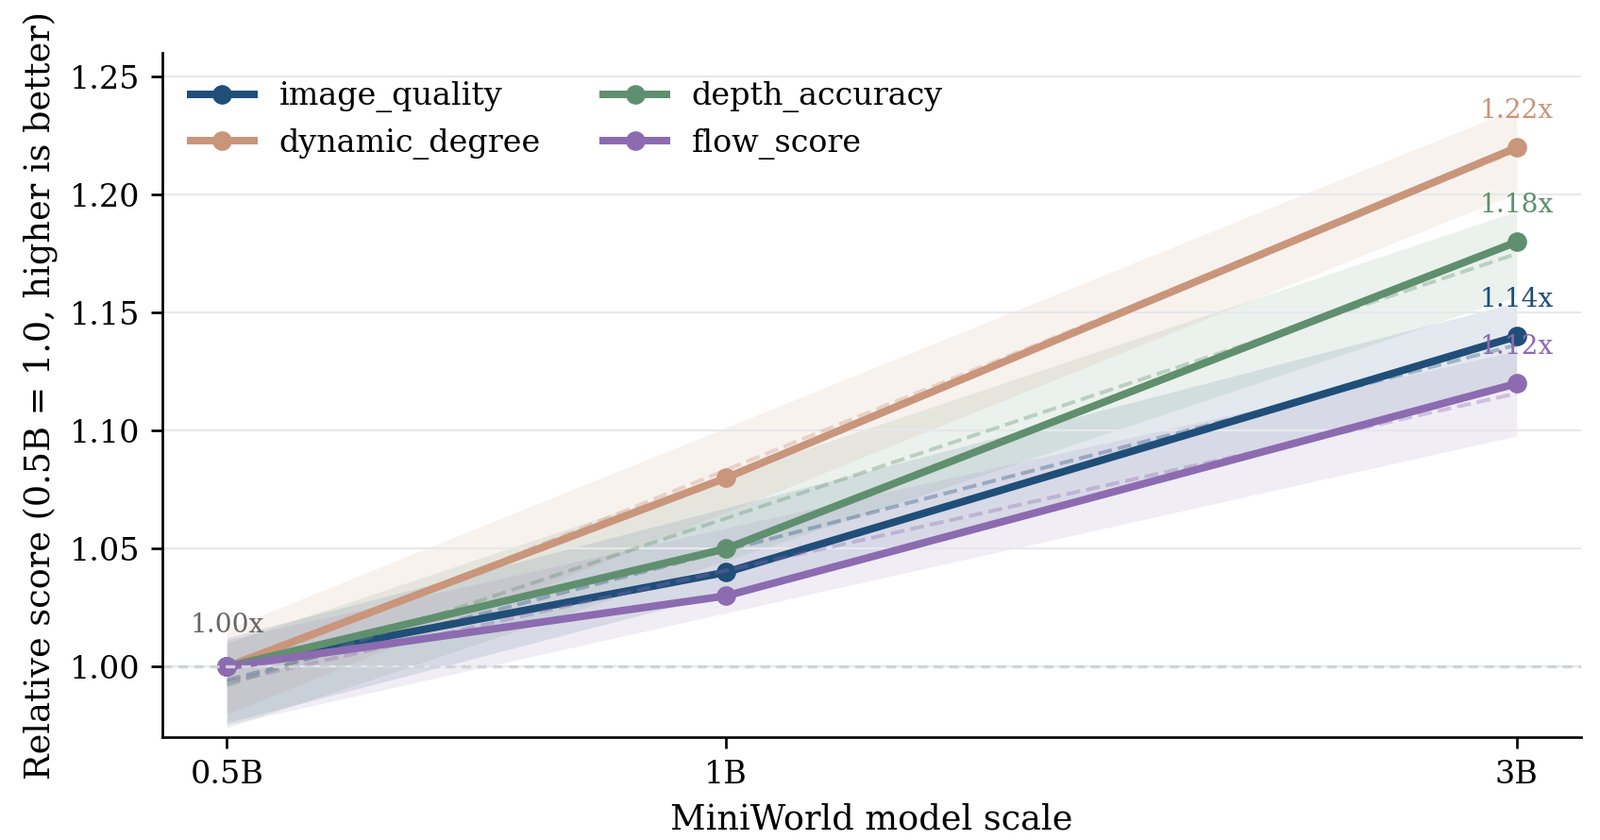
从上图可以看出,随着参数量从 0.5B 扩大到 3B,图像质量、动态程度(Dynamic Degree)、深度精度和光流评分(Flow Score)均呈现严格的单调递增。在 3B 规模下,动态程度相比 0.5B 提升 22%,深度精度提升 18%。这种收益模式表明,更大的模型容量主要被用于强化时空运动建模与三维一致性理解,而不是简单地给静态画面增加无关的纹理细节。
此外,针对推理阶段各模块的消融实验(如下图所示)进一步解构了生成质量的来源:
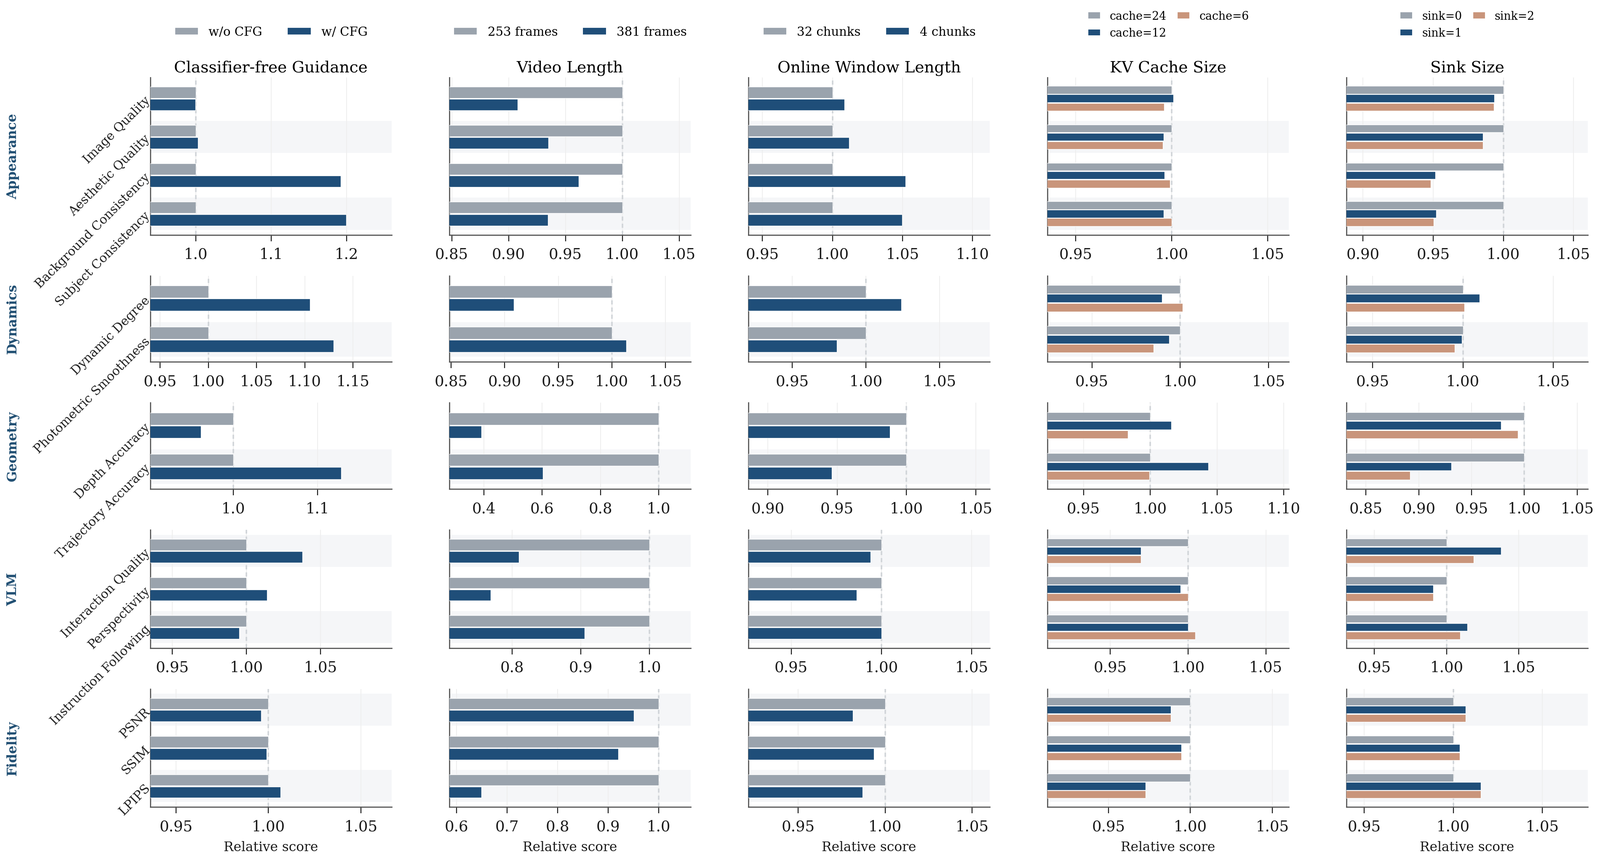
无分类器引导(CFG)的尺度设置对控制信号的遵从度至关重要;而两阶段长时序持续训练,则是抑制自回归后期漂移的定海神针。如果缺乏第二阶段的长程上下文暴露,模型在推演几十帧后便会迅速失去对初始物理环境的记忆。
启示:开源世界模型的新起点
长期以来,AI 社区在世界模型方向上存在着某种无形的“算力壁垒”,许多研究者默认训练交互式物理世界模型必须以万卡集群和闭源专有数据为前提。MiniWorld 的核心价值正在于祛魅。
它通过严谨的因果任务对齐、巧妙的噪声调度设计、渐进式的长度训练策略,以及硬件友好的流式缓存机制,将世界模型的端到端研发门槛拉回到了普通高校和初创团队可以企及的工业界主流单机 8 卡节点。更重要的是,作者将数据预处理、模型架构、训练代码、推理引擎及评测体系全盘开源,提供了一个透明、轻量且具备扩展性的实验基准。
世界模型的终局远未到来。如何引入长程记忆机制(Memory Mechanisms)、如何泛化至更具多样性的未知动作空间、如何将更复杂的物理碰撞规律融入隐空间,依然存在大量待解难题。MiniWorld 的出现,为社区提供了一个无需承担庞大工程包袱、可以快速验证新构想的技术跳板。世界模型的研发,正在真正走向平民化。