多智能体辩论MAD最新系统综述!三维框架解构141项核心研究
Multi-Agent Debate Strategies: Survey, Taxonomy, and Challenges
单模型依靠思维链(Chain-of-Thought)或自洽性采样(Self-Consistency)来提升推理能力,正在逼近边际效益的拐点。随着大语言模型(LLM)被广泛封装为能够自主规划、调用工具的 Agent,研究界自然衍生出一个朴素却极具吸引力的构想:能否模仿人类社会的陪审团或圆桌会议,让多个 Agent 在同一任务中各抒己见、相互质询甚至激烈辩论,从而纠正单体的幻觉与逻辑漏洞?这一范式被称为多智能体辩论(Multi-Agent Debate, MAD)。
ArXiv URL:https://arxiv.org/abs/2607.26212v1
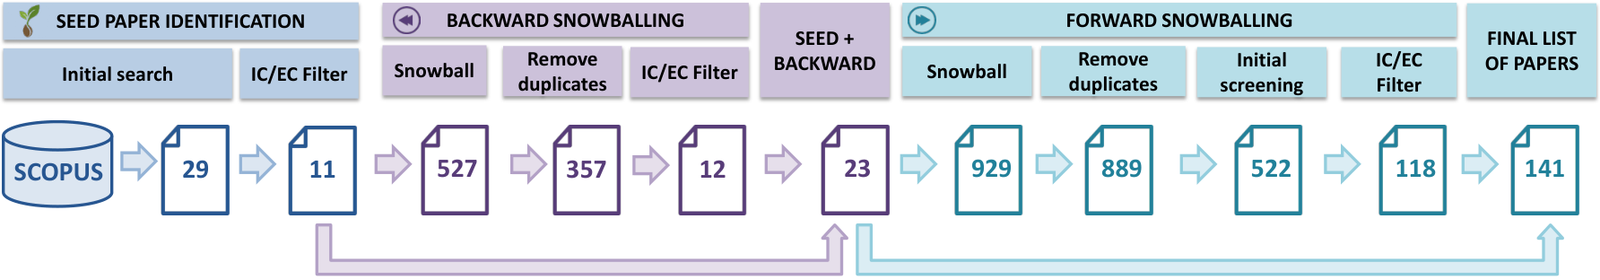
然而,繁荣的背后隐藏着系统性脱节。过去两年中,涌现出大量以“辩论破局”为卖点的论文,但各研究团队术语不一、框架随意,很多系统看似性能拔群,实则是把十多个未经消融的架构参数打包在一起的黑盒效应。来自加泰罗尼亚理工大学(UPC)的研究团队遵循 ACM SIGSOFT 实证标准,对该领域的 141 篇核心论文(涵盖 151 种系统实现方案)展开了严格的系统综述。
这项工作最犀利的洞察在于揭示了一个行业惯性:当前的 MAD 研究高度收敛于一套狭隘的“默认套路”——静态全连接拓扑、逐字原始信息交换、同质化闭源模型(主要是 GPT 家族)、短期滑动窗口记忆以及简单的多数投票表决。这种收敛并不是经过充分实验对比后的最优选择,而仅仅是开发者们心照不宣的路径依赖;与此同时,更具扩展潜力的动态拓扑、信息压缩与元协调机制,反倒长期处于边缘地位。
从经验堆砌到三维设计空间
多智能体辩论之所以能够超越单体自纠错(Self-Correction),核心在于利用“认知分布式”对抗大模型的固有偏见与盲目自信。单模型在自我反思时,往往受制于预训练权重带来的特定先验,容易在错误的逻辑链条上反复验证自身的正确性;而在多 Agent 交互中,引入对抗性或互补性的视角能够物理阻断这种逻辑闭环。然而,当辩论环境从概念演示走向工程落地时,开发者必须明确回答一系列结构性问题:究竟需要几个 Agent?它们应该拥有独立的预设背景还是共享统一指令?它们是通过黑板机制广播还是点对点私信?辩论何时终止,又由谁来敲定最终答案?
为了终结各自为战的术语混乱,作者梳理出了涵盖 MAD 系统的三维分类体系(Taxonomy),将复杂的辩论架构解构为三个正交的维度:参与者(Participants)、交互机制(Interaction)与共识协议(Agreement)。
在三维空间建立之前,不同文献之间的实验结论几乎无法横向比较。比如某篇论文声称三轮辩论在数学推理上提升了 8%,另一篇论文却发现辩论导致了答案质量恶化。如果缺乏统一的设计规范,读者根本无从知晓这种差异究竟源自 Agent 的底座模型差异、人设提示词的软约束,还是因为信息交互时采用了全量拼接导致的长上下文灾难。三维框架的价值,正在于把过去模糊的“辩论效果”拆分为可严密控制自变量的工程要素。
参与者维度:同质内卷与人设的虚假繁荣
参与者维度的核心研究问题,在于辩论各方是由什么构成的,以及它们如何确立自身的思维定势。作者从人设(Persona)、功能角色(Role)和底座模型(Base Model)三个层次剖析了当前的研究现状。
首先是底座模型的选取。统计显示,高达 81.5% 的系统选择让所有辩论 Agent 共享同一个基座模型,其中 GPT 家族占据了 78.1% 的压倒性比例;开源模型如 Llama(40.4%)和 Qwen(18.5%)虽在上升,但通常也只是作为单次实验的统一底模。这意味着绝大多数所谓的“多智能体辩论”,本质上是同一个模型参数分布在不同温度采样下的“左右互搏”。当基础模型本身存在特定的事实性硬伤或归纳偏见时,多个同质 Agent 极易陷入集体谄媚(Sycophancy)或群聚盲从,最终把错误答案“辩成真理”。异构模型组合——例如让推理能力强但缺乏敏锐度的模型与擅长挑刺的小参数开源模型同台辩论——被证明具有更高的互补价值,但在现有研究中仅占 27.8%。
其次是人设维度的虚实。既然底模高度同质,研究者便普遍转向通过 Prompt 注入人设。调研显示,53.6% 的系统采用了异构人设,试图模拟不同专家或不同性格的个体。然而,作者明确指出,目前赋予 Agent “性格特质”(如顽固、多疑、自信)的尝试大多停留在定性描述阶段,其对逻辑收敛的影响极不稳定;相比之下,立场(Stance)的硬性指派是一种更成熟、更具控制力的对抗机制。无论是天使与魔鬼(Angel vs. Devil)的批判设定,还是法庭控辩双方(Prosecution vs. Defense)的强制二元对立,抑或是强制指定某一方必须为干扰项(Distractor)辩护,这种显式的对抗边界能强行迫使 Agent 跳出预设思维定势,输出高质量的反驳证据。
最后是功能角色的演化。辩论系统不再单纯由“平铺直叙的辩手”组成,研究界正在大规模引入裁判(Judge)、总结者(Summarizer)和主持人(Moderator)等具备元协调功能的专用角色。这些角色不参与一线对抗,而是专注于压缩信息、维持议程与裁定分歧。这一转变标志着多智能体系统从原始的“去中心化自由辩论”,向“分层式治理结构”发生根本性范式跃迁。
交互维度:通信拓扑与记忆膨胀的工程代价
当 Agent 阵列部署完毕后,信息如何流转便决定了辩论的计算效率与逻辑密度。交互维度主要由通信拓扑(Topology)、流转协议(Protocol)与信息格式(Format)构成。
在拓扑结构上,现有文献表现出了极其严重的惯性依赖。绝大多数研究默认采用静态全连接图,即所有 Agent 在每一轮都能看到其他所有参与者上一轮的完整发言。在早期仅有 2 到 3 个 Agent、辩论 2 到 3 轮的玩具级实验中,这种设计尚可支撑。但在稍微复杂的工程场景下,全连接广播会导致上下文窗口呈平方级膨胀,随之而来的是高昂的 Token 费用以及模型对长文本注意力发散导致的“迷失在中间”(Lost in the Middle)现象。更优的替代方案,如基于聚类的动态子群讨论、稀疏有向图拓扑或按需路由的分级交互,在 141 篇文献中鲜少被深入探索。
信息交互的格式设计同样暴露出粗糙的工程现实。统计表明,大多数系统采用非结构化的“逐字转发”(Verbatim Exchange),即将对方的完整回复原封不动地塞入当前 Agent 的 Prompt 中。这种做法剥夺了 Agent 对关键论据的提炼空间,造成了大量的语料冗余。尽管已有少数前沿系统开始探索结构化论据建模(如显式分离前提、证据、论证过程与反驳点),甚至采用外部知识库作为辩论的“共享黑板”,但主流实践仍受困于短期记忆的滑动窗口机制。这种依赖工作内存的简单交互,使得辩论深度极难向下延伸,往往在三轮之后,辩手们就开始陷入低水平的话术重复,而非论据的层层递进。
共识协议维度:过早收敛与裁决悖论
辩论的终点是产出确定的决策或内容,共识协议正是规范辩论何时停止以及如何敲定终局结果的机制。如果缺乏科学的共识机制,多智能体辩论很容易退化为无休止的唇枪舌剑,或者在第一轮就因为某一方的退让而迅速过早收敛(Premature Convergence)。
在决策解析机制(Resolution Mechanism)上,学术界主要分流为两大派系:多数投票制与独立裁判制。多数投票制简单直观,依赖集体智慧的众包效应,但其致命弱点在于把“逻辑辩论”偷换成了“概率加权”;一旦多数 Agent 产生了系统性幻觉,投票只会加速错误的固化。独立裁判制则依赖一个更强大的独立 LLM 实例(或预设的评委团)来审查辩论轨迹并给出终裁。然而,这也引出了一项悬而未决的“裁决悖论”:如果裁判 LLM 本身具备甄别复杂逻辑是非的超强能力,为什么不一开始就直接由该模型单体推理,反而要耗费数倍的 Token 成本去生成一段冗长的辩论过程?
调研揭示,真正让裁判发挥超常效能的关键,在于“生成困难但验证容易”的任务属性。在代码生成、复杂定理证明或医疗事实核查等领域,生成全局最优解对单体模型极具挑战,但辩论过程会迫使对立双方把各自推理路径中的边缘条件、潜在漏洞和隐藏假设彻底摊开。辩手 Agent 的博弈,实际上是在为后方的裁判 Agent 充当自动化的“推理剪枝器”与“证据提取器”。对于终止协议,大多数系统依然僵硬地锁定在预设的固定轮数(通常为 2 至 3 轮),仅有极少数先进系统配备了动态停机准则,能够基于论据熵值、共识距离或置信度跃迁来判定辩论是否应当提前熔断,从而避免算力的无效空转。
为什么当前大部分 MAD 评估不可轻信?
作者在全景梳理之后,对当前多智能体辩论评测的严谨性提出了极为尖锐的质疑。根据这篇系统综述的统计,辩论在数学推理、常识问答和代码补全等具有客观真实标签(Ground Truth)的任务中,确实表现出了相对稳定的性能增益;然而一旦踏入法律推演、开放式长文本评估、安全风险对齐或多轮协商等非确定性领域,辩论带来的所谓“质量飞跃”就变得非常脆弱。
造成这一现象的深层原因在于,学术界长期依赖 LLM-as-a-Judge 来评价 LLM 的辩论成果。当一套由大模型驱动的裁判机制去给大模型辩手评分时,评测指标极其容易被辩论中展现出的“语言伪装”所欺骗。例如,Agent 在辩论后生成的回复往往篇幅更长、论据结构更工整、修辞语气更笃定,而裁判模型天然存在“长度偏见”(Verbosity Bias)与“权威偏见”(Authority Bias)。大量被论文宣称为“辩论带来的推理跃迁”,剥开外衣后,往往只是长上下文带来的表达丰富度提升,核心事实并未得到本质纠偏。
此外,绝大多数 MAD 论文在报告基准测试时,未能将多智能体辩论与计算预算相当的单模型增强技术进行严肃对齐。当一个由 4 个 Agent 辩论 3 轮的系统宣称打败了单次调用的 GPT-4 时,这在方法论上是不平等的。如果将等额的 Token 预算投喂给单模型的自洽性采样(如 Sampling 20 次取多数投票)、思维树(Tree of Thoughts)广度搜索或细粒度自我纠错,MAD 是否依然具备统计学上的显著优势?从现有 primary studies 来看,极少有团队给出令人信服的、严格受控的等成本消融实验。这种隐式的多 Agent 预算红利,在很大程度上掩盖了辩论机制本身的结构性缺陷。
未来图景:从静态脚手架到可执行的辩论规范
加泰罗尼亚理工大学这项研究的落脚点,并没有停留在批评层面,而是为下一代多智能体协同系统的工程化指明了演进路径。
首要的任务是让辩论设计从“隐式玄学”走向“显式规范”。鉴于一次 MAD 流程涉及多达十余个关键超参数(从人设初始化、动态拓扑控制、信息过滤语法到置信度熔断阈值),作者提议将这套三维分类法进一步升格为一种机器可读、可版本控制的声明式执行规范(Executable Specification)。未来开发者在部署辩论系统时,不应再用数百行缠绕不清的 Python 代码胶水拼凑 Prompt,而是应当通过标准化的 Schema 文件来解耦定义通信图、辩手背景分布与仲裁准则。只有在设计空间被严格显式化后,科学的跨系统基准对齐才成为可能。
更具实用价值的突破点在于成本感知(Cost-Aware)的动态自适应辩论。在真实工业界场景下,推理成本是多智能体落地的第一红线。未来的 MAD 系统不应继续沿用“杀鸡用牛刀”的全连接静态轮数模式,而必须具备动态自适应能力:面对简单查询,单 Agent 快速通行;遭遇争议或置信度塌陷时,自适应触发对抗辩论;在辩论推进中,引入轻量级模型实时监测论点分歧度,一旦收敛立即熔断。此外,让路由器根据任务类型动态指派异构的模型梯队(小模型挑错、大模型辩驳、专用领域模型裁判),将是打破当前同质化内卷、将多智能体辩论推向规模化产业应用的最关键工程底座。